OS-3.1 内存
3.1 内存
一.内存的基础知识

内存有什么用?
==程序从硬盘调入内存,在内存中被CPU处理。==
==如何区分内存中的多个程序放置的位置呢? →需要对内存进行编址。==

从写程序 到 程序运行(4)
① 编写源代码 –→
② 编译(高级语言(高级代码)到机器语言(机器指令)–→
③ 链接(把code连接到一起,加上库函数,且==形成逻辑地址==)–→
④ 装入(装入内存,==形成物理地址==)

链接的三种方式(3)
- 静态链接:程序运行前一次性链接,之后不拆开。
- 装入时动态链接:边装入内存边链接。
- 运行时动态链接:程序运行时才链接。(便于修改和更新,便于实现对目标模块的共享)

机器指令的工作原理
结构:操作码+若干参数(可能包含地址参数)
指令告诉CPU从哪个地址读/写数据。
或者告诉CPU对数据进行什么处理。

物理地址 VS 逻辑地址
程序经过编译、链接后生成的指令中指明的地址是逻辑地址。

逻辑地址→物理地址【3种装入方式】⭐
(代码中的)逻辑地址→(内存中的)物理地址
==绝对装入==
==可重定位装入(静态重定位)==
==动态运行时装入(动态重定位)==
① 绝对装入:
编程阶段就把物理地址计算好。
只适用于单道程序环境。(灵活性低,不可迁移)

② 静态重定位:
==在装入时 一次完成 逻辑地址转为物理地址。==
进程装入内存时,分配进程要求的全部连续地址空间。
==进程一旦进入内存,就不可以移动位置了。==

③ 动态重定位:
**系统 ==只有一个== **==重定位寄存器==,保存存入该模块存放的==(物理)==起始位置(又叫==基址寄存器==)。
【==物理地址== = 重定位寄存器的值+逻辑地址,==这一步就是硬件地址变化机构做的==】
==在程序真正要执行的时候才进行==,逻辑地址转物理地址。
只装入部分代码,根据需要动态调入调出内存。
允许程序在内存中发生移动。

Note:还有一个叫 可重定位装入程序 的东西。
回顾

二.==内存==管理的概念⭐
OS负责:
① 对内存空间的==分配与回收==(==连续分配和非连续分配方式==)
② 对内存空间的==扩展==(覆盖,交换和==虚拟内存技术==)
③ 提供==地址转换功能==,程序的逻辑地址与物理地址之间的转换。(==三种装入方式==)
④ 提供==内存保护==功能。(==保证各自进程==在自己的空间运行,==不会越界访问==)
①:CPU中的上下限寄存器,进行越界检查
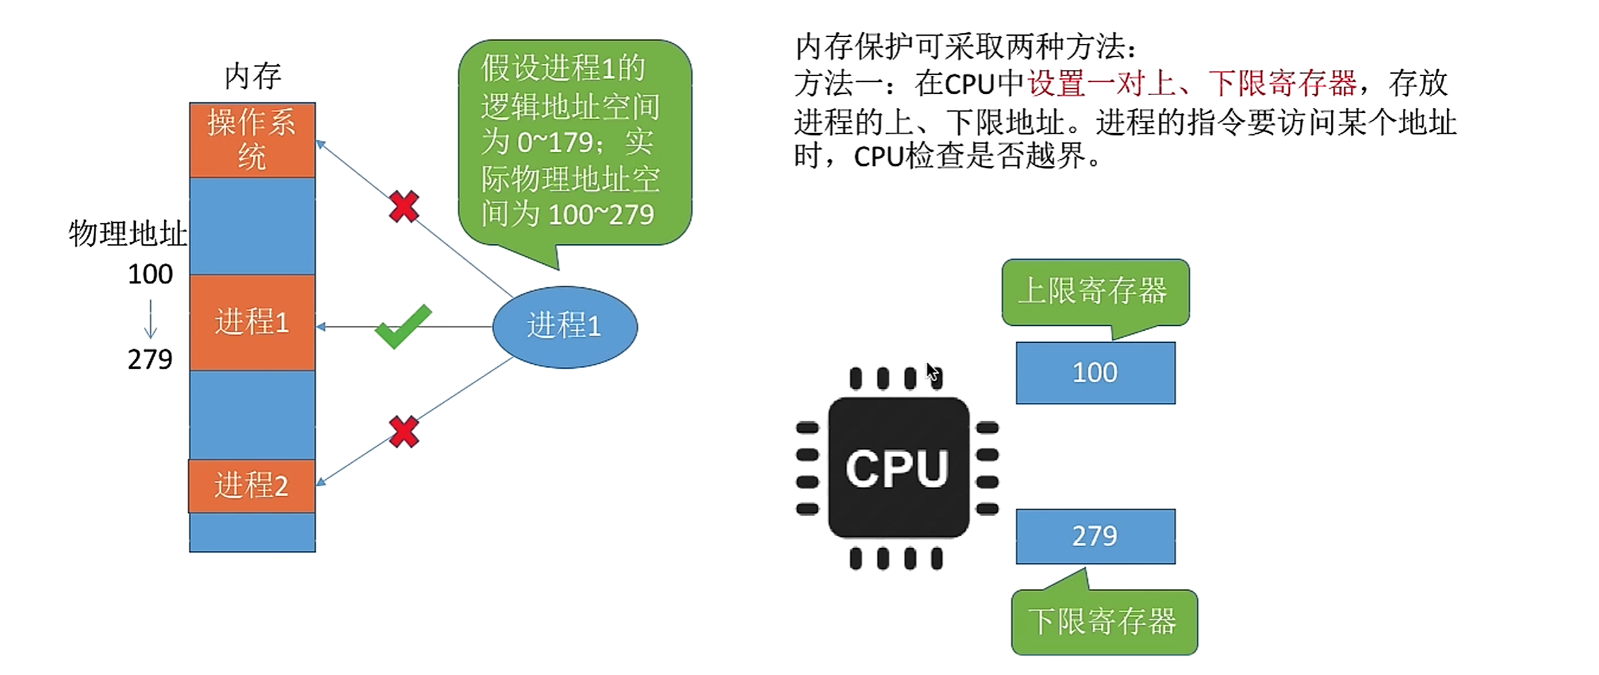
②:重定位寄存器和界地址寄存器进行越界检查
重定位寄存器存放的是进程的起始物理地址。
界地址寄存器保存进程的最大逻辑地址。
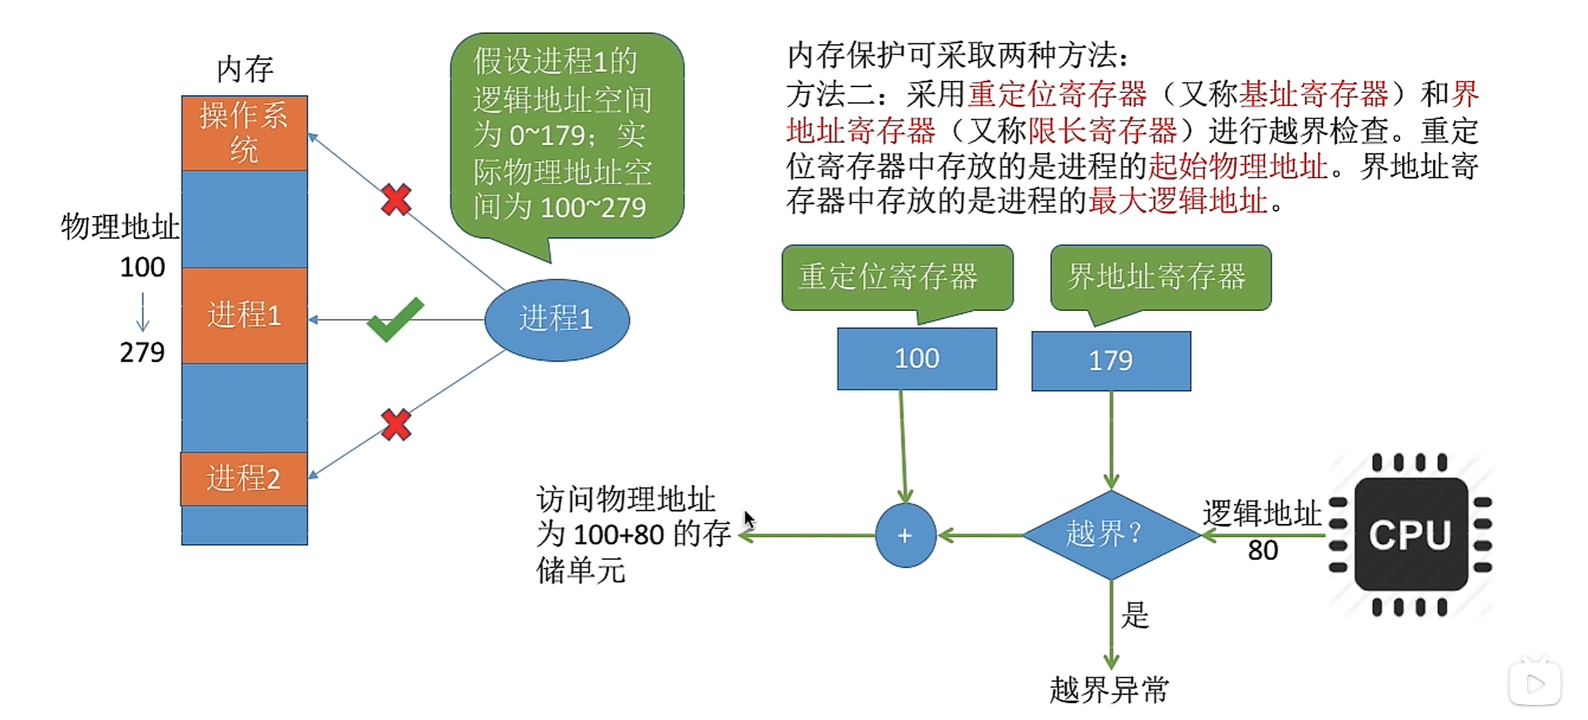
- Note:内存保护由OS和硬件一起完成,硬件主要进行安全性的设置。

回顾

三.进程的内存映像
进程的都是虚址。(eg malloc分配的)


②内存扩展 – 覆盖,交换,虚存
覆盖技术
交换技术
虚拟存储技术(之后学到)
覆盖技术
把程序分成多个段。
==把内存分为一个固定区和多个覆盖区==
常用的段放在固定区,调入之后不再调出。
不常用的段放在覆盖区,需要时调入内存,不需要时调出内存。
必须由程序员实现,==对用户不透明,增加编程负担。==

交换技术
==进程在内存和磁盘之间动态调度。==
when内存空间紧张时,系统将内存中的某些进程暂时调出外存,把外存中已具备条件的进程换入内存。
- Note:==中级调度==,就是决定把哪一个处于挂起状态的进程重新调入内存。

回顾
**==覆盖==**,是在==同一个进程或程序中==进行的。
**==交换==**,是在==不同进程(或作业)之间的==。

①内存空间的分配 – 连续分配管理方式
连续分配:==系统给进程分配的==必须==是一个连续的内存空间==。
==分区存储管理==,比分页分段等存储管理实现简单。(不需要特定的数据结构如页表段表)
- 单一连续分配
- 固定分区分配
- 动态分区分配
连续分配的缺点是:内部碎片和外部碎片都有。
A.单一连续分配
==内存被分为系统区和用户区。==
==内存中只能有一道用户程序==,即用户程序独占整个用户区。
缺点:有内部碎片。且只能用于单用户、单任务的操作系统。

B.固定分区分配
==内存分为多个分区。==(分区大小可以相等,可以不等)
- (OS需要建立一个==分区说明表==)
==每一个分区只能装入一道程序==,【故无法实现多个进程共享同一个内存区域】
缺点:有内部碎片。


C.动态分区分配
==不会预先划分内存区==,(在进程装入内存==时==),==根据进程大小建立合适的分区。==
- 1.OS建立一个空闲分区表或者空闲分区链。
- 2.OS用动态分区分配算法(选择某一个分区进行分配)。
- 3.相邻的空闲分区合并。
没有内部碎片,==有外部碎片。==
- 外部碎片:内存中某些内存分区太小难以利用。
- 解决外部碎片:紧凑技术。(挪移拼接)

1.建立空闲分区表或者空闲分区链

2.用动态分区分配算法(之后介绍)
3.两个相邻的空闲分区合并。

回顾

C.动态分区分配算法(4+3)
- ==基于顺序搜索的分配算法:== 首次适应,最佳适应,最坏适应,邻近适应算法
- ==基于索引搜索的算法:== 快速适应, 伙伴系统,哈希算法。

a.基于顺序搜索的分配算法
首次适应:==按低地址开始寻找==(在空闲分区表/分区链找到第一个大小满足的空闲分区)
邻近适应:每次分配内存**==从上次结束位置==**开始查找空闲分区表/链。(空闲分区以地址递增的顺序排列(可以是循环链表)
最佳适应:优先==使用更小的空闲分区==。(把空闲分区按大小递增链接,如果有删去的得全部重新排序)
- 缺点:会留下很多很小的内部碎片。(eg10给了9)
最坏适应:优先==使用最大的空闲区==。
- 缺点:之后有大进程来的话,没有空闲分区可用。

b.基于索引搜索的分配算法
事先建立索引表(如链表数组、位图、哈希表),按分区大小分类管理空闲分区,分配时直接索引到合适大小的分区,避免遍历整个空闲链表,从而提高分配速度。
| 算法 | 索引方式 | 分配速度 | 合并难度 | 碎片情况 |
|---|---|---|---|---|
| 快速适应 | 按固定大小分类 | 极快(O(1)) | 困难 | 内部碎片 |
| 伙伴系统 | 按 2 的幂分类 | 较快(对数级) | 简单(合并伙伴) | 内部碎片 |
| 哈希算法 | 哈希函数映射 | 较快(+链内查找) | 取决于链表管理 | 较灵活 |
回顾

①内存空间的分配 – 非连续分配管理方式
非连续分配:==为==用户==进程分配的==,==可以是分散的内存空间。==
==进程== ==分页或者分段==,离散的放进内存中。
- 基本分页存储管理
- 基本分段存储管理
- 段页式存储管理
分页存储
==内存==分成一个一个==内存块==(页框,页帧,物理块号,物理页号)
==进程==分成一个一个**==页/页面==**
==页面大小=内存块大小=进程大小==

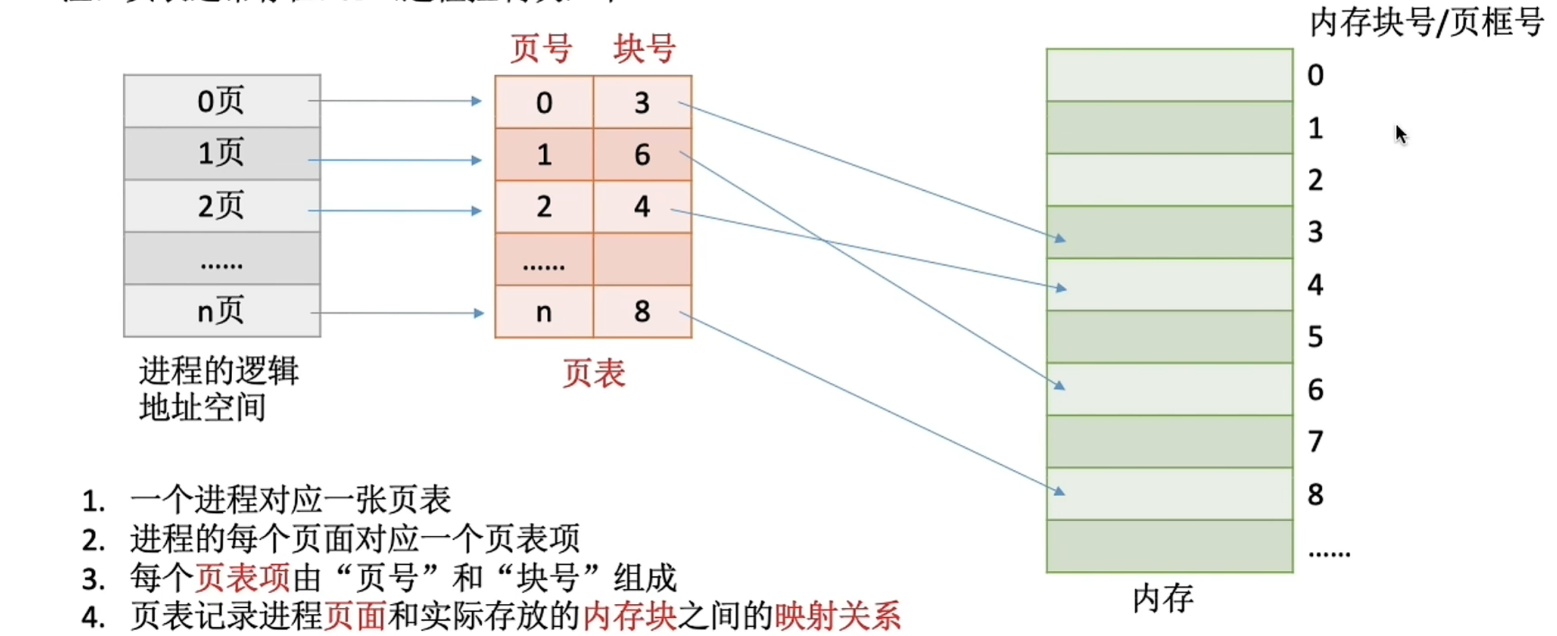
页表
记录==页号和块号的映射==关系。
==一个进程对应一张页表。==
==进程每一页对应一个页表项。==
一个页表项:
页号 块号
计算相关:页面大小2的12次方B,页表项大小8B,可以得到一个页面存放的页表项的数目
Note:
进程的页表大多数驻留在内存中。
平时进程没执行的时候,页表的始址和页表长度放在==自己进程的PCB==中。
unless当调度到该进程时,OS将页表始址和页表长度==加载到CPU的页表寄存器==中 。
==虚拟地址→逻辑地址==,包括查询页表的操作(没有页表查询程序这个东西!),==硬件自动完成==,不是OS实现。
页面大:页内碎片较大。但页表项少。
页面小:页内碎片小。但页表项多,且小页面会导致缺页频繁(io↑)。
所以页面大小是一件很重要的事情,是对页表开销,内存浪费,io效率之间的均衡。
页面在物理内存中只能从页面大小的整数倍地址开始存放。
Q1:每个页表项占多少字节?
Note:==页号是隐藏的==,不记位数。只看块号的位数就行。
(页面偏移量→页面大小)

Q2:如何实现地址转换(逻辑地址,物理地址)?
逻辑地址A对应的物理地址 = P号页面在内存中的起始地址 + 页内偏移量W
- P号页面在内存中的起始地址 = 块号 * 块大小


页面大小为2的k次方有什么好处?
无需进行除法运算,就能得到逻辑地址对应的页号和页内偏移量。(二进制数末尾k位就是页内偏移量,其余部分就是页号)
除法运算:
==页号 = 逻辑地址/页面大小==(取整数部分)
==偏移量 = 逻辑地址%页面大小==(取余数部分)


回顾

基本地址变换机构
就是:用于==实现逻辑地址到物理地址==转换的**==一组硬件结构==。**
VS
==需要硬件地址变换机构的:==用于动态重定位的情况。比如:动态分区分配,页式存储,段式存储,页式虚拟存储。
==不需要硬件地址变换机构的:==采用静态重定位的情况。比如:单一连续分配,固定分区分配。
==页表寄存器==
==存放:页表==在内存中的起始地址和页表长度
所有进程的页表都是保存在==内存==中的。
进程未被执行时,页表在内存的始址和页表长度放在==PCB==中。
当进程被调度时,os内核会把它们放到==页表寄存器==中。

地址变换过程

页式管理中的地址是一维的 / 自动计算的
即只要给出一个逻辑地址,系统就可以自动算出页号和页内偏移量,并不需要告诉系统,页号是什么以及页内偏移量占多少位。(因为可由页面大小得知)

进程页表通常是装在连续的内存块中的。(也成全了下条)
为了方便页表的查询,常常会让一个页表项占用更多的字节,使得==每个页面恰好可以装得下整数个页表项==。

回顾
==两次访存:== 一次是查询页表,一次是访问目标内存单元。

具有快表的地址变换机构

==快表TLB==
- ==是一种高速缓存Cache!不是内存。==
- 存放最近访问的页表项的副本。(普通cache会有各种数据的副本,快表cache就很单一了哈哈哈)
- 与之对应,==页表称为慢表。==
- 提高TLB命中率的方法:①增大TLB容量。②提高页面大小。【TLB 覆盖范围 = TLB 条目数 × 页面大小】
如果快表命中,只需要一次访存。
==如果快表没命中,需要再增加两次访存。==(访存费时间,访问cache快很多)

局部性原理

基于局部性原理,快表命中率可以达到90%以上。
回顾

两级页表

单级页表存在的问题
问题一:==页表必须连续存放,如果页表很大,需要占用很多个连续的页框==,和内存离散分配的初衷相反。
问题二:==没有必要让整个页表常驻内存==,进程在一段时间内可能只需要访问某几个特定的页面。

问题一solute:==把页表分块,用 页目录表(外层页表)索引。==


问题二solute:==虚拟存储技术,不必让整一个 页表 常驻内存。==

Note:
如果采用多级页表机制,则各级页表大小不能超过一个页面(每个页面可以存放的页表项不能过多,以此确定页号占的位数)。
两级页表新的问题:三次访存(假设没有快表)
例题:28位的页号至少要分三级,因为各级页表最多存放2的10次方个页表项
- 第三次访存:访问目标内存单元==(三级页号)==
- 第二次访存:访问内存中的二级页表==(二级页号)==
- 第一次访存:访问内存中的页目录表==(一级页号)==
- 访存访问的都是物理地址。

回顾

分段存储

分段
进程按照自身逻辑分为多个段,每个段长度不等。
每一个段都有一个段名(编译程序会转为段号)。每一个段编址都是从0开始。
==各段之间可以不相邻。==

==逻辑地址: 段号 | 段内地址==

段表
段表记录每一个段在内存中存放的位置。
构成:段号,段长,==段基址==。
各个段表项的长度是相同的。
==一个进程一个段表。每一个段表项对应进程的某一段。==

地址变换

分段分页对比
==分页:==
- 实现离散分配,提高内存利用率。
- ==对用户是不可见的。==
- 页的大小固定,由系统决定。
- 分页的用户进程,**==地址空间是一维的==**。程序员只需给出 单一逻辑地址 即可表示地址。
- ==有内部碎片==
==分段:==
- 更好满足用户需求。
- ==对用户是可见的。==
- 段的大小不固定,用户编写的程序决定。
- 分段的用户进程,==地址空间是二维的==。程序员标识地址时,既要给出 段名,也要给出 段内地址。
- ==分段更容易实现信息的共享和保护。==
- 同样可以引入“快表”
- ==有外部碎片==

回顾

补充:
- 共享段表:有些段可以被多个进程共享。
段页式存储

分页和分段的优缺点

段页式
==先按模块分段,再将各段分页。==

逻辑地址

段表,页表
==一个进程对应一个段表,可能会对应多个页表。==

逻辑地址转为物理地址
==三次访存(无快表)==

回顾

Notes:
让不同页表的页表项指向同一个页帧,可以共享改页帧的代码。(类似于共享段表,此处应该叫共享页表?)
如果代码是可重入的,可以减少程序段调入调出,从而减少程序段的对换数量。
- ==可重入程序==:通过共享来使用同一块存储空间,或者通过动态链接的方式将所需的程序段映射到相关进程中。
==对主存的访问,是以字节/字为单位的。==
==对主存的分配,是以块(页)/ 段为单位的。==
例题:进程R和进程S共享数据data,若data在R和S中所在页/段的页号/段号分别为a,b。两个页/段所对应的页框号/段表项分别为c,d。
- 则a和b一定相等。c和d不一定相等。