计网-U4 网络层
前言
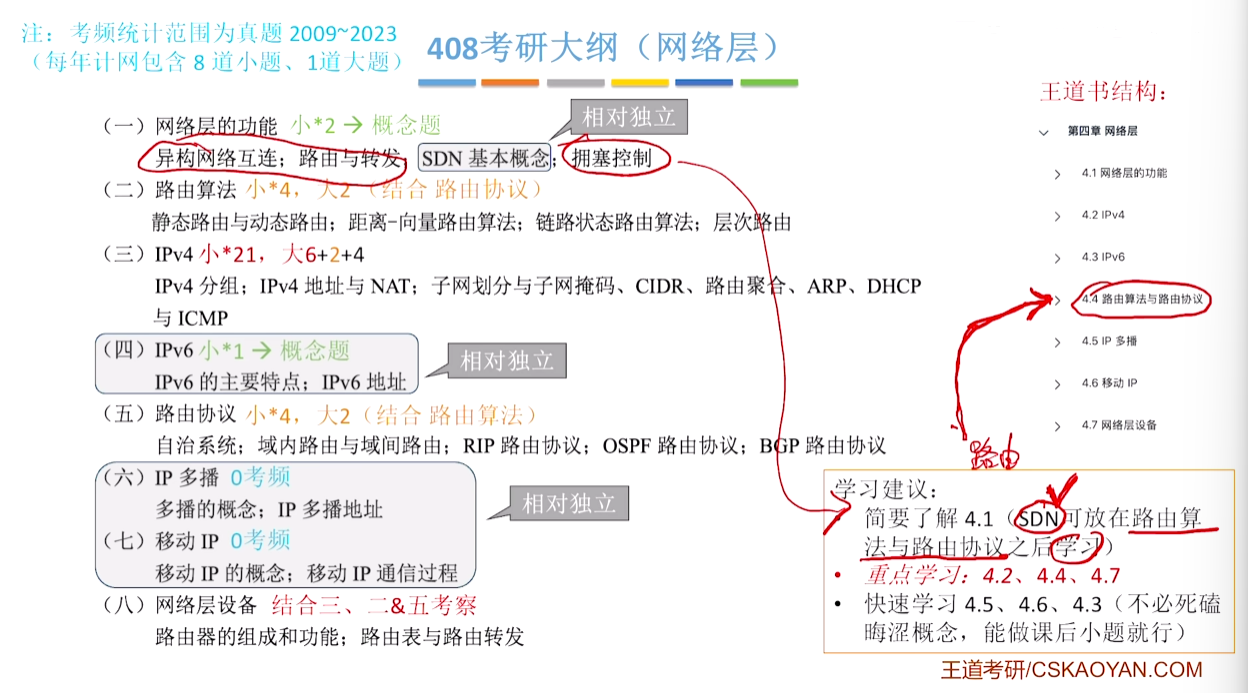
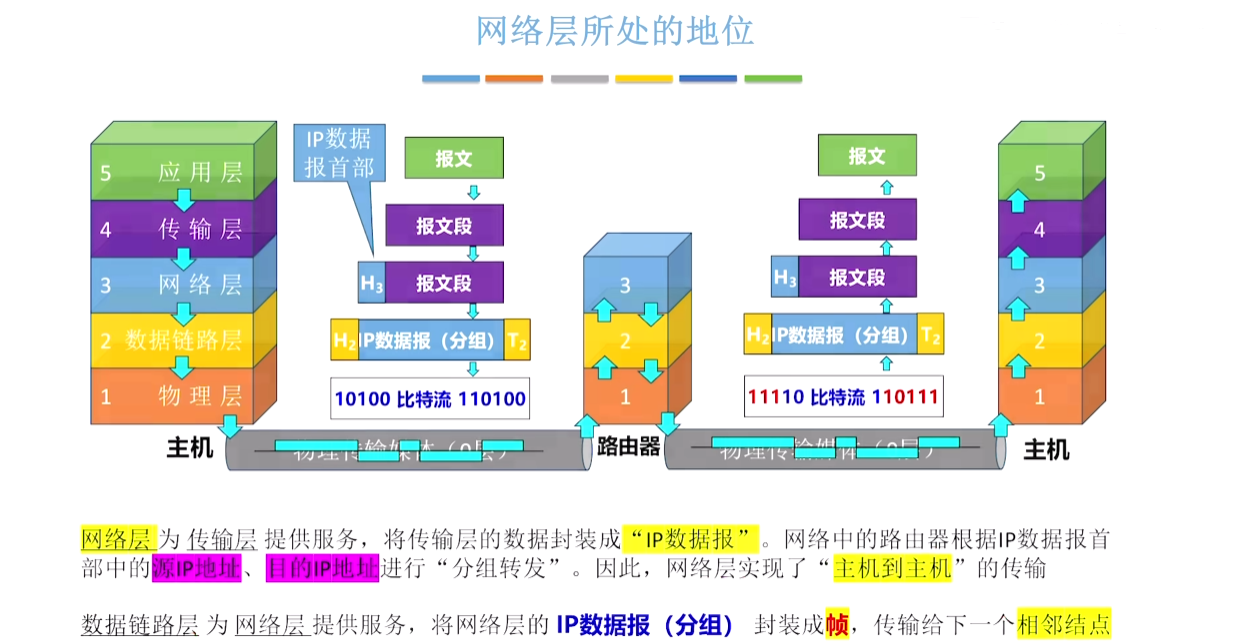
4.1 网络层的功能
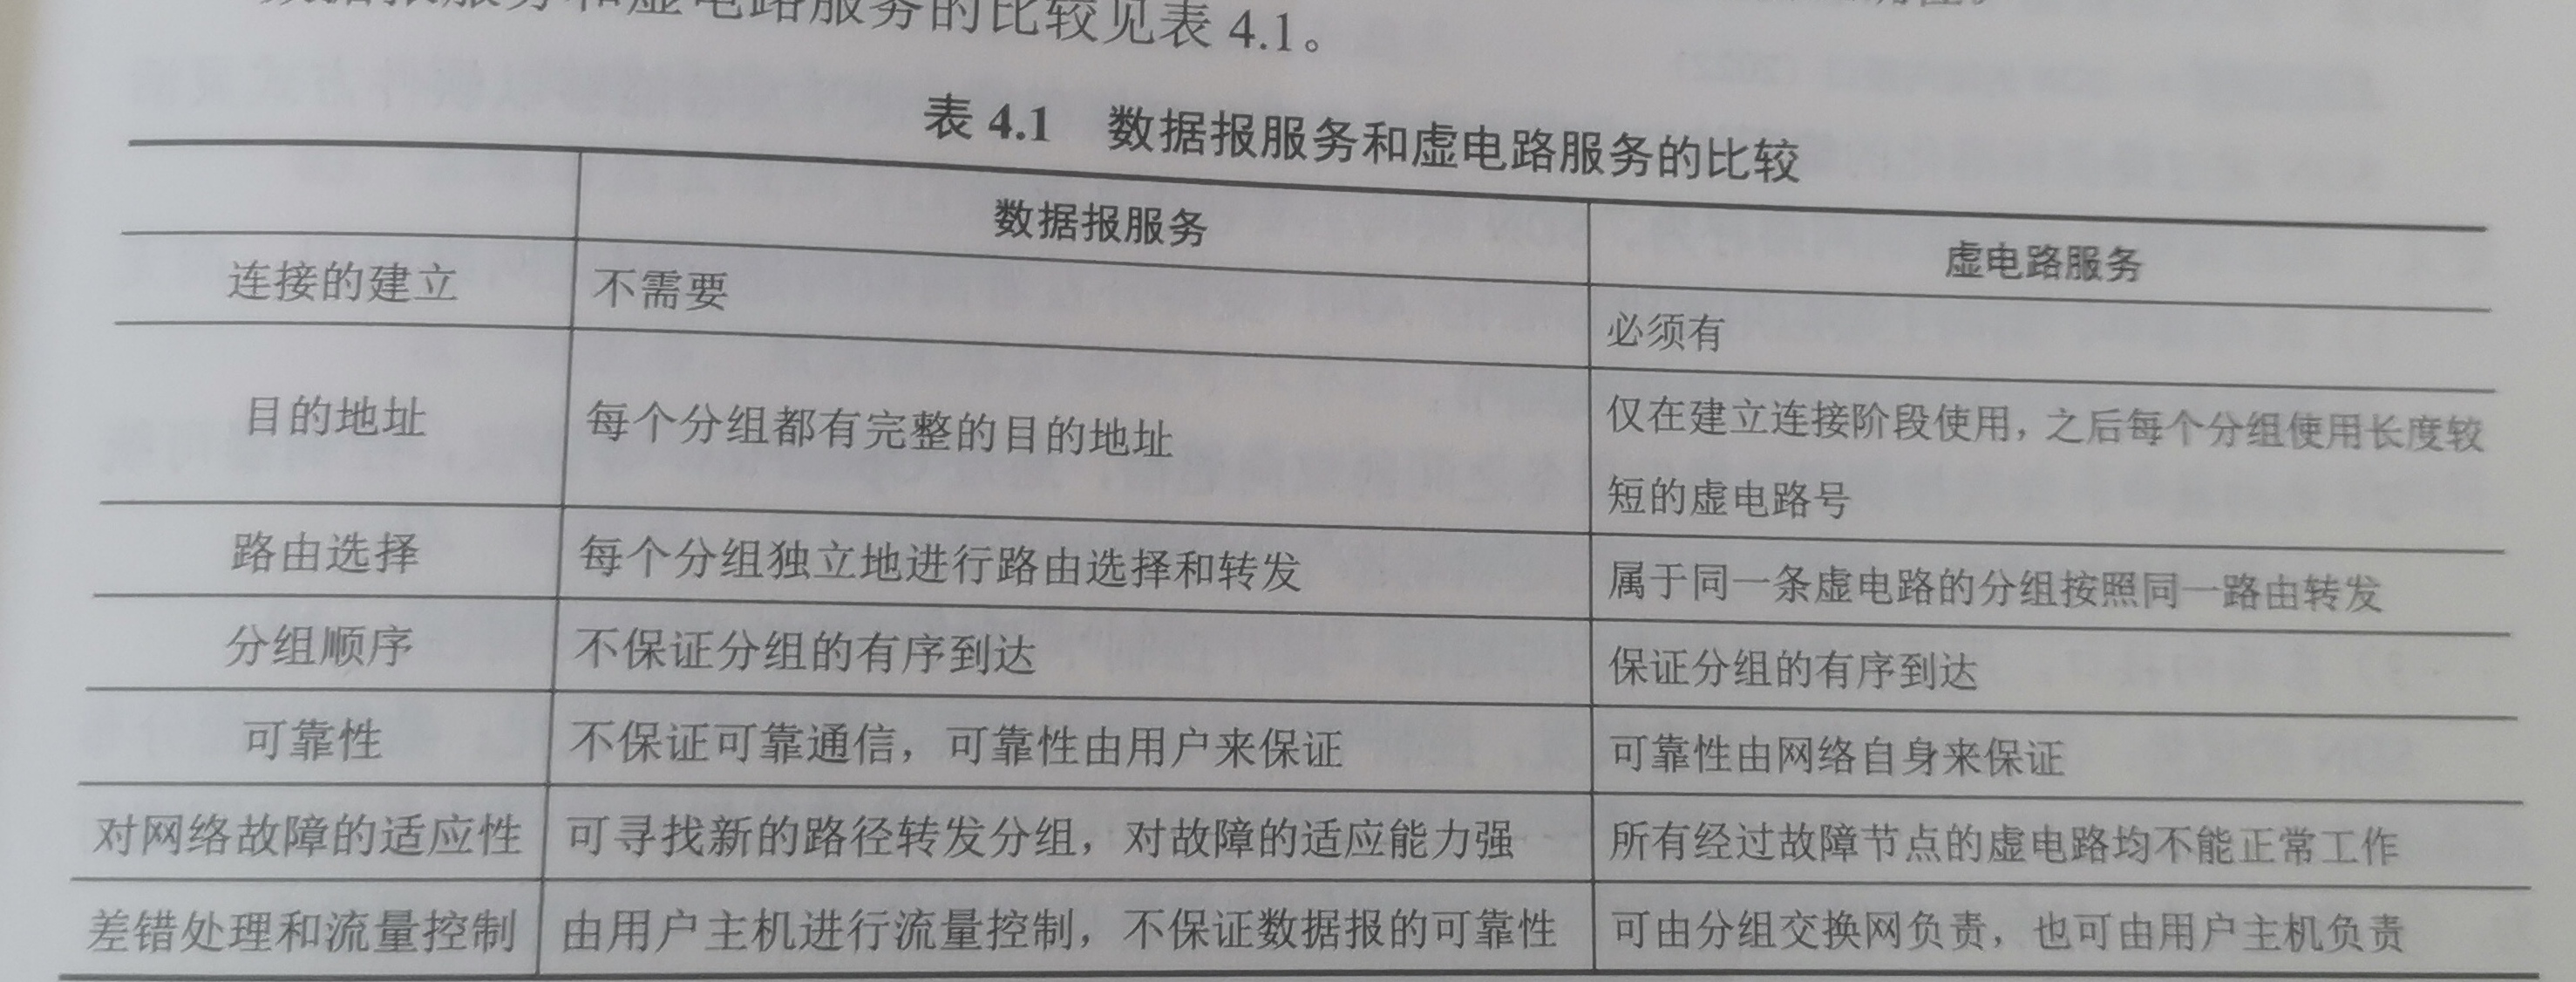
OSI参考模型主张在网络层使用:面向连接的虚电路服务
TCP/IP体系结构的网络层提供的是:无连接的数据报服务
即通信的可靠性由高一级的传输层负责。
这样子可以使得网络中的路由器做得简单,价格低廉。
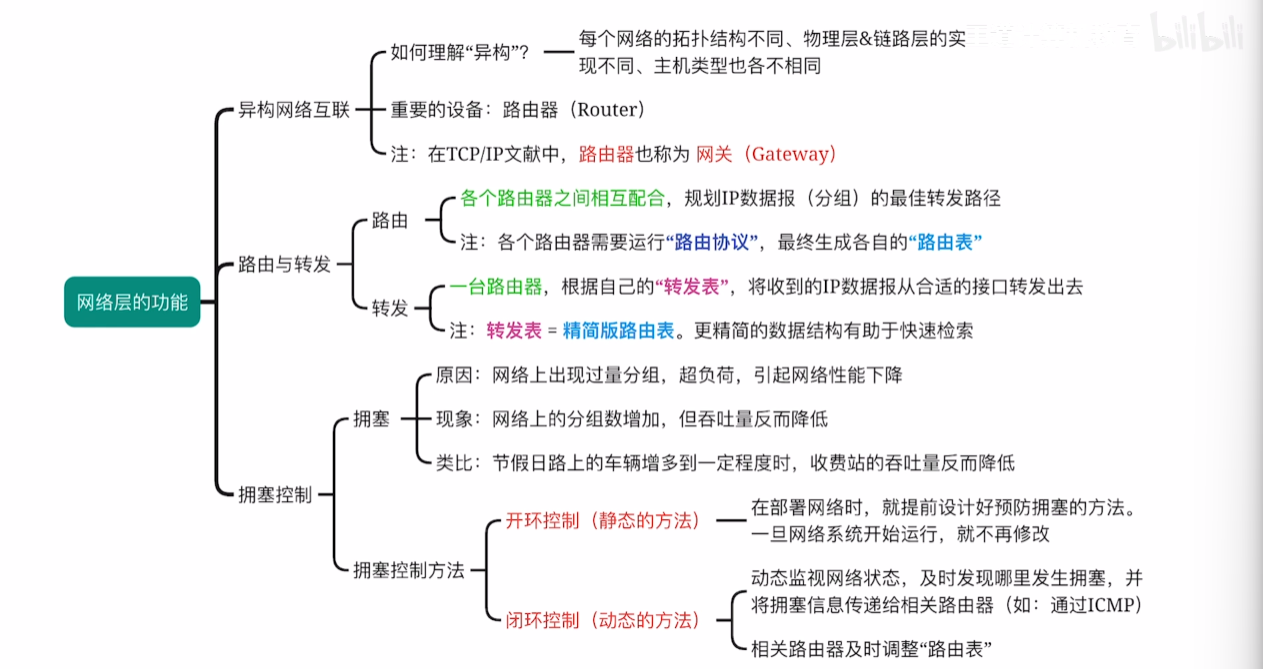
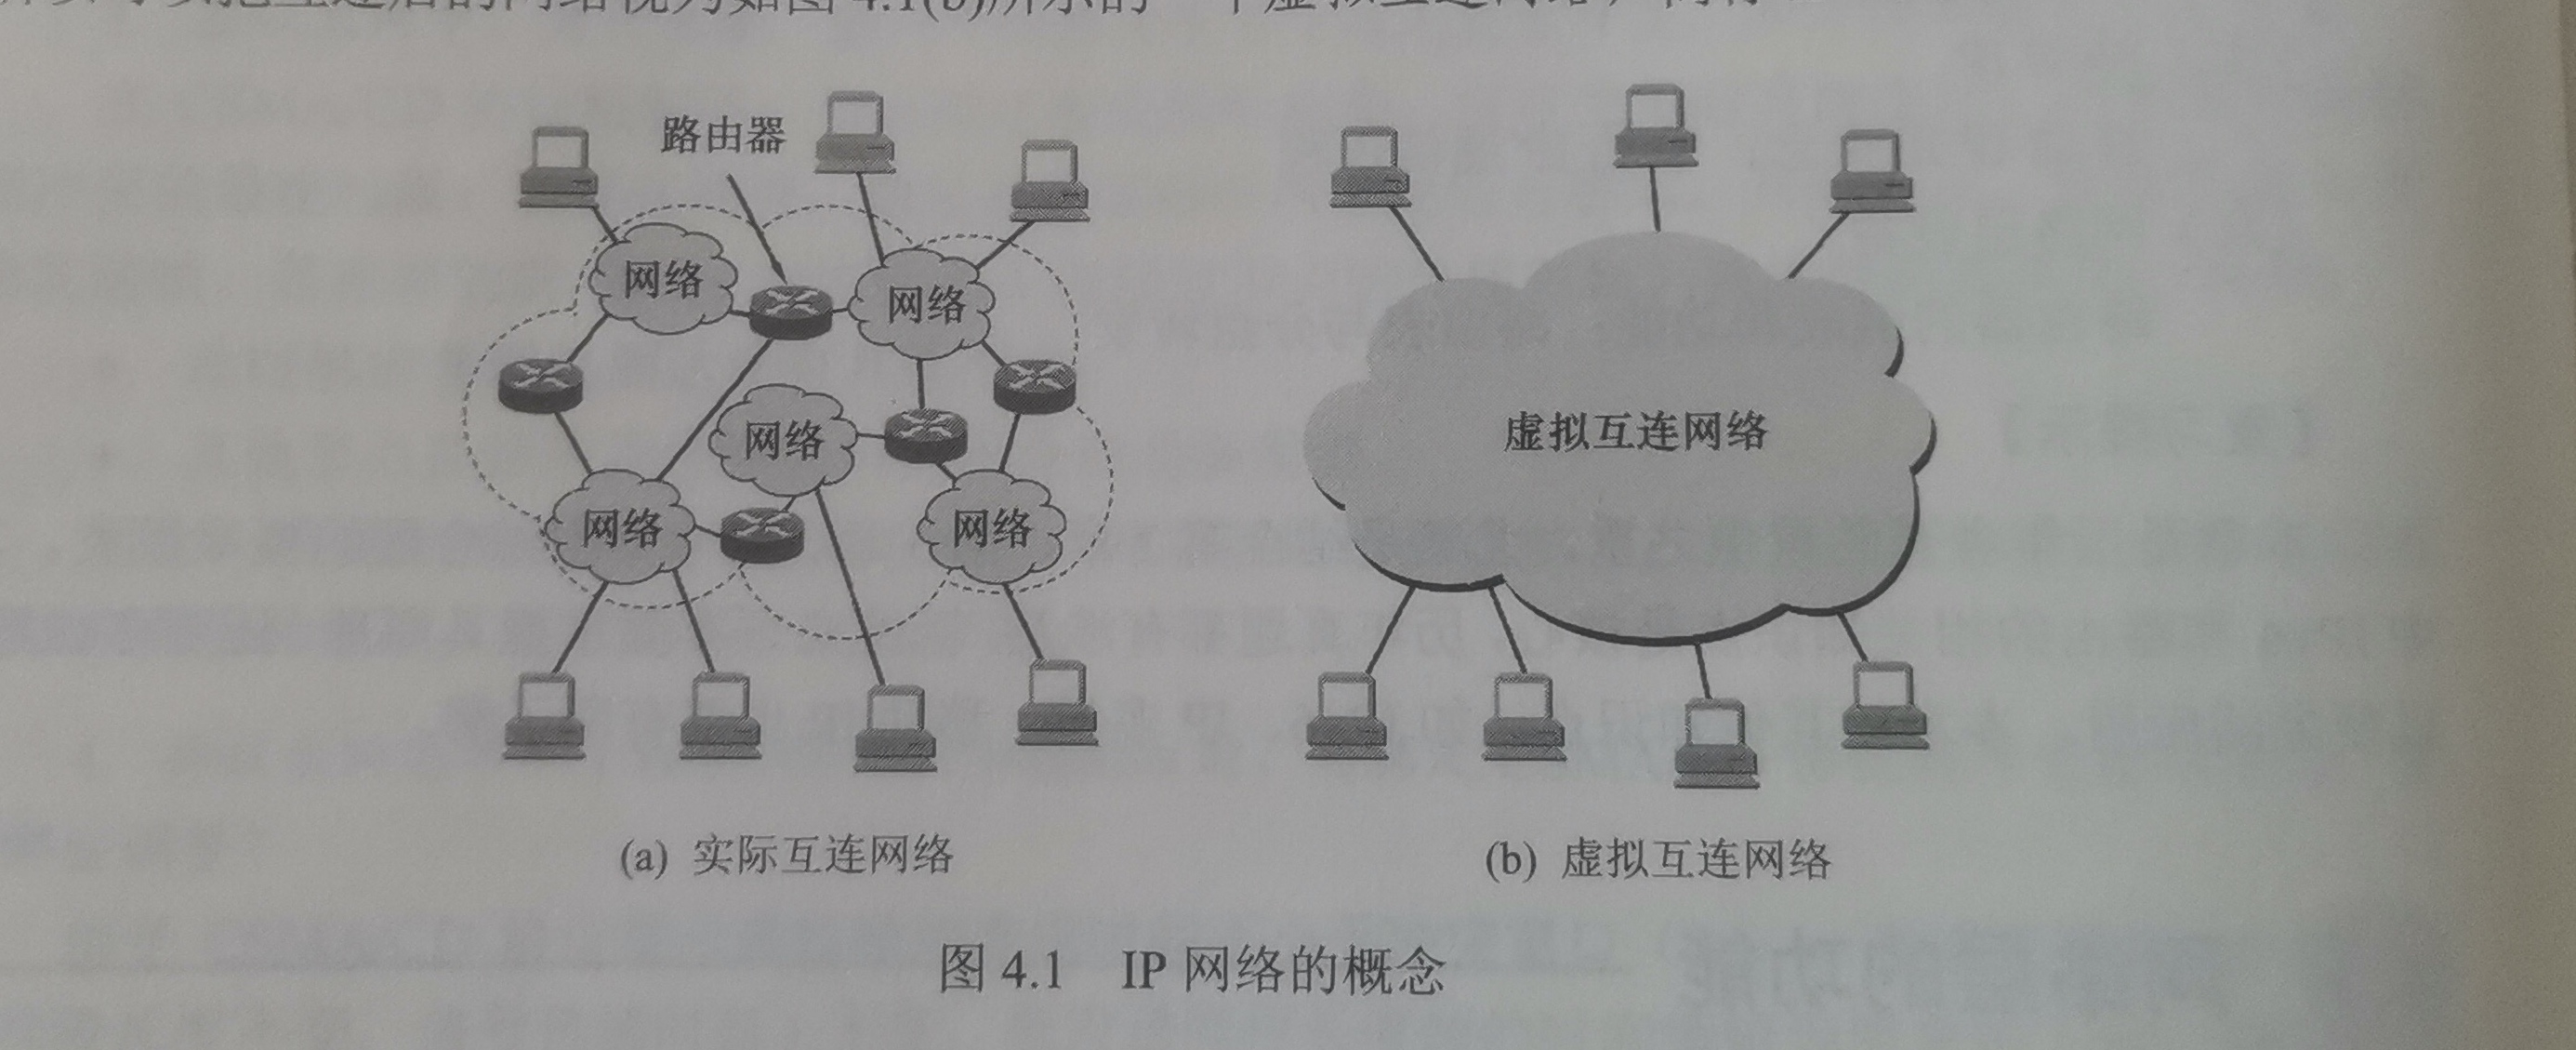
① 异构网络互连
网络互连:用中继系统对网络进行互连。
异构网络互连:对 物理层 / 数据链路层 / 网络层 不同的网络(/传输介质/数据编码协议/链路控制协议)进行互连。
==中继系统:==
- 物理层中继系统:转发器,集线器
- 数据链路层中继系统:网桥或交换机
- 网络层中继系统:路由器
- 网络层以上的中继系统:网关
例题:在由路由器互联的多个局域网结构中,要求网络层以上的高层协议必须相同:因为网络层之上的协议是路由器所无法处理的
② 路由与转发
路由表的核心功能:==路由选择== 和 ==分组转发==
③ 网络层提供的两种服务
虚电路:
在网络层建立一条 ==逻辑链接==(而非物理链接,所以也无需分配带宽)
虚电路建立 – 数据传输 – 虚电路释放
在建立虚电路的阶段:分组才需要携带==完整的源地址、目的地址==,以进行路由器的选择。
之后分组的首部==只需要携带 虚电路号==,属于同一条虚电路的分组按照同一路由进行转发。(不同分组有不同的虚电路号)
虚电路也需要路由选择的。
虚电路的“虚”:链路不是专用的,可被多条虚电路共享(不是共用,是虚路共享,不会有冲突)
虚电路分为:永久性虚电路,交换型虚电路(临时连接)
数据报:
- 发送分组前无需连接。
- 分组仅占用当前链路的资源。
④ SDN(Sofeware Define Network)
传统的网络层:
- 数据平面:负责分组转发
- 控制平面:负责路由选择
SDN网络架构的网络层:
- 网络的控制功能由:一个远程控制器完成(实现路由选择,由一个远程的服务器来计算和分发流表给网络设备)
- 路由器仅保留数据平面的功能(分组转发)
- ==取代传统路由器的转发表 → 流表==(SDN的转发表)
- 控制协议:OpenFlow
SDN还提供的编程接口:(可编程)
- 北向接口:向上层开发者提供标准化API
- 南向接口:实现控制平面和数据平面的双向通信(通过OpenFlow协议)
- 东西向接口:用于控制器集群的内部通信
SDN的优点:①集中控制与分布转发。②灵活可编程性。
SDN的缺点:①安全风险。②性能瓶颈
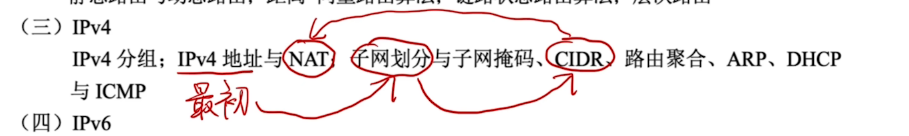
4.2 IPv4
① IPv4分组
协议字段:网络协议(IP协议)
版本字段:v4,v6
网际层的协议有:IP协议,ARP协议,ICMP协议,IGMP协议
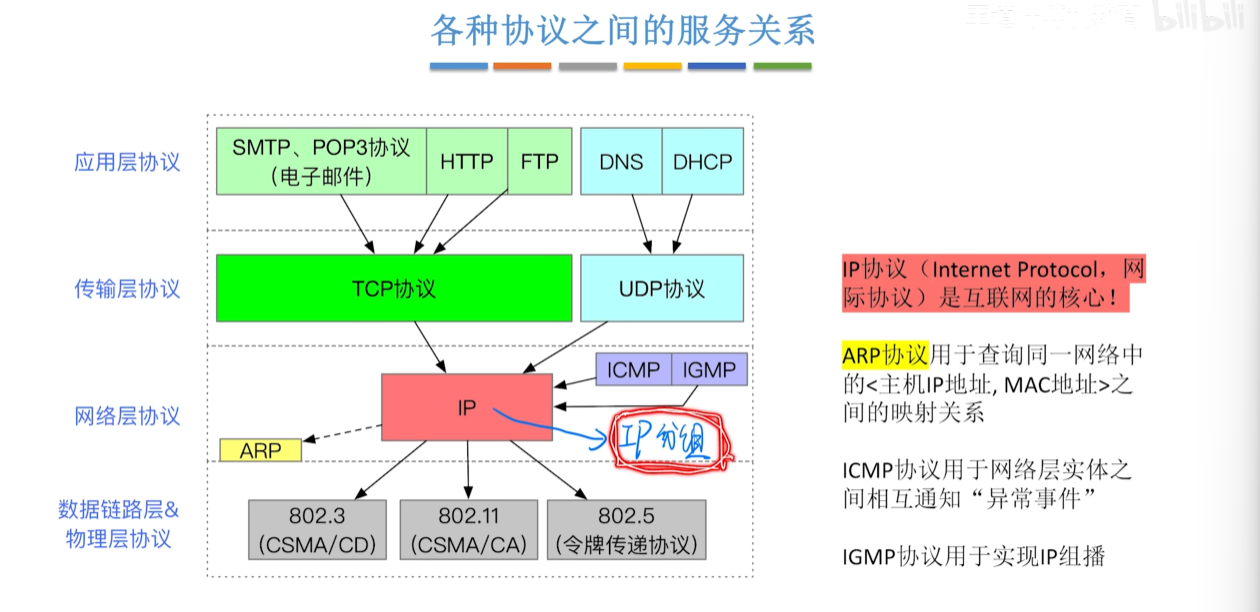
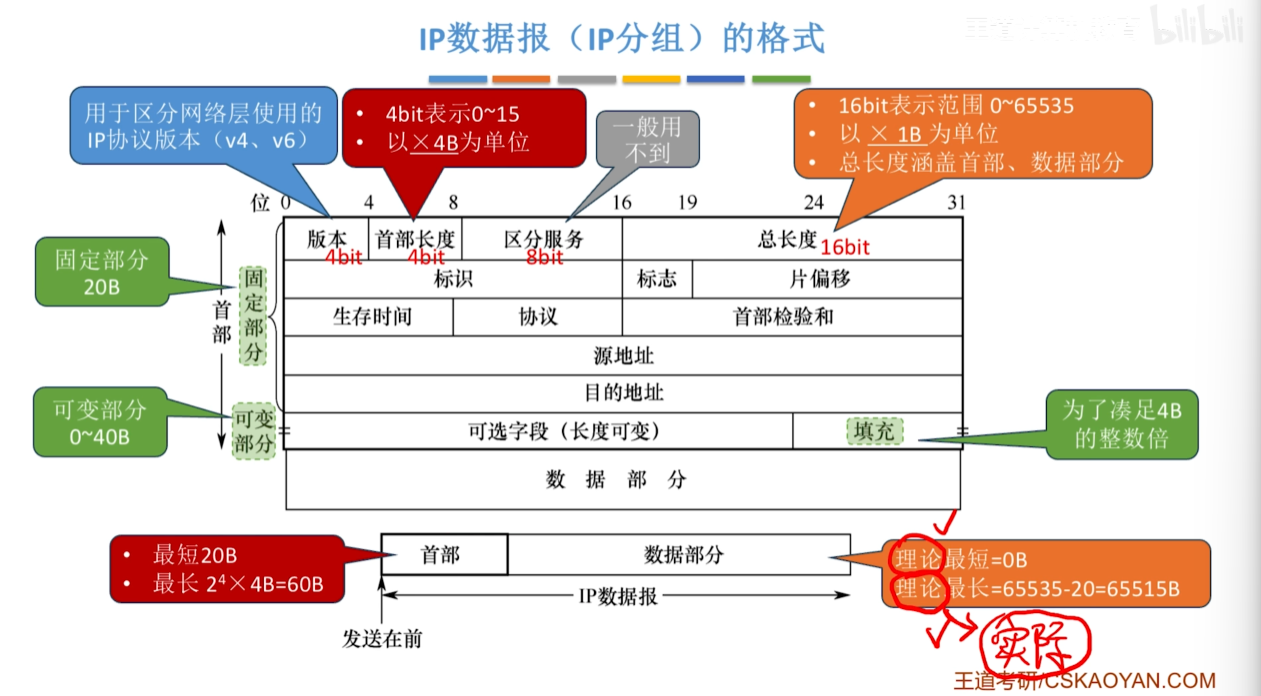
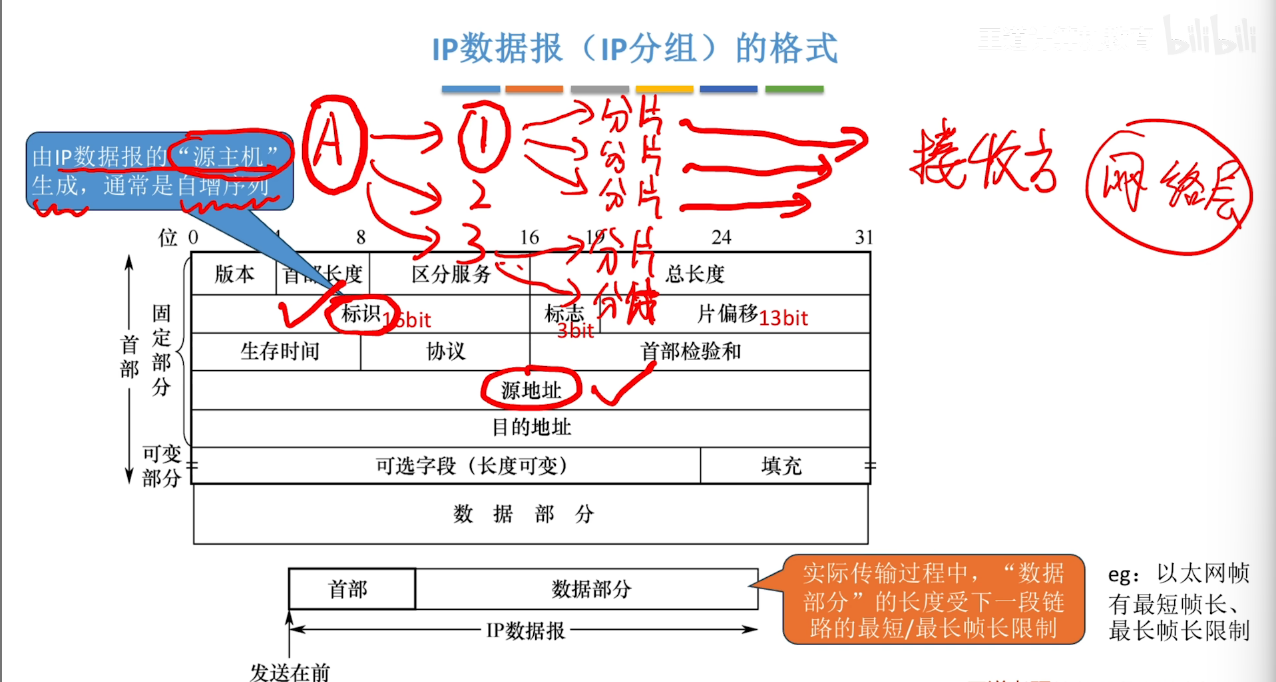
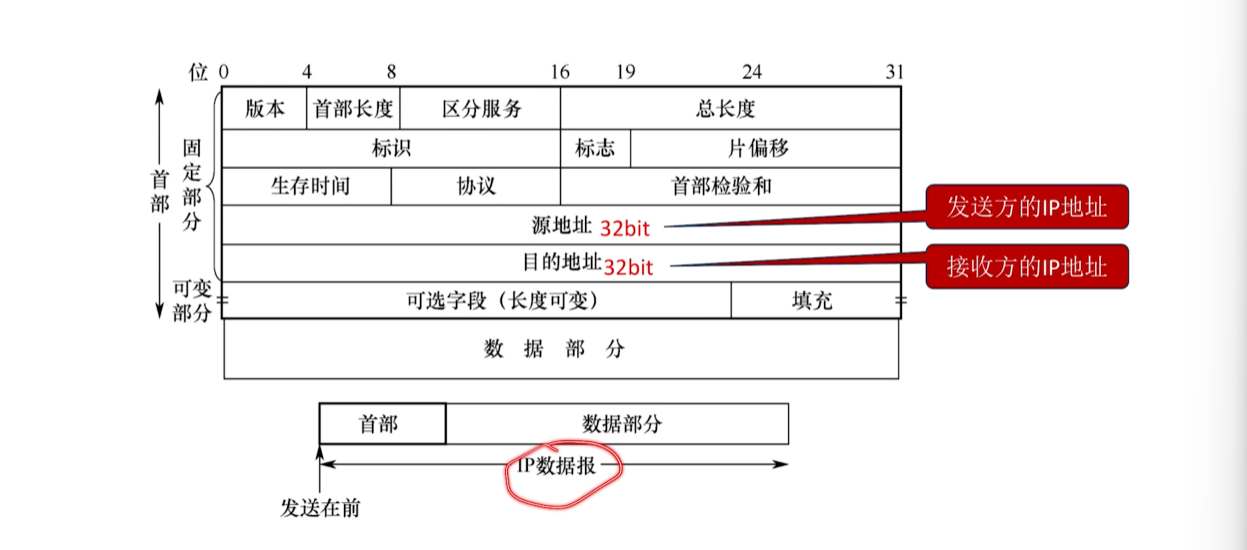
IP数据报(IP分组)的格式
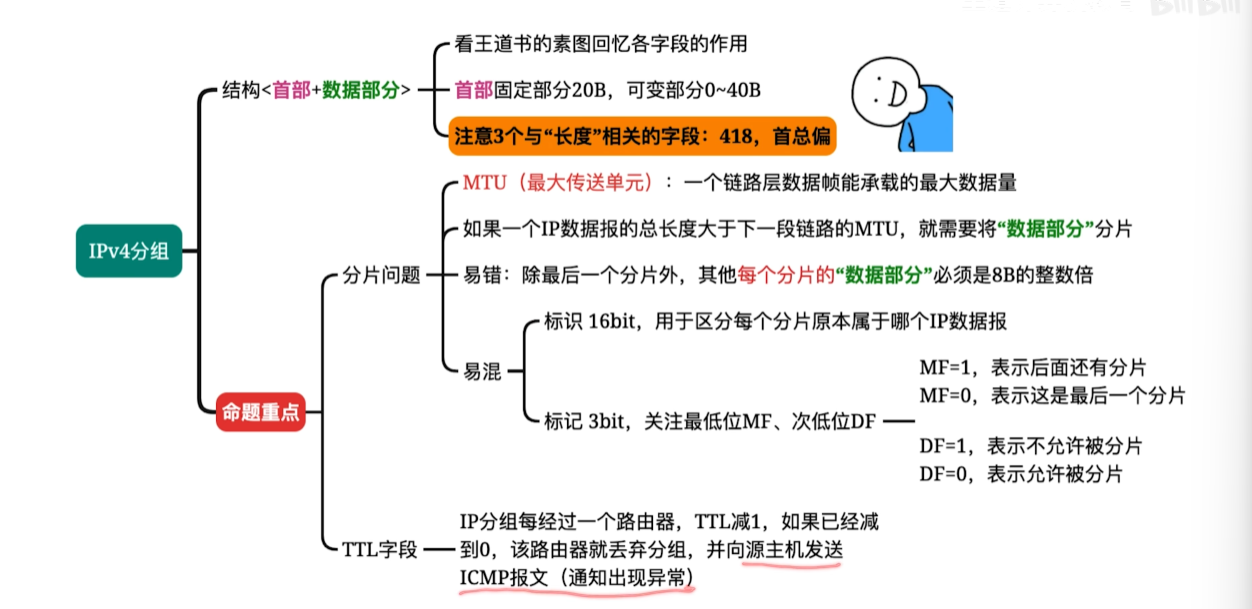
==首部 / (IP分组头)==(固定部分20B+可变部分0-40B) + ==数据部分==
==① 首部固定部分的第一行==
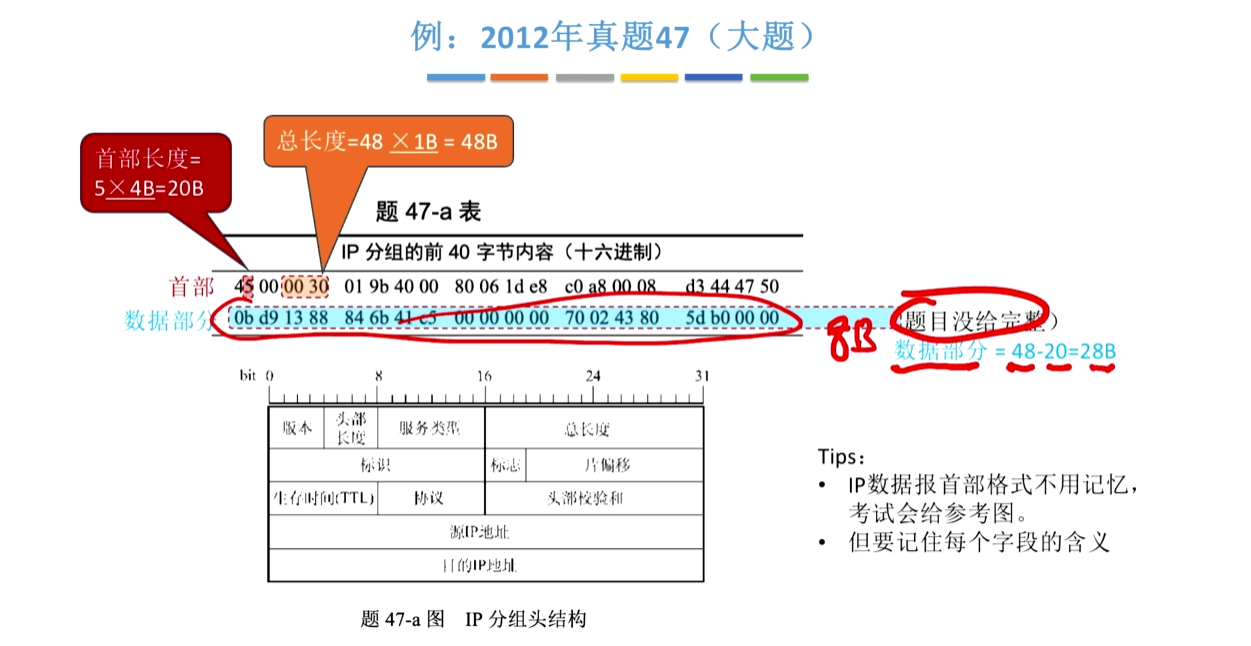
【版本+首部长度+区分服务+总长度(指的是整个IP数据报的总长度)】
版本:IP协议的版本(4或6)
- 协议字段(表示使用IP的上层协议,如值为6表示TCP)
- 版本字段(表示IP的版本,如IPv4)
总长度:16bit,所以IP分组最大长度65535B,数据报的最大长度是2^16 -20=65515B
- 因为以太网MTU=1500B,所以实际上在以太网中最大数据部分1480B(20B是首部)
IP数据报首部包含3个与长度有关的字段:
首部长度,总长度,片偏移。它们的 基本单位 分别为4B,1B,8B。
例题:某IP分组的片偏移字段值为100,首部长度字段值为5,总长度字段值为100,则该IP分组的数据部分的第一个字节编号与最后一个字节的编号是:800,879
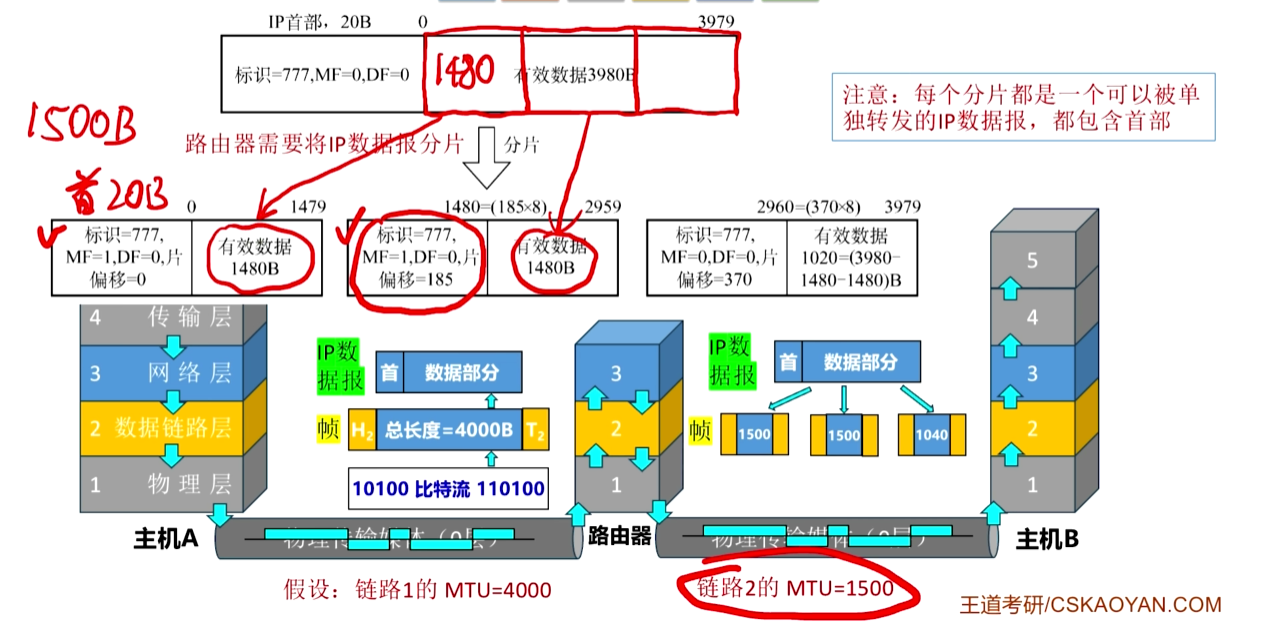
例题:MTU=800B,IP分组首部20B,特别注意片偏移8B整数倍,所以780B只有776能够一次装入,而不是装入800B!
==② 首部固定部分的第二行==
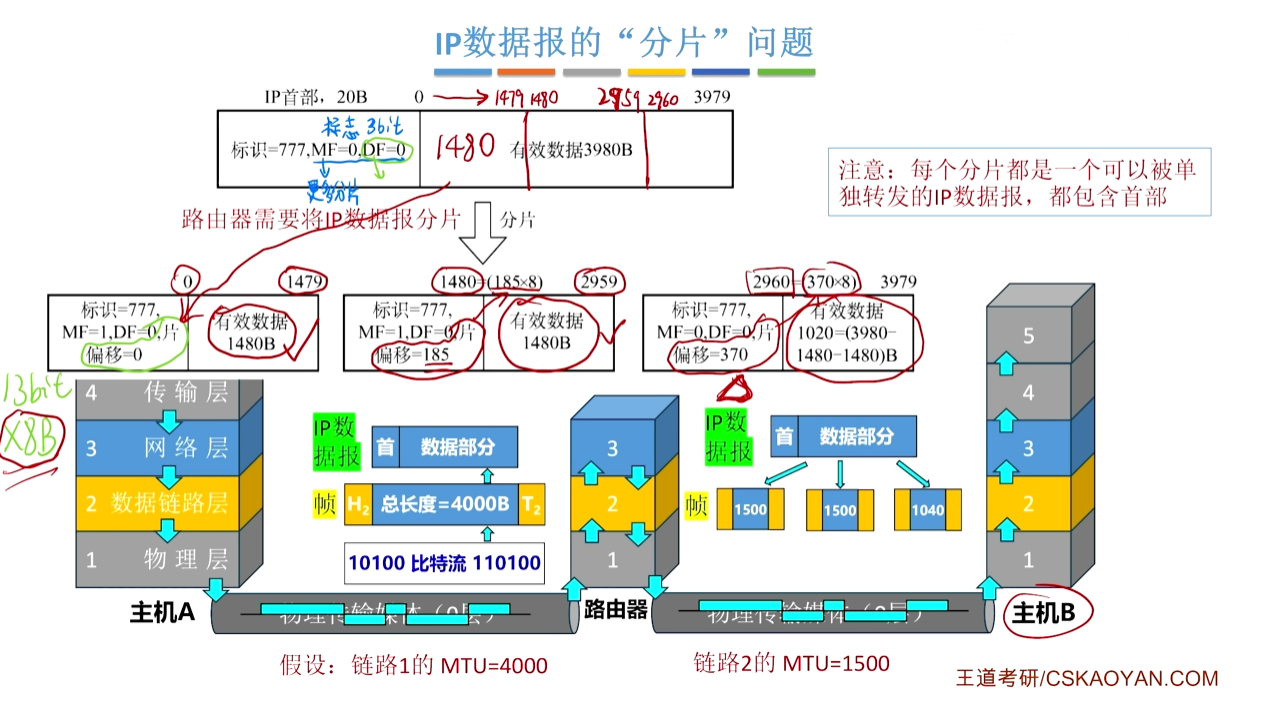
(发送方)分片
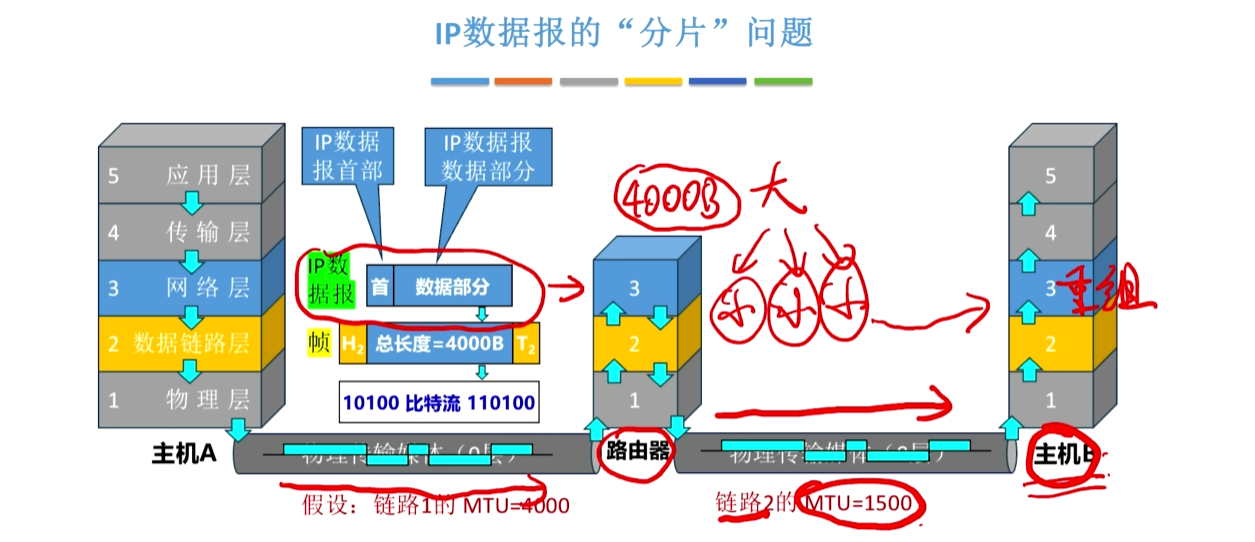
==实际传输过程中,“数据部分”的长度==会受到下一段链路的最短/最长帧长限制,46-1500。
- MTU:一个链路层数据帧承载的最大数据量称为==最大传送单元MTU==。eg:以太网的MTU=1500。
- 所以:如果一个IP数据报的总长度超出了下一段链路的MTU,就需要分片。
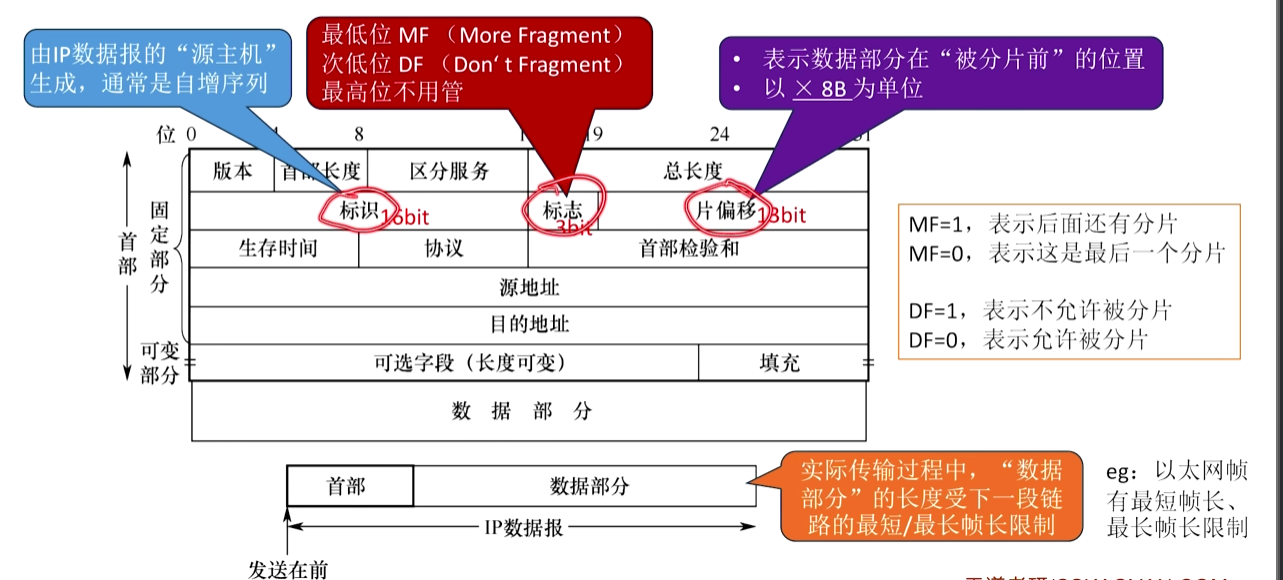
- **==分片:==**分片收到 标志字段控制:
- DF=0,表示数据报允许被分片(Don’t Fragment)
- DF = 1的时候,不仅要丢弃分组,还需用ICMP(终点不可达报文)向源主机报告差错。
- MF=0,表示这是最后一个分片(More Fragment)
- 除了最后一个分片外,其余分片长度必须是8B的整数倍。
- DF=0,表示数据报允许被分片(Don’t Fragment)
- 分片发生在:源主机,或者任何一个路由器
- 重组发生在:目的主机
(接收方)分片整理
目的主机接收到的分片可能是乱序的,需要整理排序(**==通过“标识”,“标志”,“片偏移”字段==**)
- 只有目的主机才能对分片重组(路由器不行)
- 因为首部的 “片偏移” 字段是以 8B 为单位,因此,*除了最后一个分片外,其他每个分片的数据部分必须是8B的整数倍。
- 标识位:同一个分组的分片具有相同的标识位。
==③ 首部固定部分的第三行==
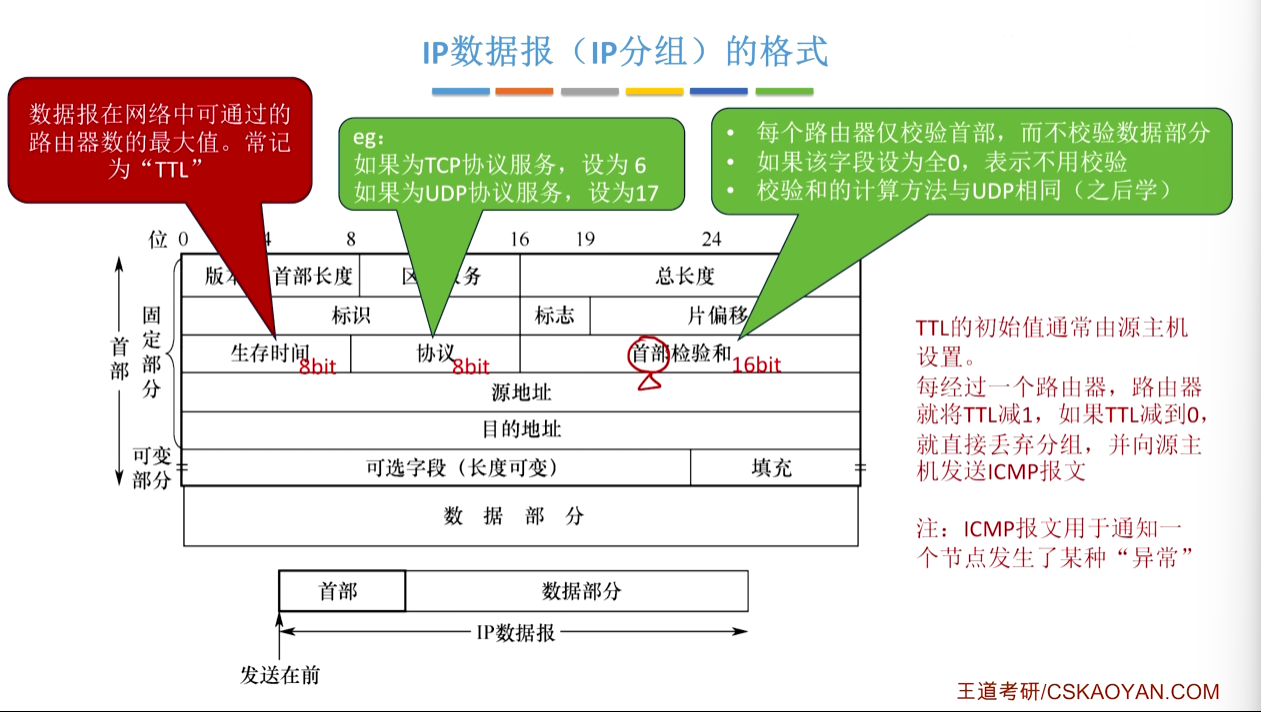
生存时间TTL:IP数据报的生存时间TTL。每经过一个路由器,TTL-1。
- 如果TTL=0,就丢弃分组,并向源主机发送ICMP报文,报文类型是时间超过报文。
首部检验和:每个路由器仅校验首部,不校验数据部分。(如果字段全0,表示不用校验)
- 具体的检验方法:把对首部的每个16bit按反码运算求和再取反码。
④首部固定部分的第四五行
IP地址:源地址,目的地址(见下节)
回顾
② IP地址
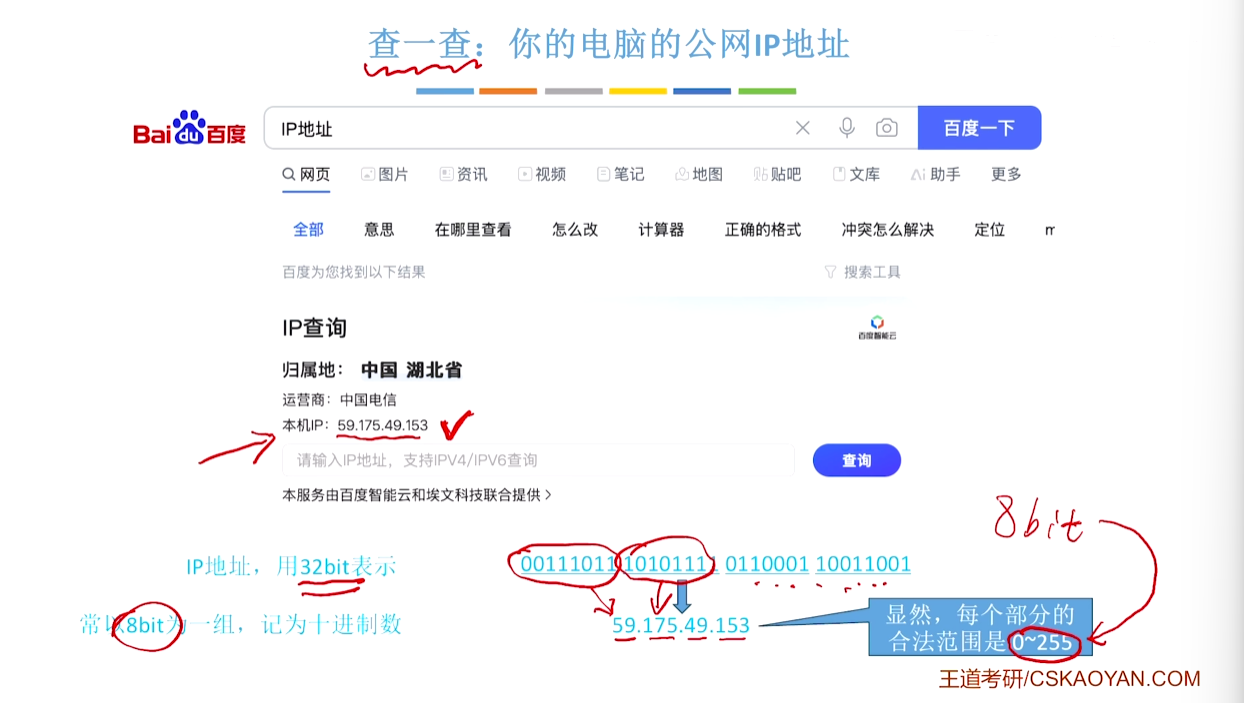
==32位(bit) 【=网络号+主机号】==
(为方便阅读)==用十进制表示为4个部分,每个部分表示8bit。==
(IP地址资源由ICANN进行有偿分配,32位的地址最多可以分配2^32≈42亿。)
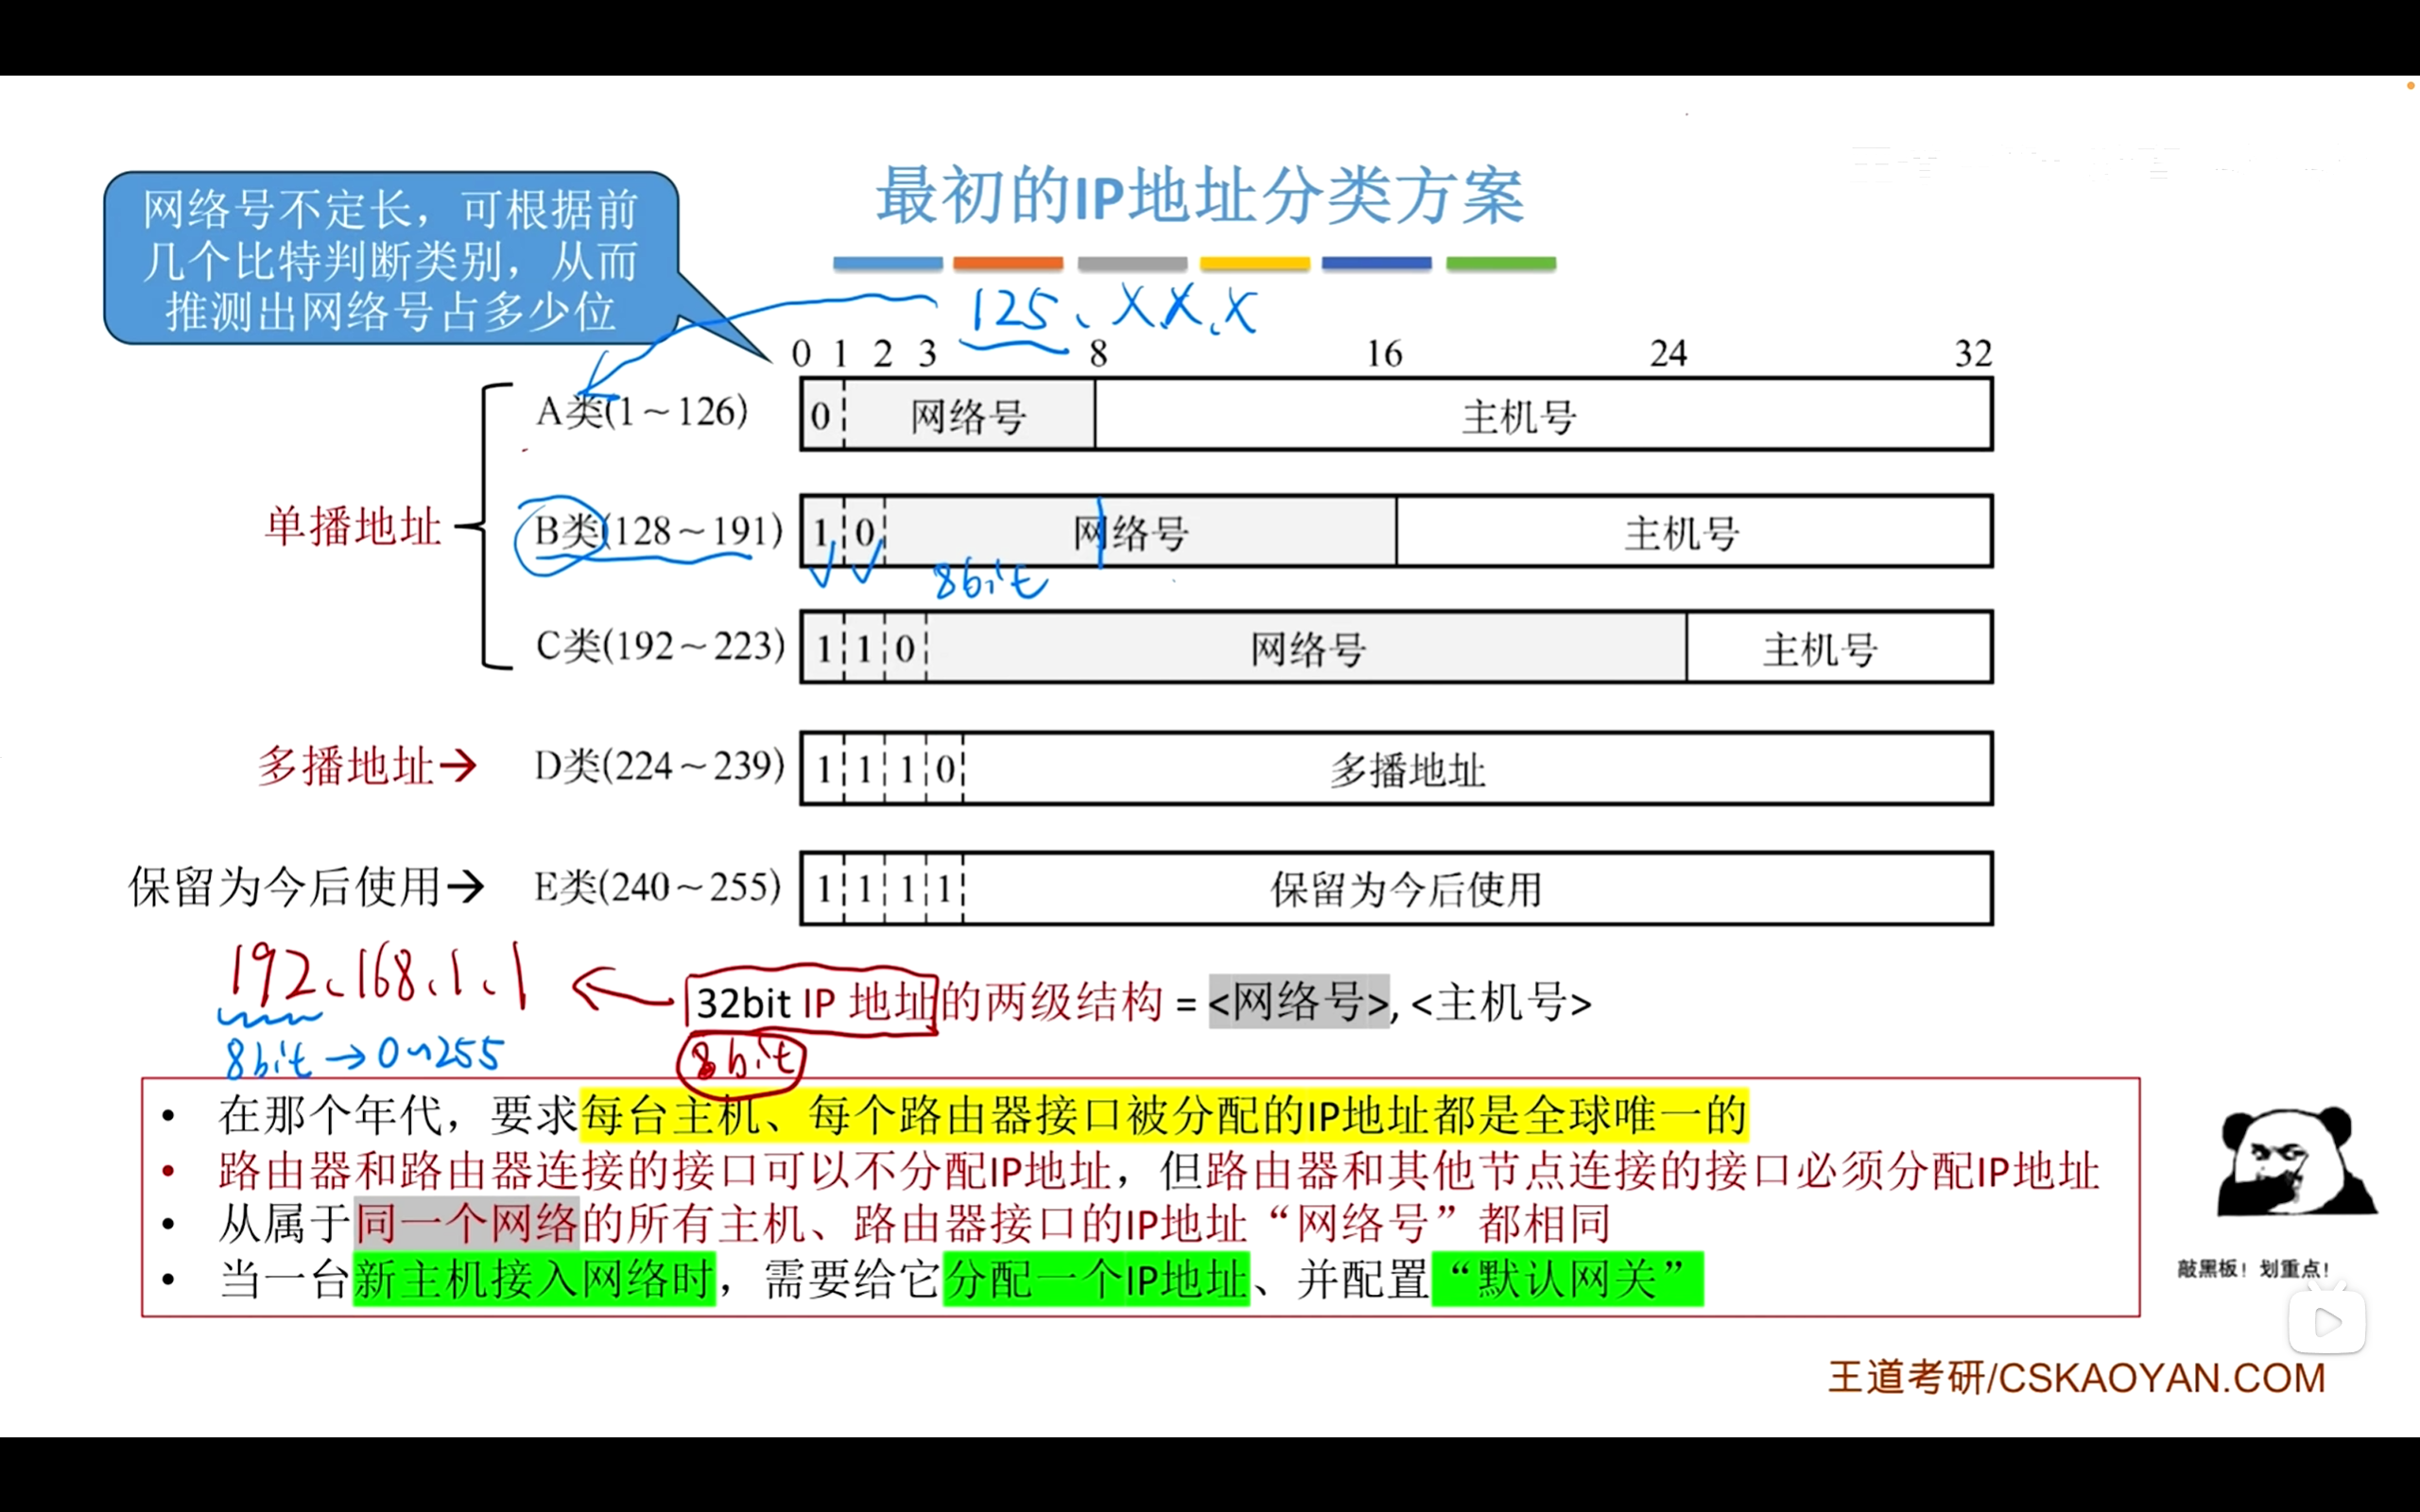
1. 最初的IP地址 分类/编写方案
==网络号不定长,但【前面的数字+网络号】定长为8位==
==【网络号 + 主机号】==
A类(1-126)
- (前八位可表示的:网络号数量是2^7-2=126,减了全0(DHCP特殊用途)和127的情况。(或者理解为前面第一位固定是0))(区别:主机号-2才是因为全0和全1)
- 前面8bit,主机号32-8bit
B类(128-191)
- (前八位可表示的:网络号数量是2^6=64)(从128开始而不是127,全1的127是另外的情况)
- 前面16bit,主机号32-16bit
C类(192-223)
- (前八位可表示的:网络号数量是2^5=32)
- 前面24bit,后面32-24bit
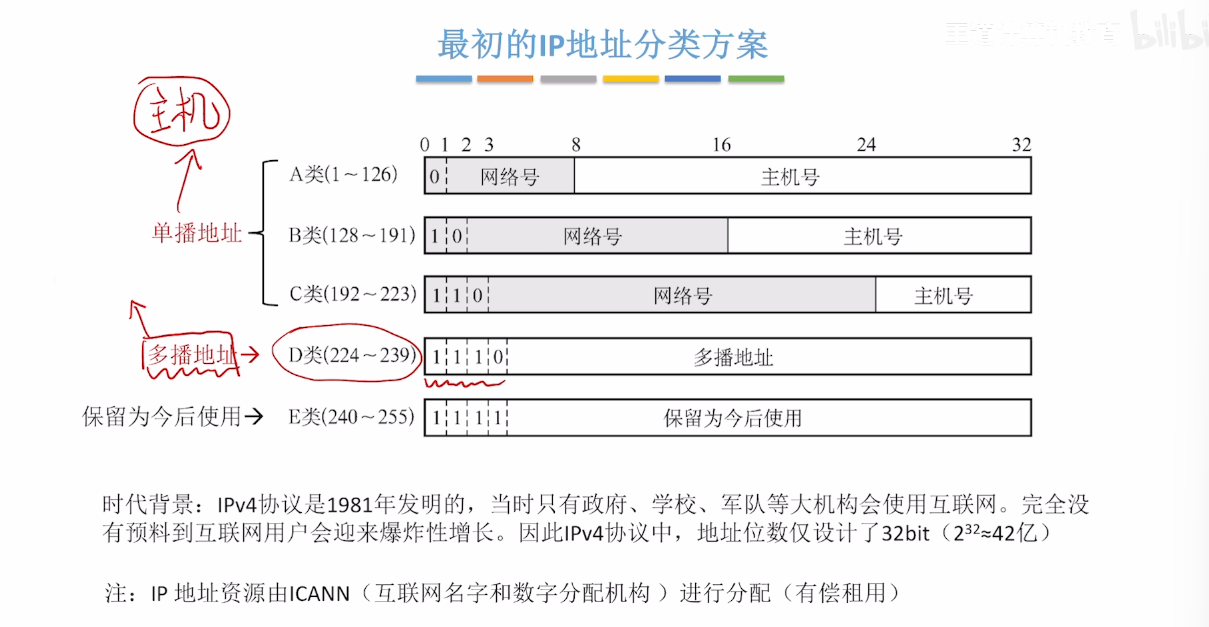
D类(224-239)
- (前八位可表示的:网络号数量是2^4=16)
- ==多播地址==(qq号和qq群号的区别)非单播地址
E类(240-255)
- (前八位可表示的:网络号数量是2^3=8)(
- (0到7一共八位是编码范围,8是主机号的编码开始,所以网络号一共有2^8-2种编码)
| 网络类别 | 最大可用网络数 | 第一个可用网络号 | 最后一个可用网络号 | 每个网络中的最大主机数 |
|---|---|---|---|---|
| A | 2^7-2? | 1 | 126 | 2^24 - 2? |
| B | 2^14? | 128.0 | 191.255 | 2^16 - 2? |
| C | 2^21? | 192.0.0 | 223.255.255 | 2^8 - 2? |
重点内容:
- ① 在那个年代,要求每台主机,每个路由器接口被分配的IP地址都是全球唯一的。
- ② 路由器和路由器连接的接口可以不分配IP地址,但==路由器和主机节点连接的接口== 必须分配IP地址。
- ③ 从属于==同一个网络的所有主机,路由器接口的IP地址 “网络号” 都相同。==
- ④ 当一台新主机接入网络时,需要给分配一个IP地址,并配置 ==“默认网关”== 。
多播,单播,==广播地址==:
- 单播地址分配给一个主机,
- 多播地址分配给一组(就像是qq号和qq群号的关系),
- 广播地址,主机号全1。
其他:
- IP地址表示的是主机号,而不是主机本身。
- IP地址是逻辑地址,与硬件地址(MAC地址)无关。
2. IP地址传输过程
通过根据默认网关的地址 + ARP协议可以查询到数据链路层的MAC地址,
在数据链路层,有了MAC地址就可以把数据传输到下一个路由器/交换机/。
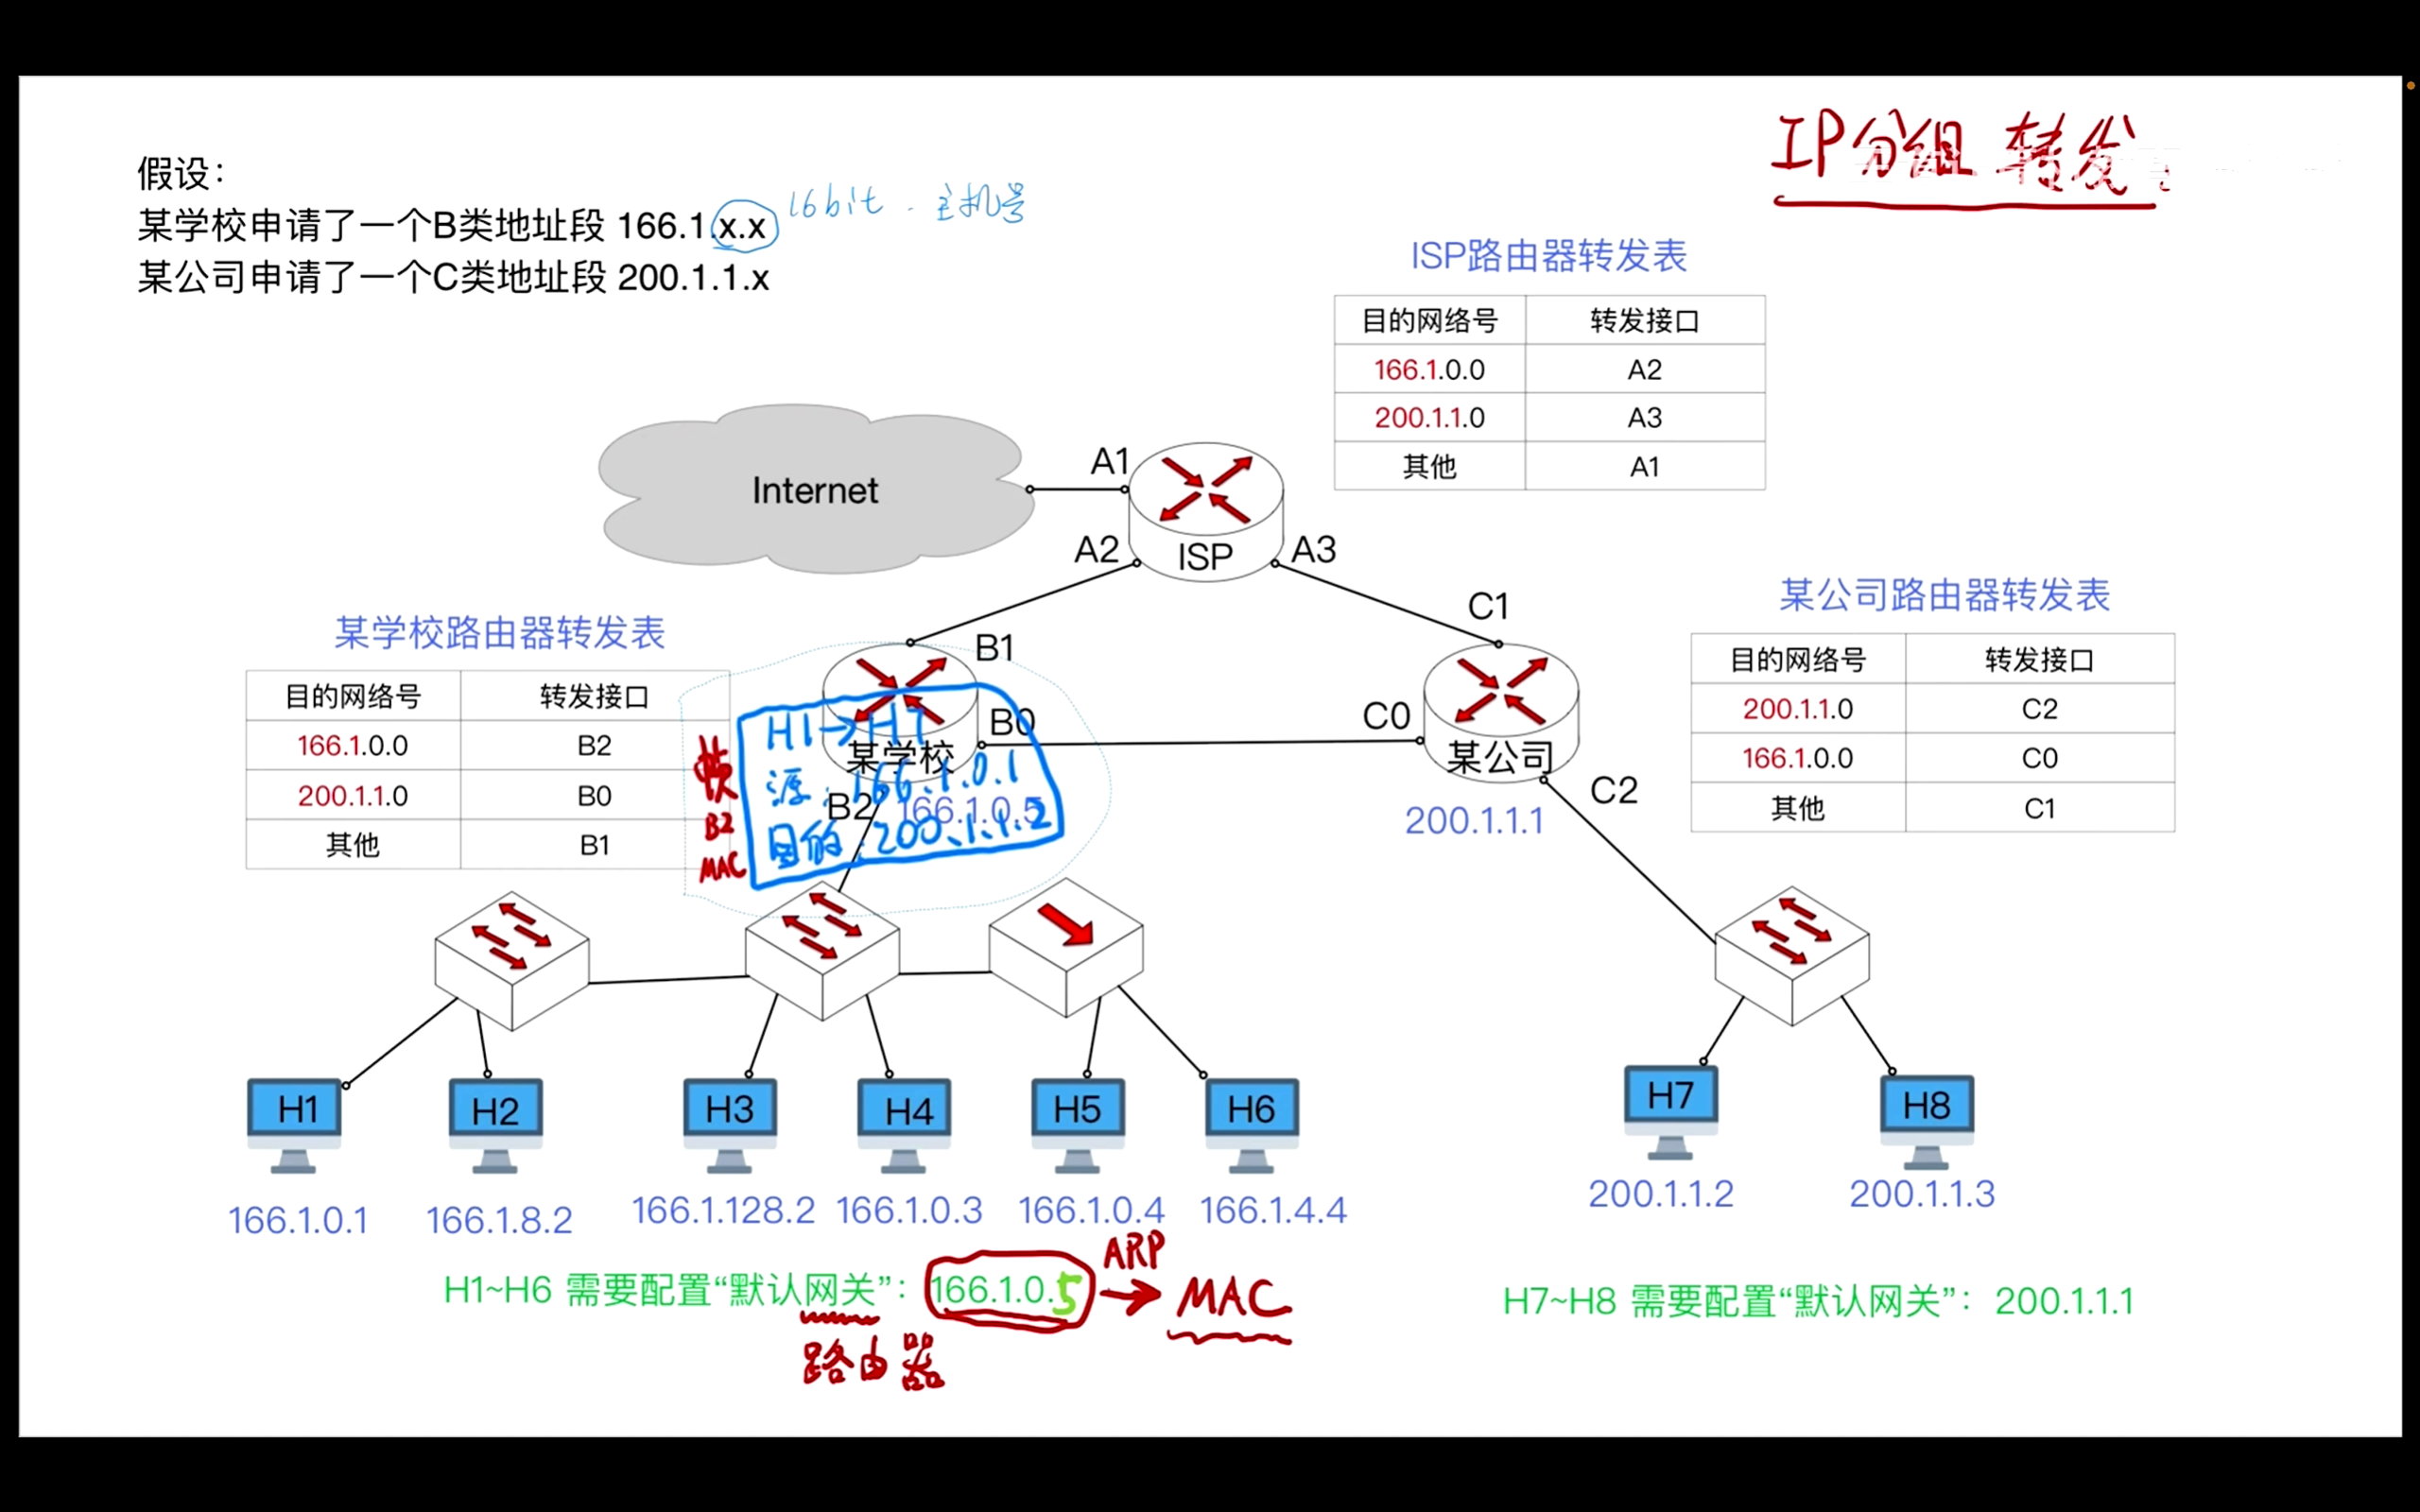
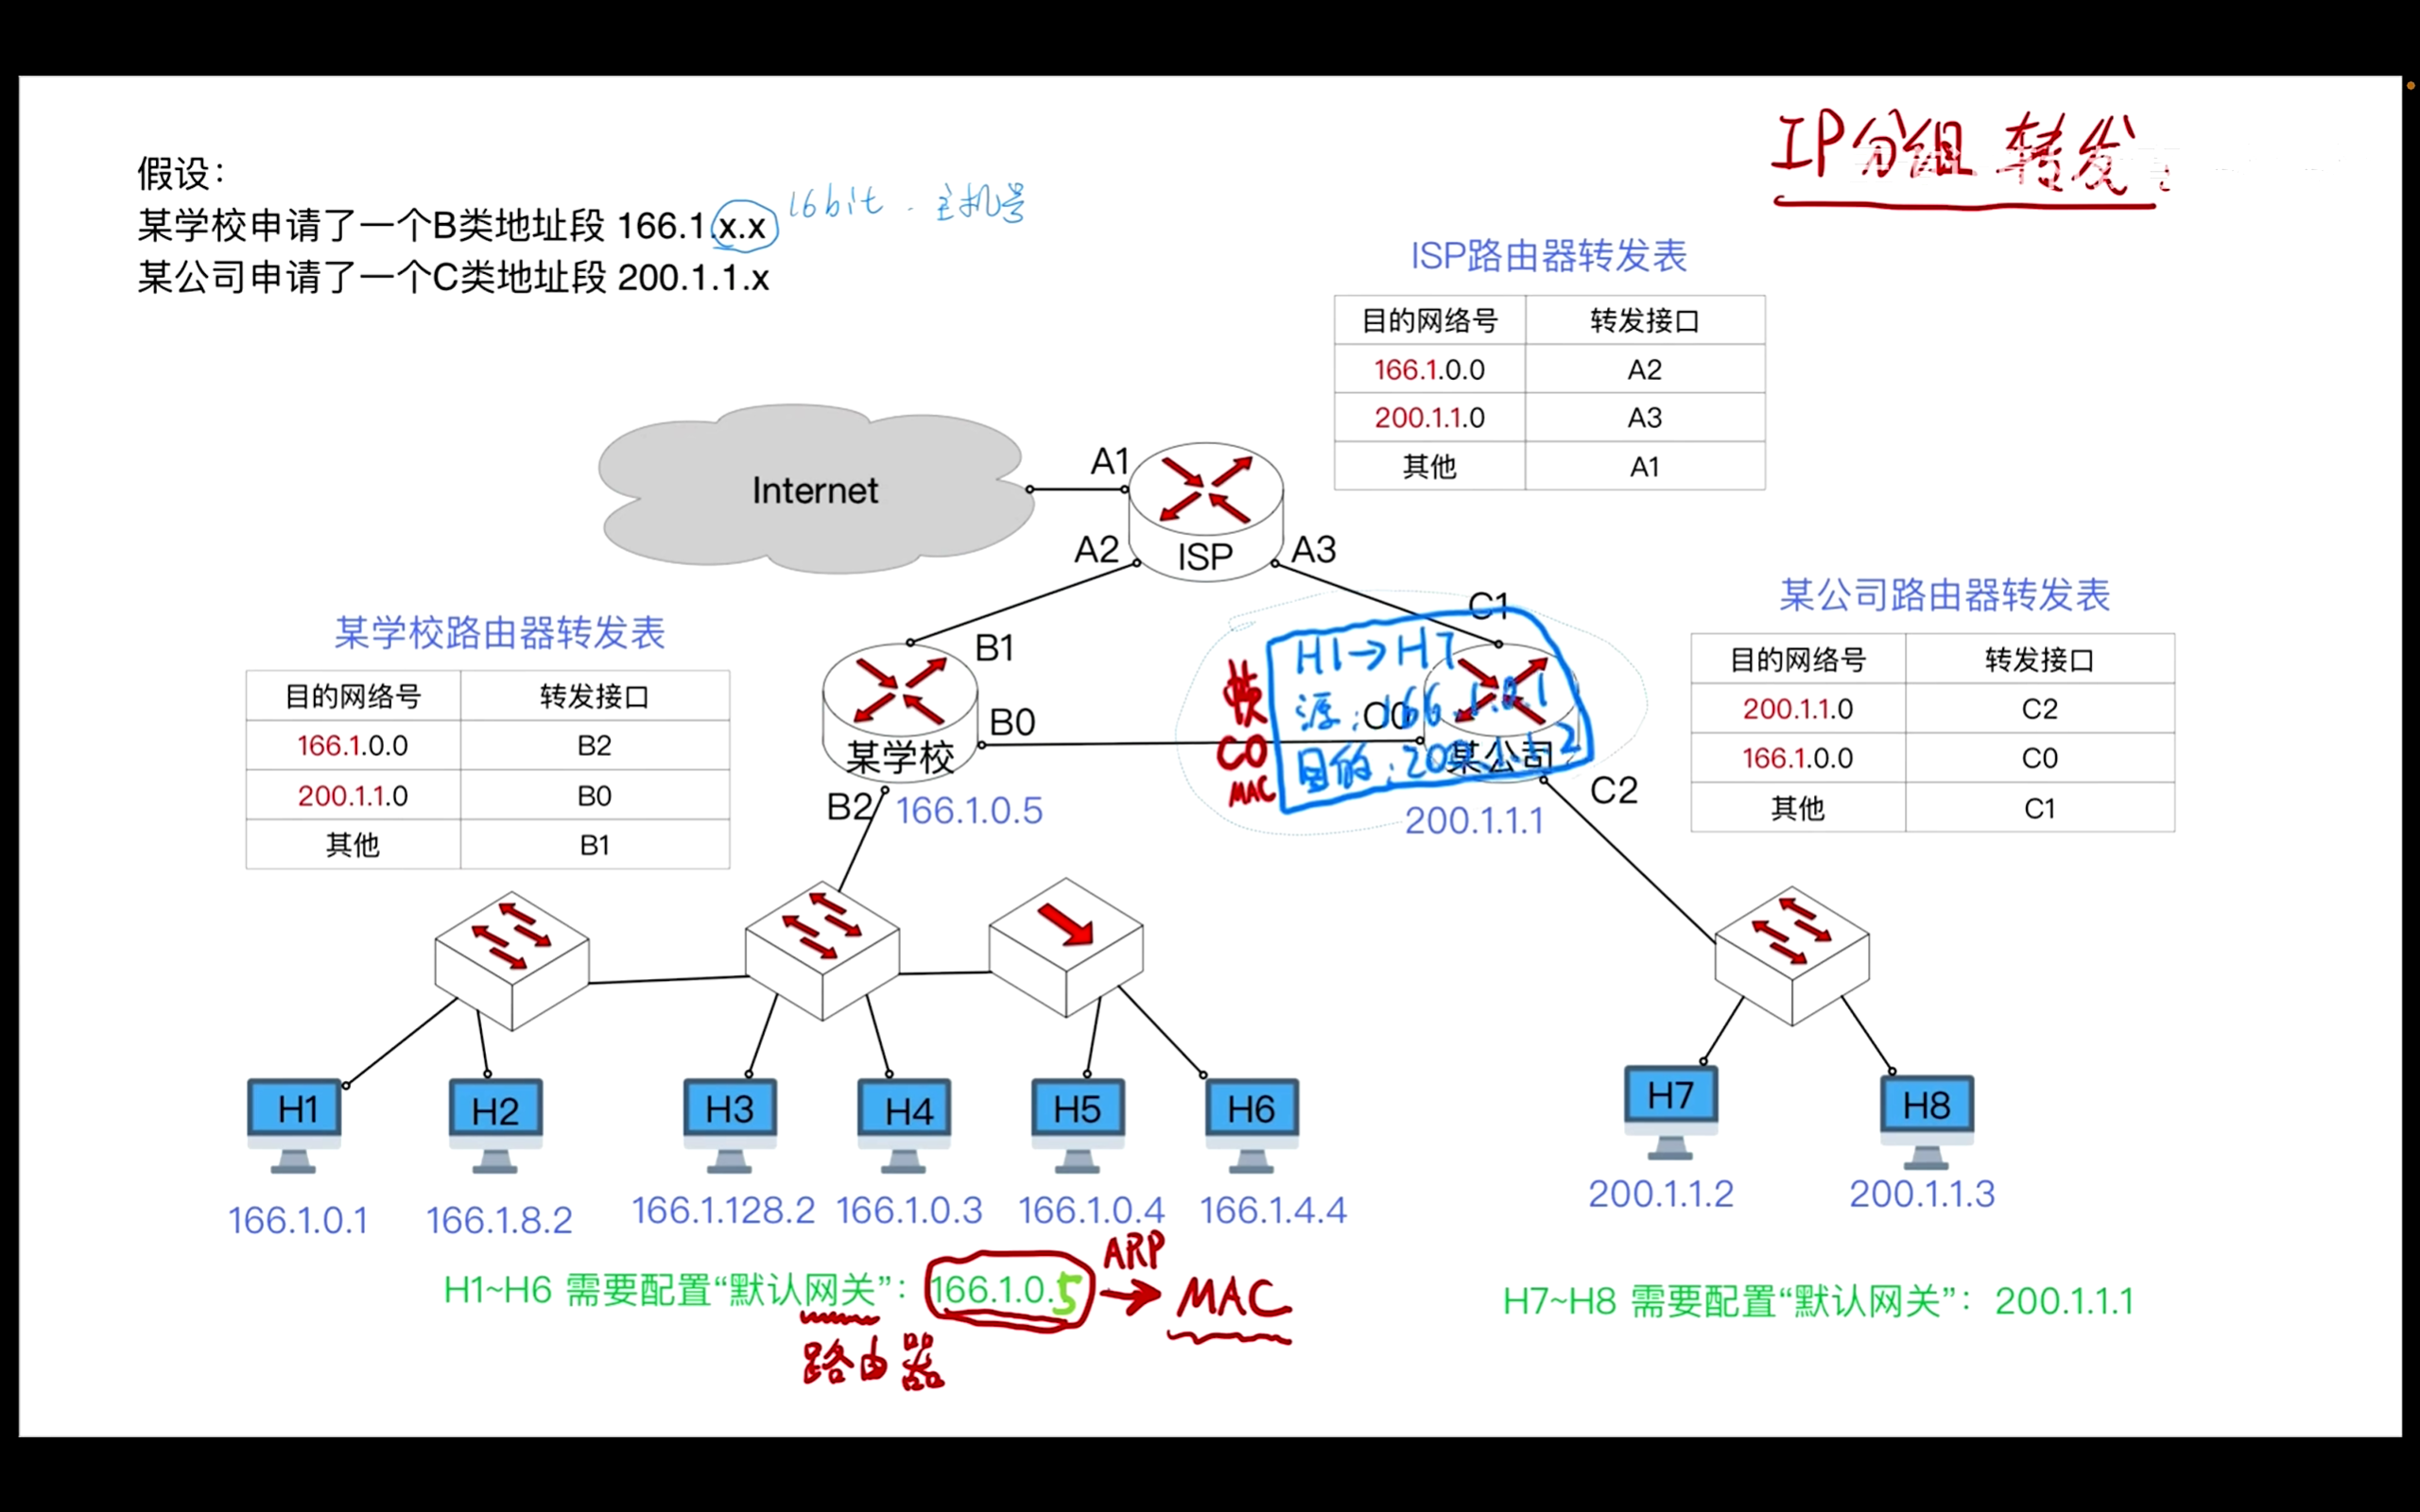
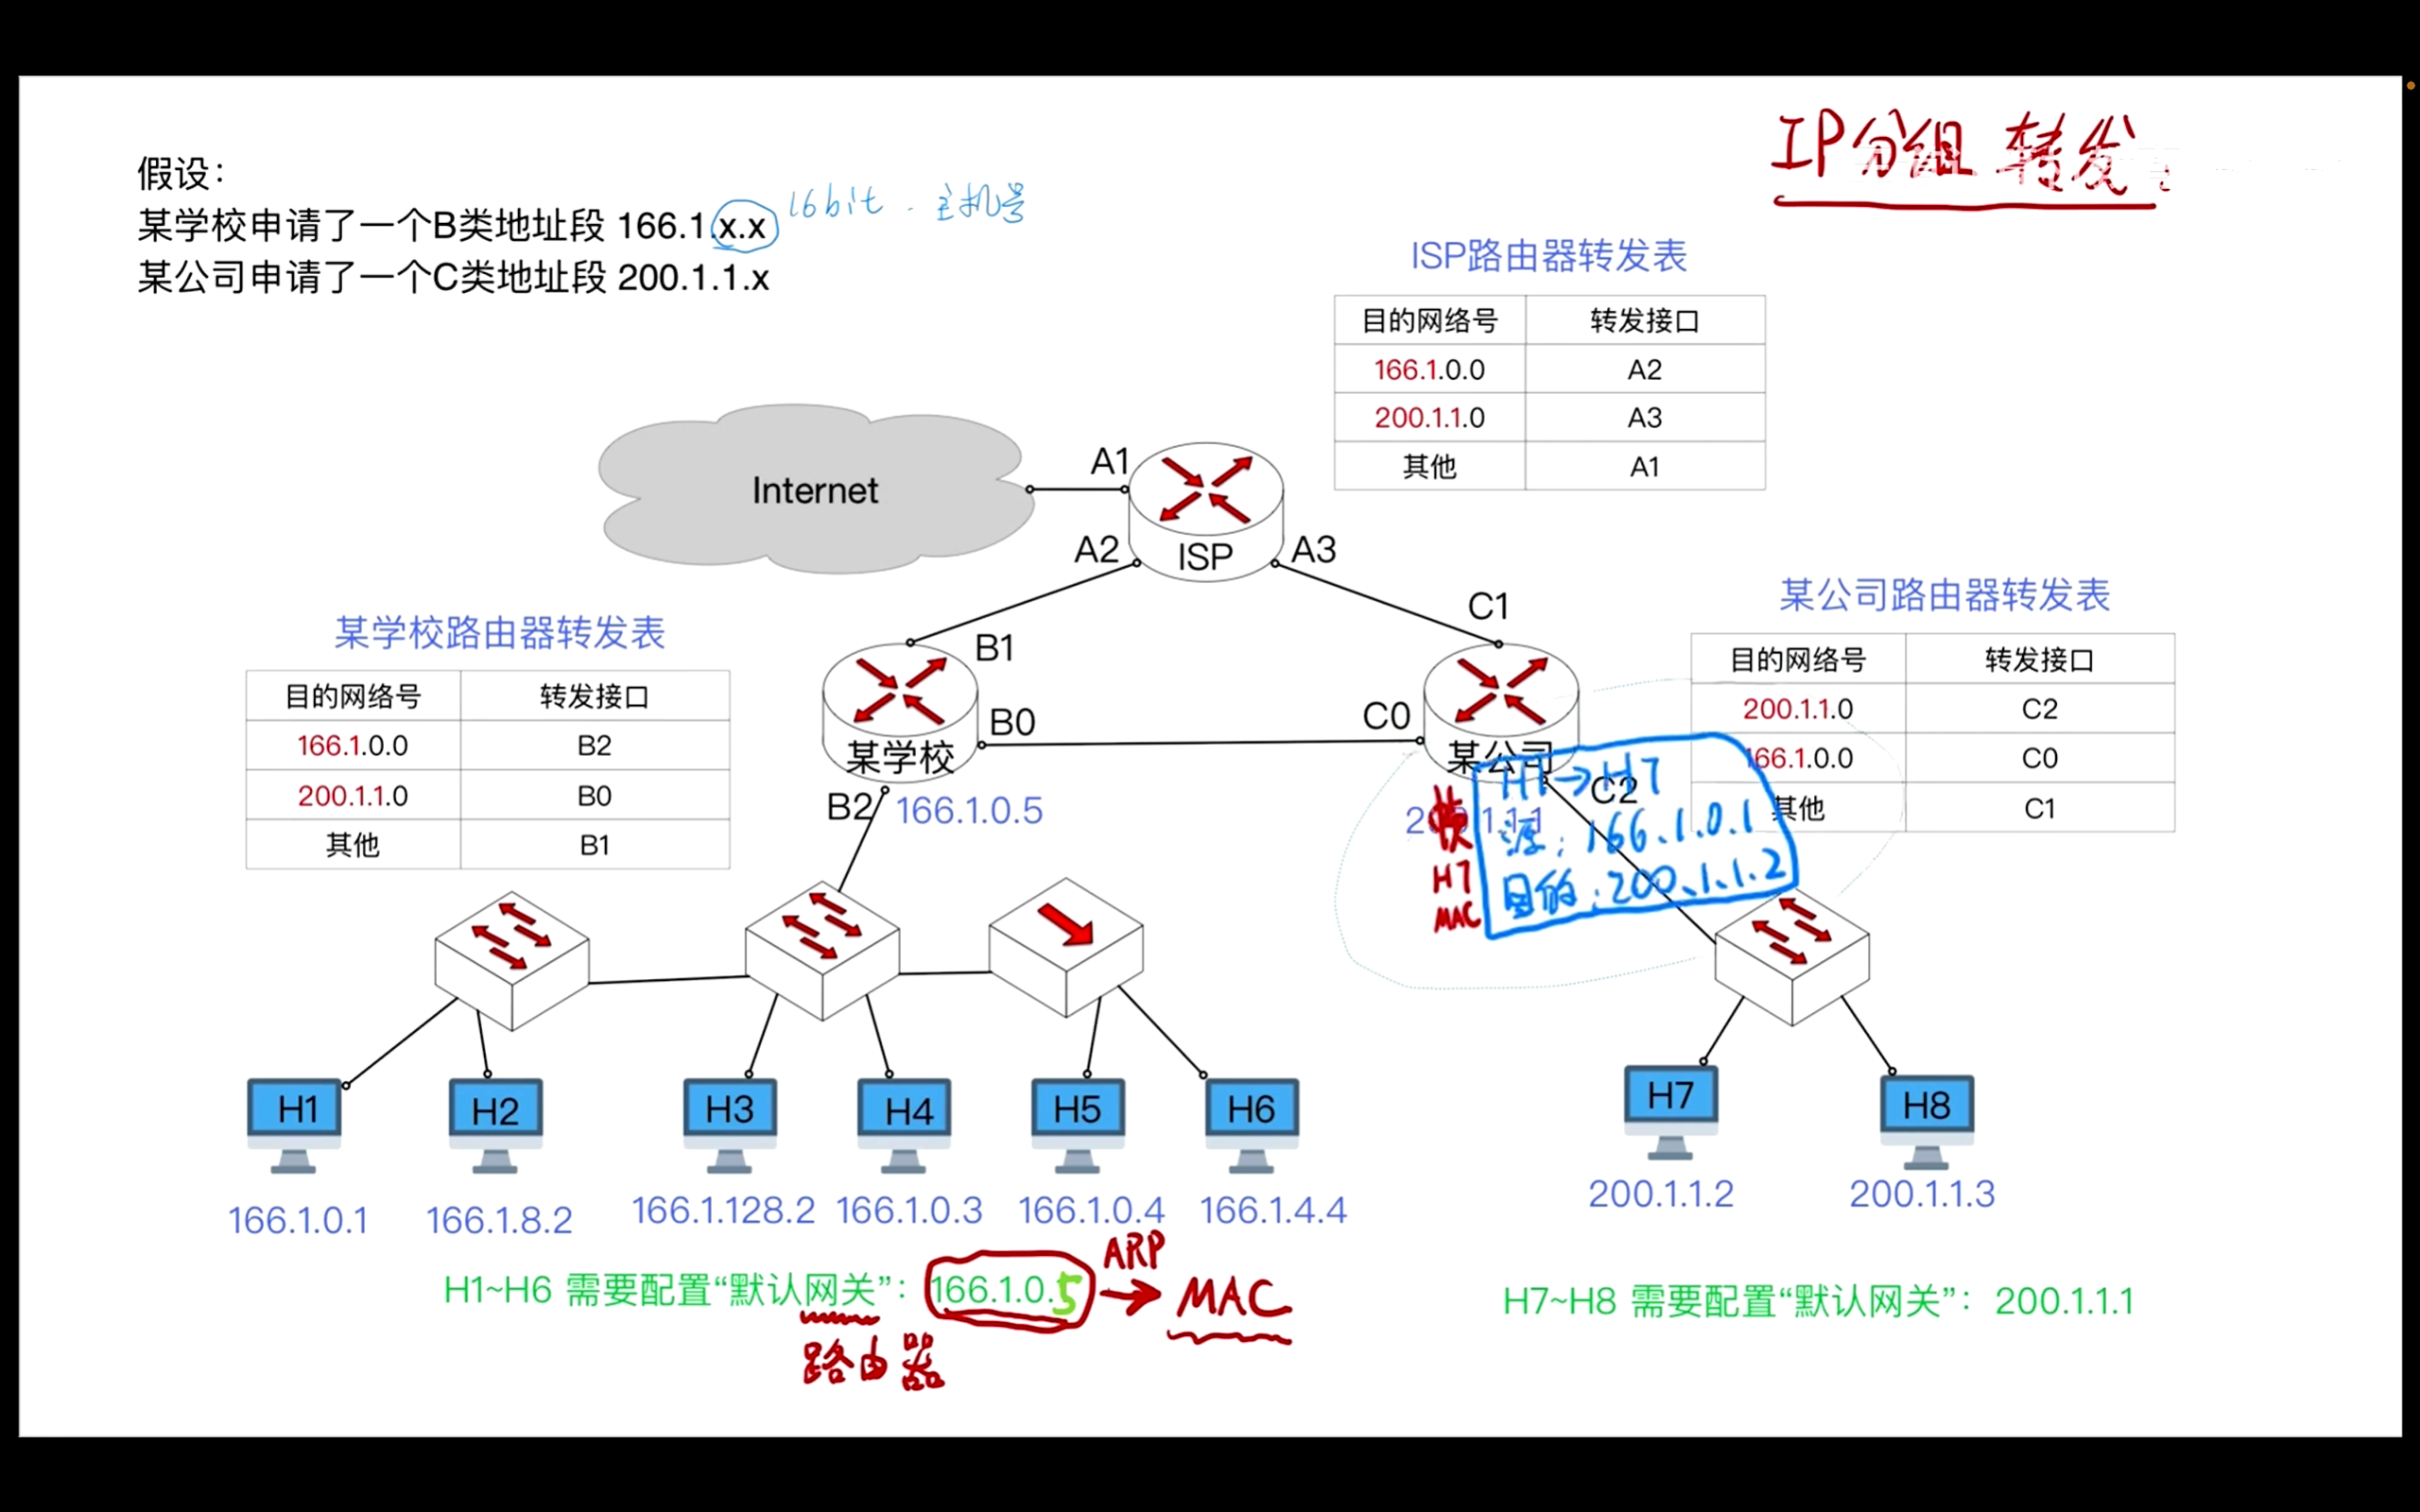
过程中:目的ip地址没变化,但是目的mac地址是一直在变的。
ARP协议根据IP地址查到MAC地址
内部网络中传送IP数据报不需要默认网关
⭐3. 一些特殊用途的IP地址
Nbit主机号,最多支持2^N -2台主机/路由器(主机号全0/1不能用)
Nbit子网号,最多支持2^N个子网
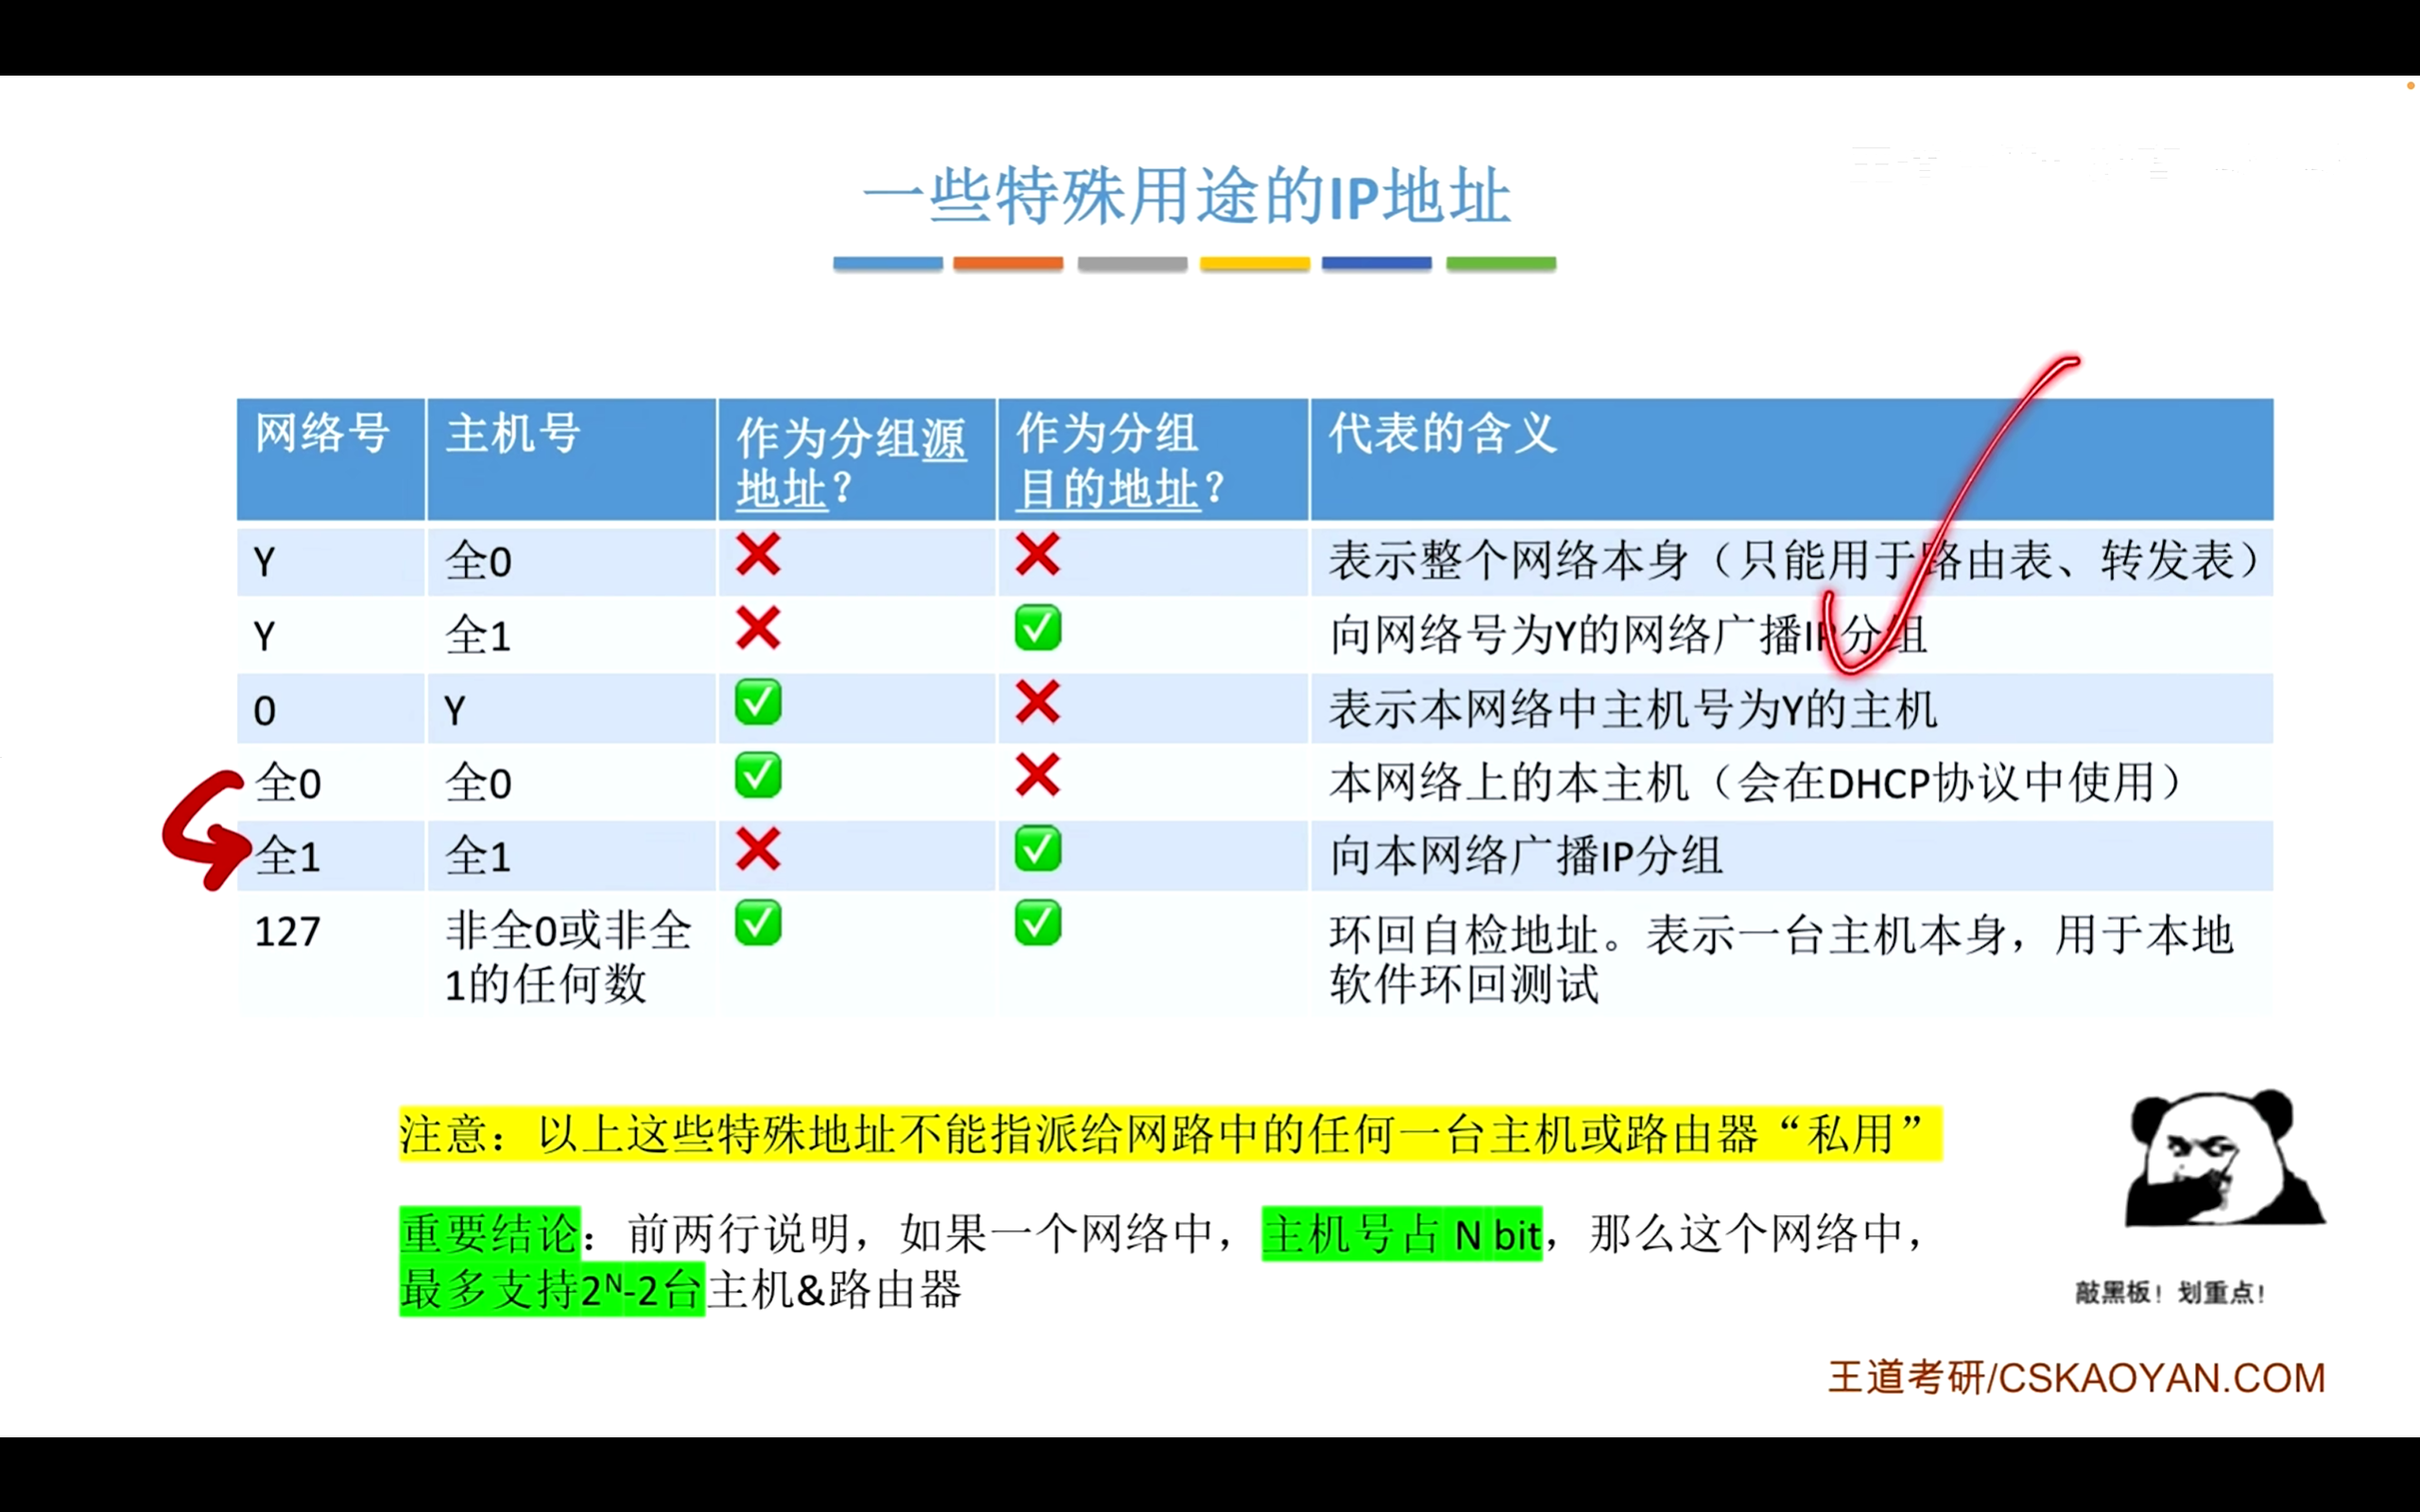
注:以上这些特殊地址不能分派给网络中任何一台主机或路由器私用。
127.xxx,用来环回自检。所以既可以作为源IP地址,也可以作为目的IP地址。
③ 子网划分,子网掩码
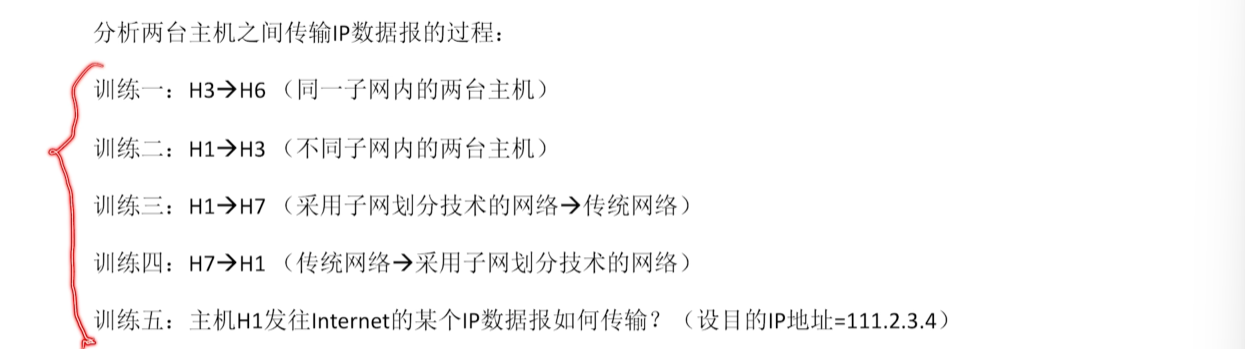
画图训练
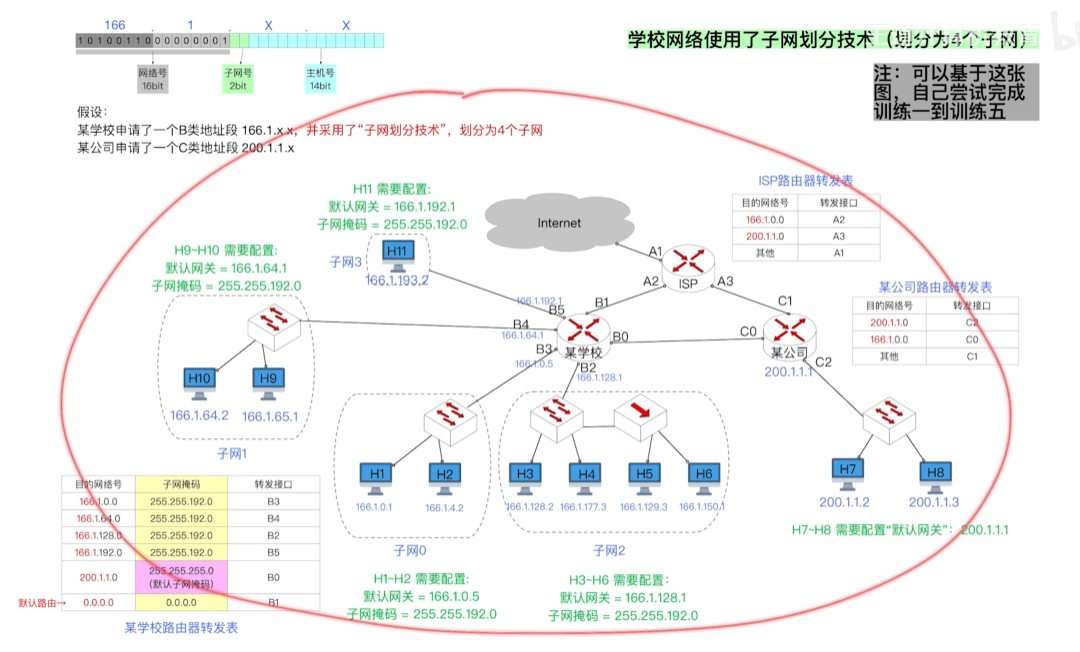
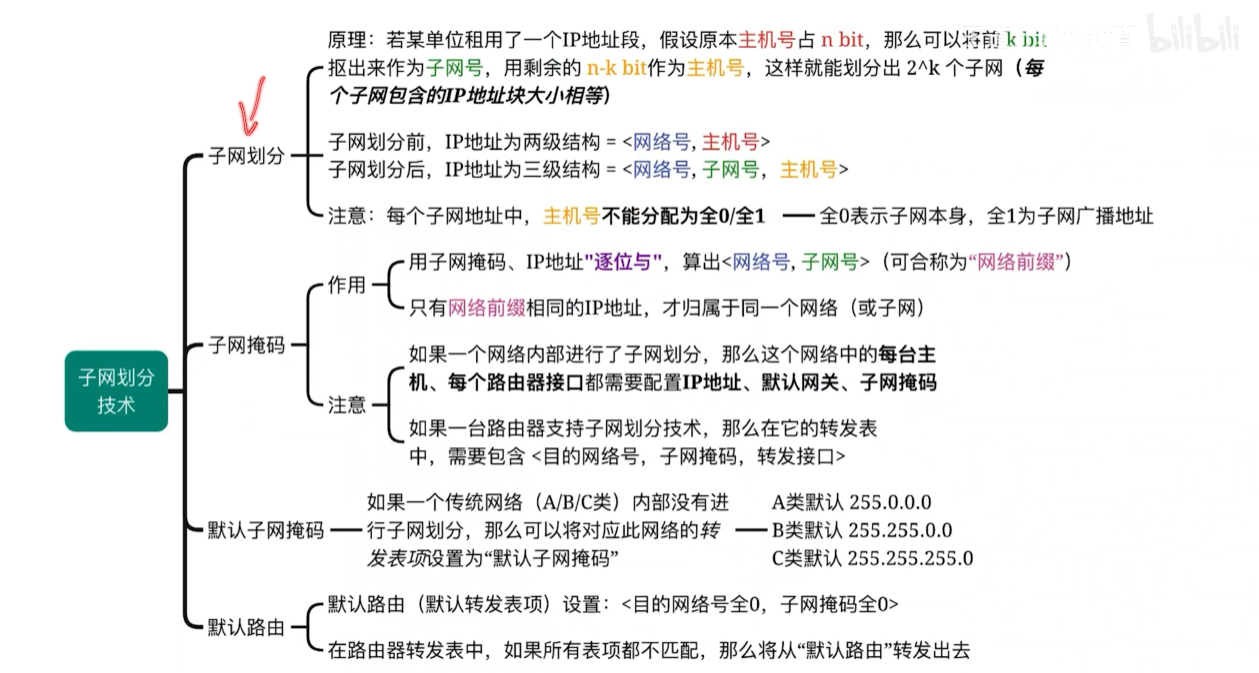
a.子网划分
==主机号分成:子网号+主机号==
(like一个学校多个校区,一个校区一个子网)
b.子网掩码
前提:网络号和子网号完全相同的IP地址才属于**==同一个(子)网络==**
子网掩码 和 IP地址(自己的/对面的) **==相与==**(与运算:1 1→1,别的都是0),
- 得到:网络号+子网号(call:==网络前缀==)
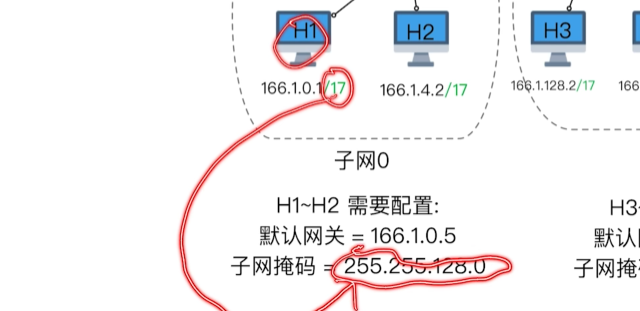
子网掩码的另一种记法
(17的意思是前面17个比特全1,后面的全0)
(这种方法一看就知道使用了子网掩码)
c.默认子网掩码和默认路由
默认子网掩码
如果一个网络(ABC类)内部还没有进行子网划分,那么可以 将对应此网络的转发表项设置为 “默认子网掩码”
- A类默认 255.0.0.0
- B类默认 255.255.0.0
- C类默认 255.255.255.0
默认路由
目的网络号全0,子网掩码全0。
路由器没找到别的转发口时,也肯定在(转发往上一级的)默认路由器转发出去的。
- (但是不要轻易就往默认路由器转发,而是确认每个选项都不满足再转向默认路由器)
⭐回顾
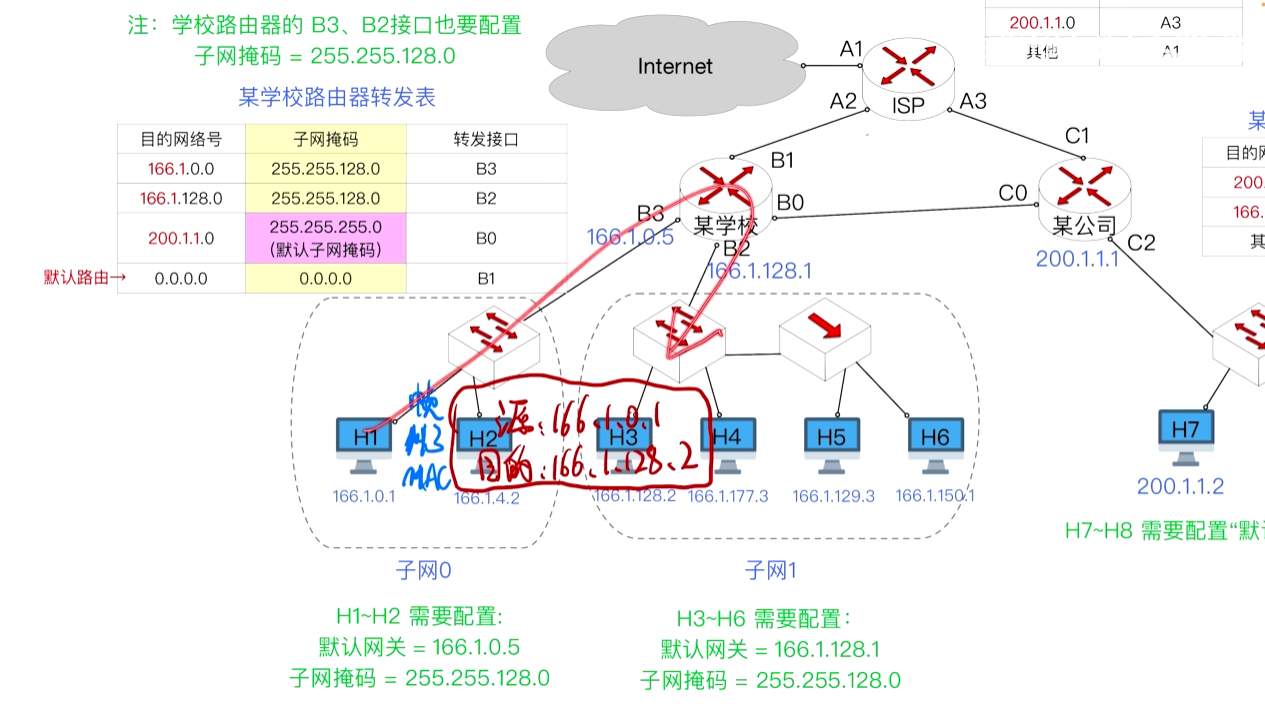
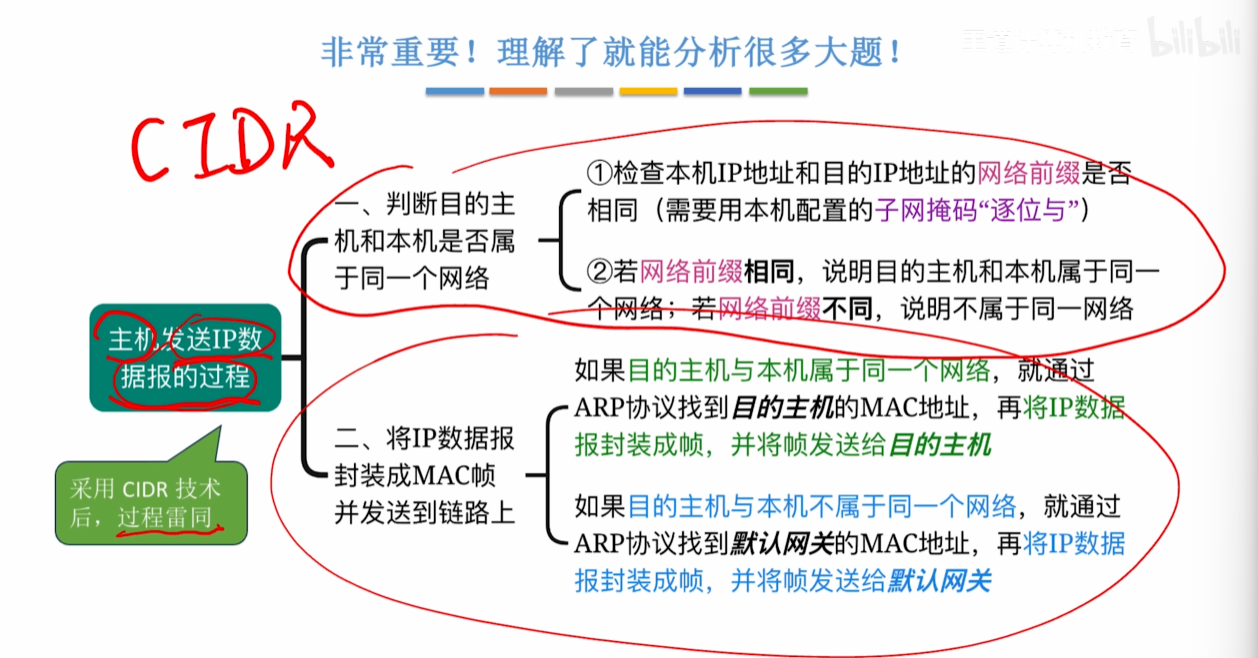
⭐总结:主机 发送 IP数据报过程
- ① 判断目的主机和本机是否属于同一个网络。
- A.检查本机IP地址和目的IP地址的网络前缀是否相同(通过目的IP地址和本机子网掩码 “逐位与”得到目的IP地址的网络前缀)
- B.若 网络前缀相同,说明目的主机和本机属于同一个网络。若 网络前缀不同,说明不属于同一网络。
- ② 将IP数据报封装成MAC帧并发送到链路上。
- A.如果目的主机与本机 属于 同一个网络,就通过ARP协议找到 目的主机 的MAC地址,再将IP数据报封装成帧,并将帧发送给目的主机。(帧→默认网关→……→目的主机)
- B.如果目的主机与本机 不属于 同一个网络,就通过ARP协议 找到 默认网关 的MAC地址,再将IP数据报封装成帧,并将帧发送给网关。(帧→目的主机
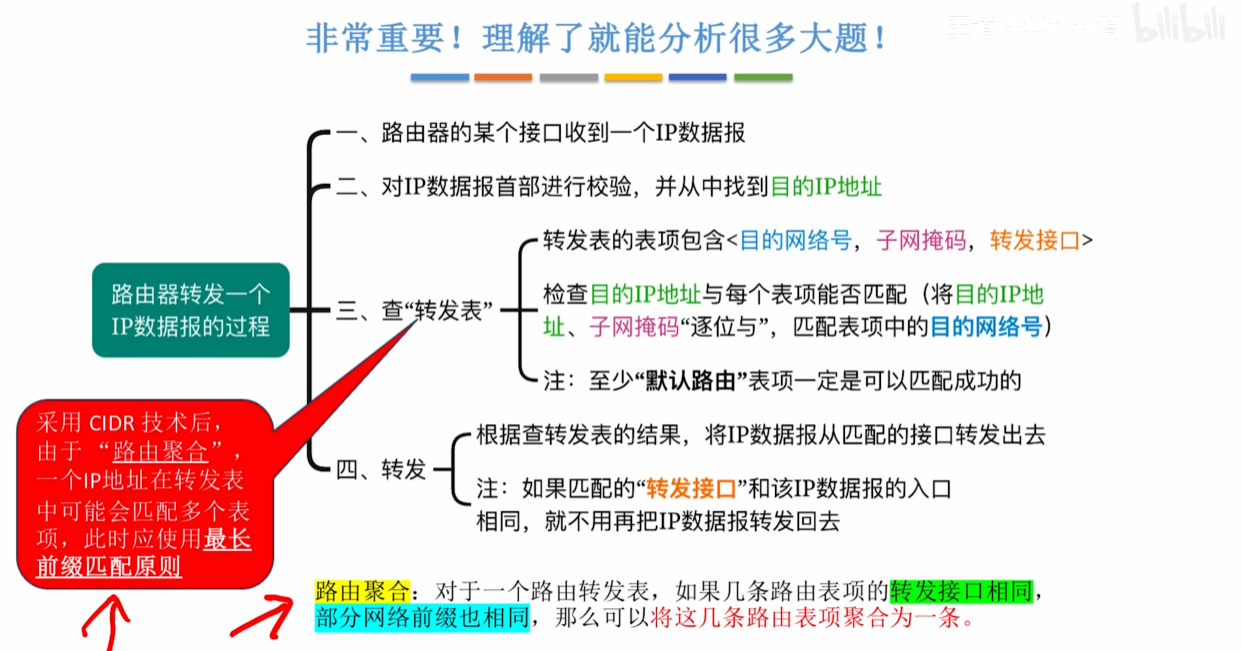
⭐总结:路由器 转发 IP数据报过程
- ① 路由器的某一个接口收到IP数据报。(路由器收到帧,把首部尾部的控制信息拆除,得到IP数据报内容,交给路由器的网络层)
- ② 对IP数据报首部进行校验,再从中找到目的IP地址。
- ③ 查 “转发表”
- 转发表的表项包含 <目的网络号,子网掩码,转发接口>
- 检查目的IP地址与每个表项能否匹配(通过目的IP地址,子网掩码的逐位与,匹配表项中的目的网络号),从而找到转发接口。
- 注:至少 “默认路由” 表项是一定可以匹配成功的。
- ④ 转发
- 根据查转发表的结果,将IP数据报从匹配的接口转发出去。
- 注:如果匹配的“转发接口”和该IP数据报的入口相同(即属于同一个局域网),就不用再把IP数据报转发出去。
④ CIDR(无分类编址)
为什么要提出CIDR:互联网在民用领域受到欢迎,由于每台主机都至少要消耗一个全球唯一的IP地址,IP地址资源越来越少
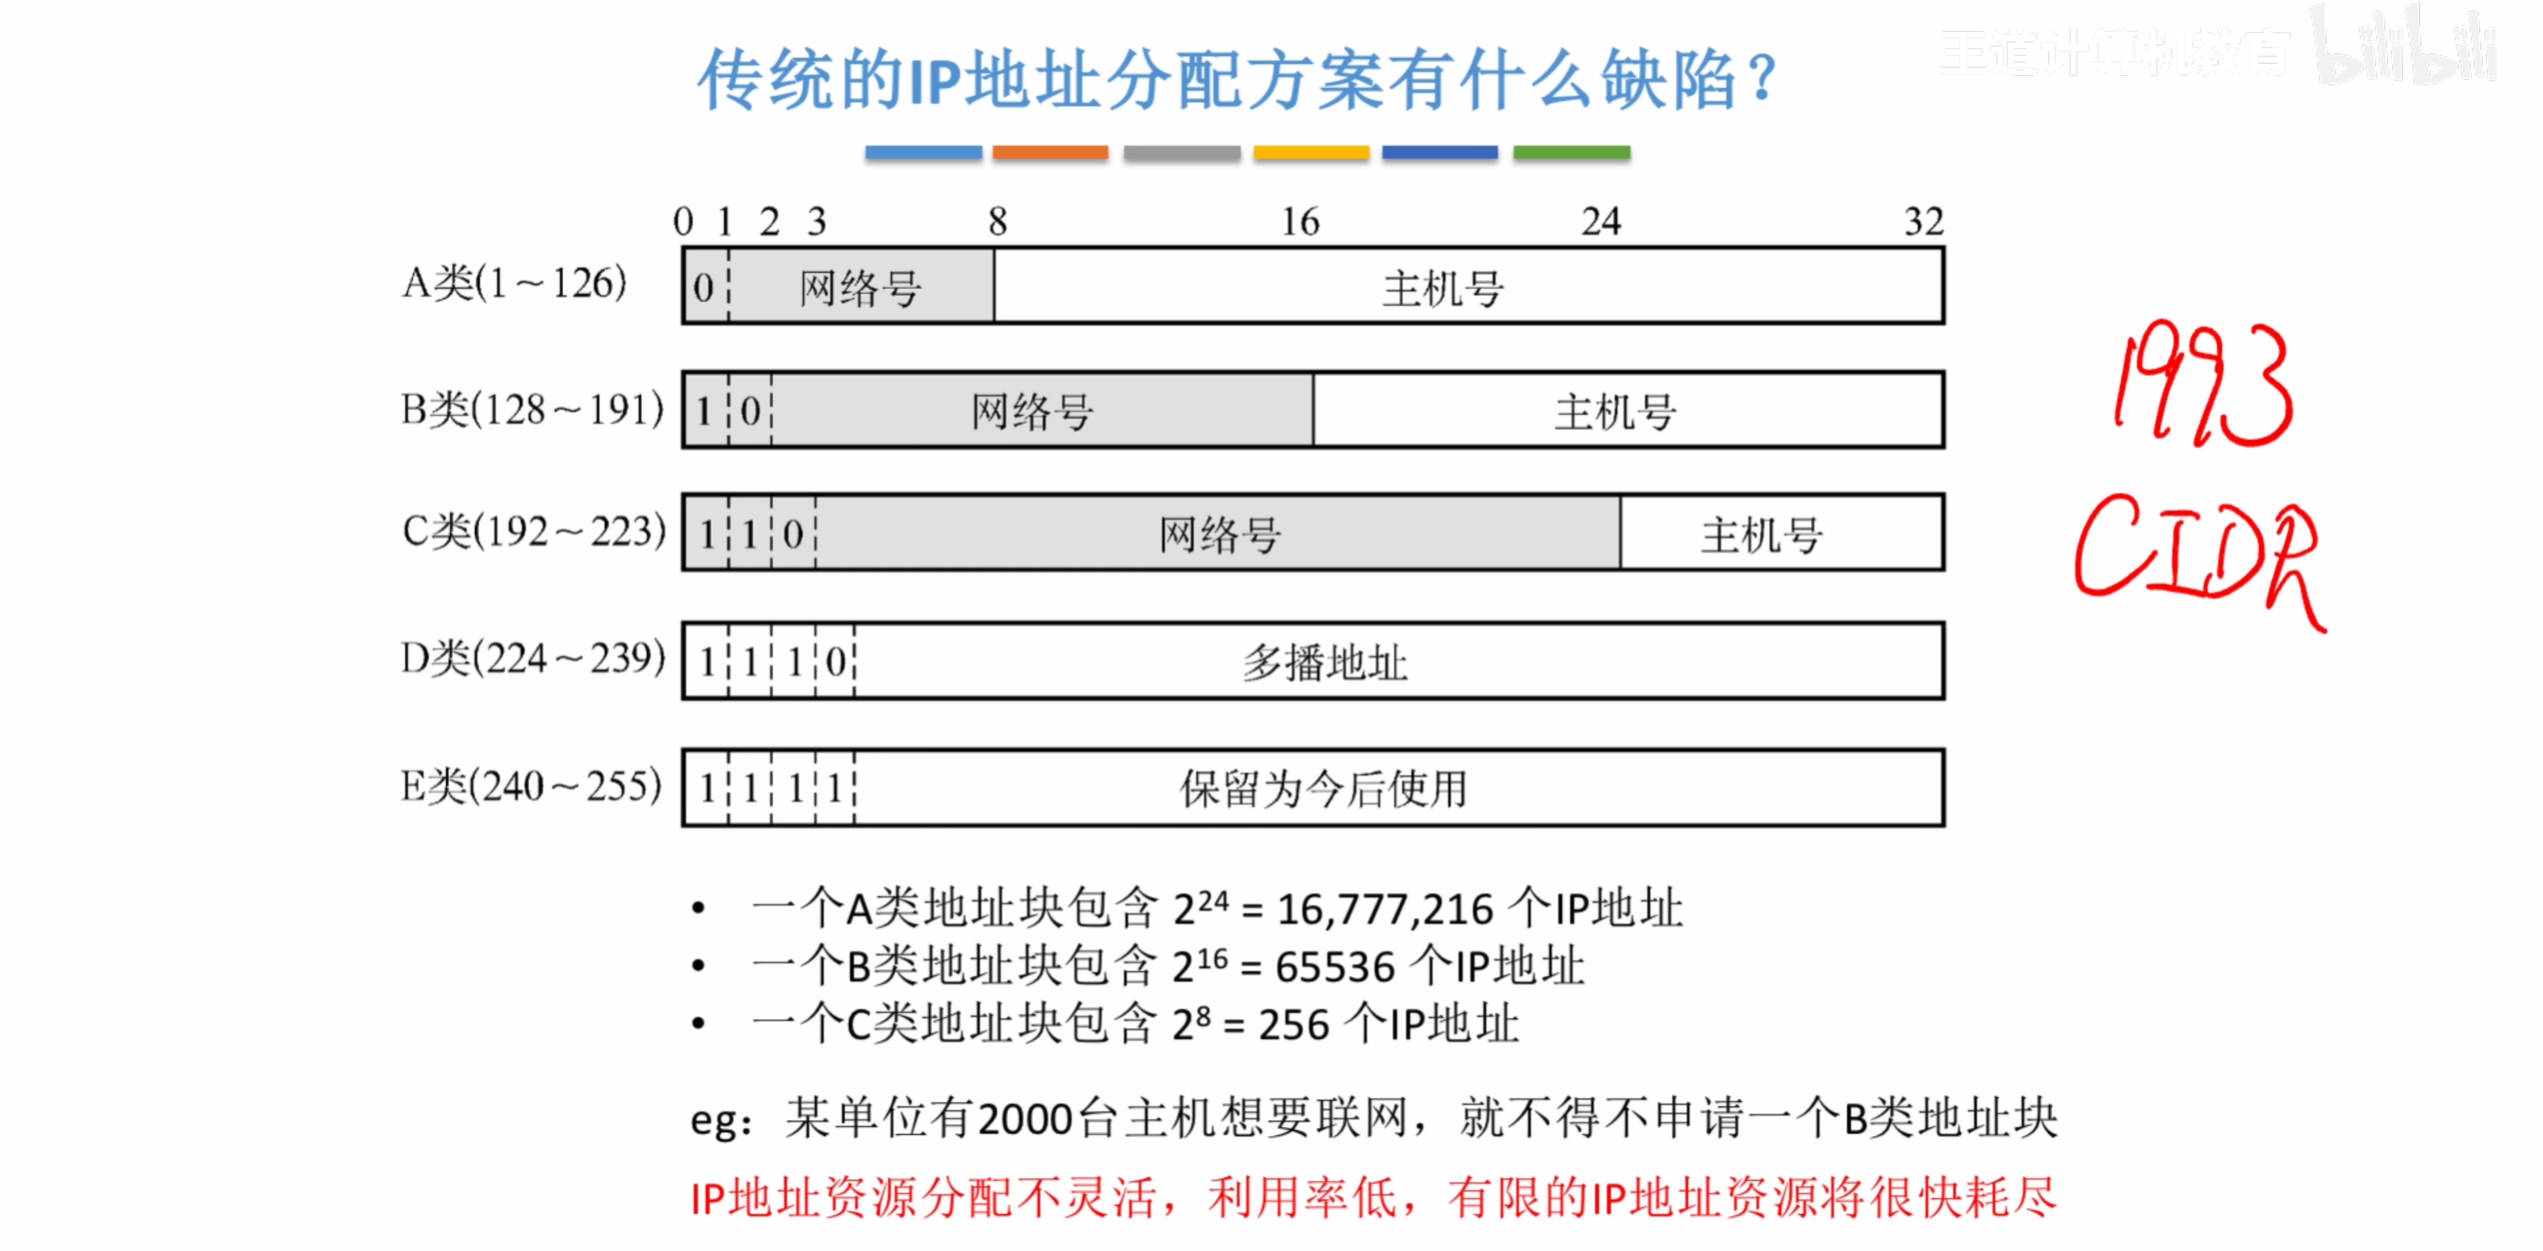
传统IP地址的缺陷
C类地址:网络号长,主机号短。一个IP地址可供给使用的主机少(不适合给大单位使用)
A类地址:网络号短,主机号长。一个IP地址可供多个主机使用(可以给大单位使用,但是容易造成浪费。)(有限的IP地址资源会很快耗尽)
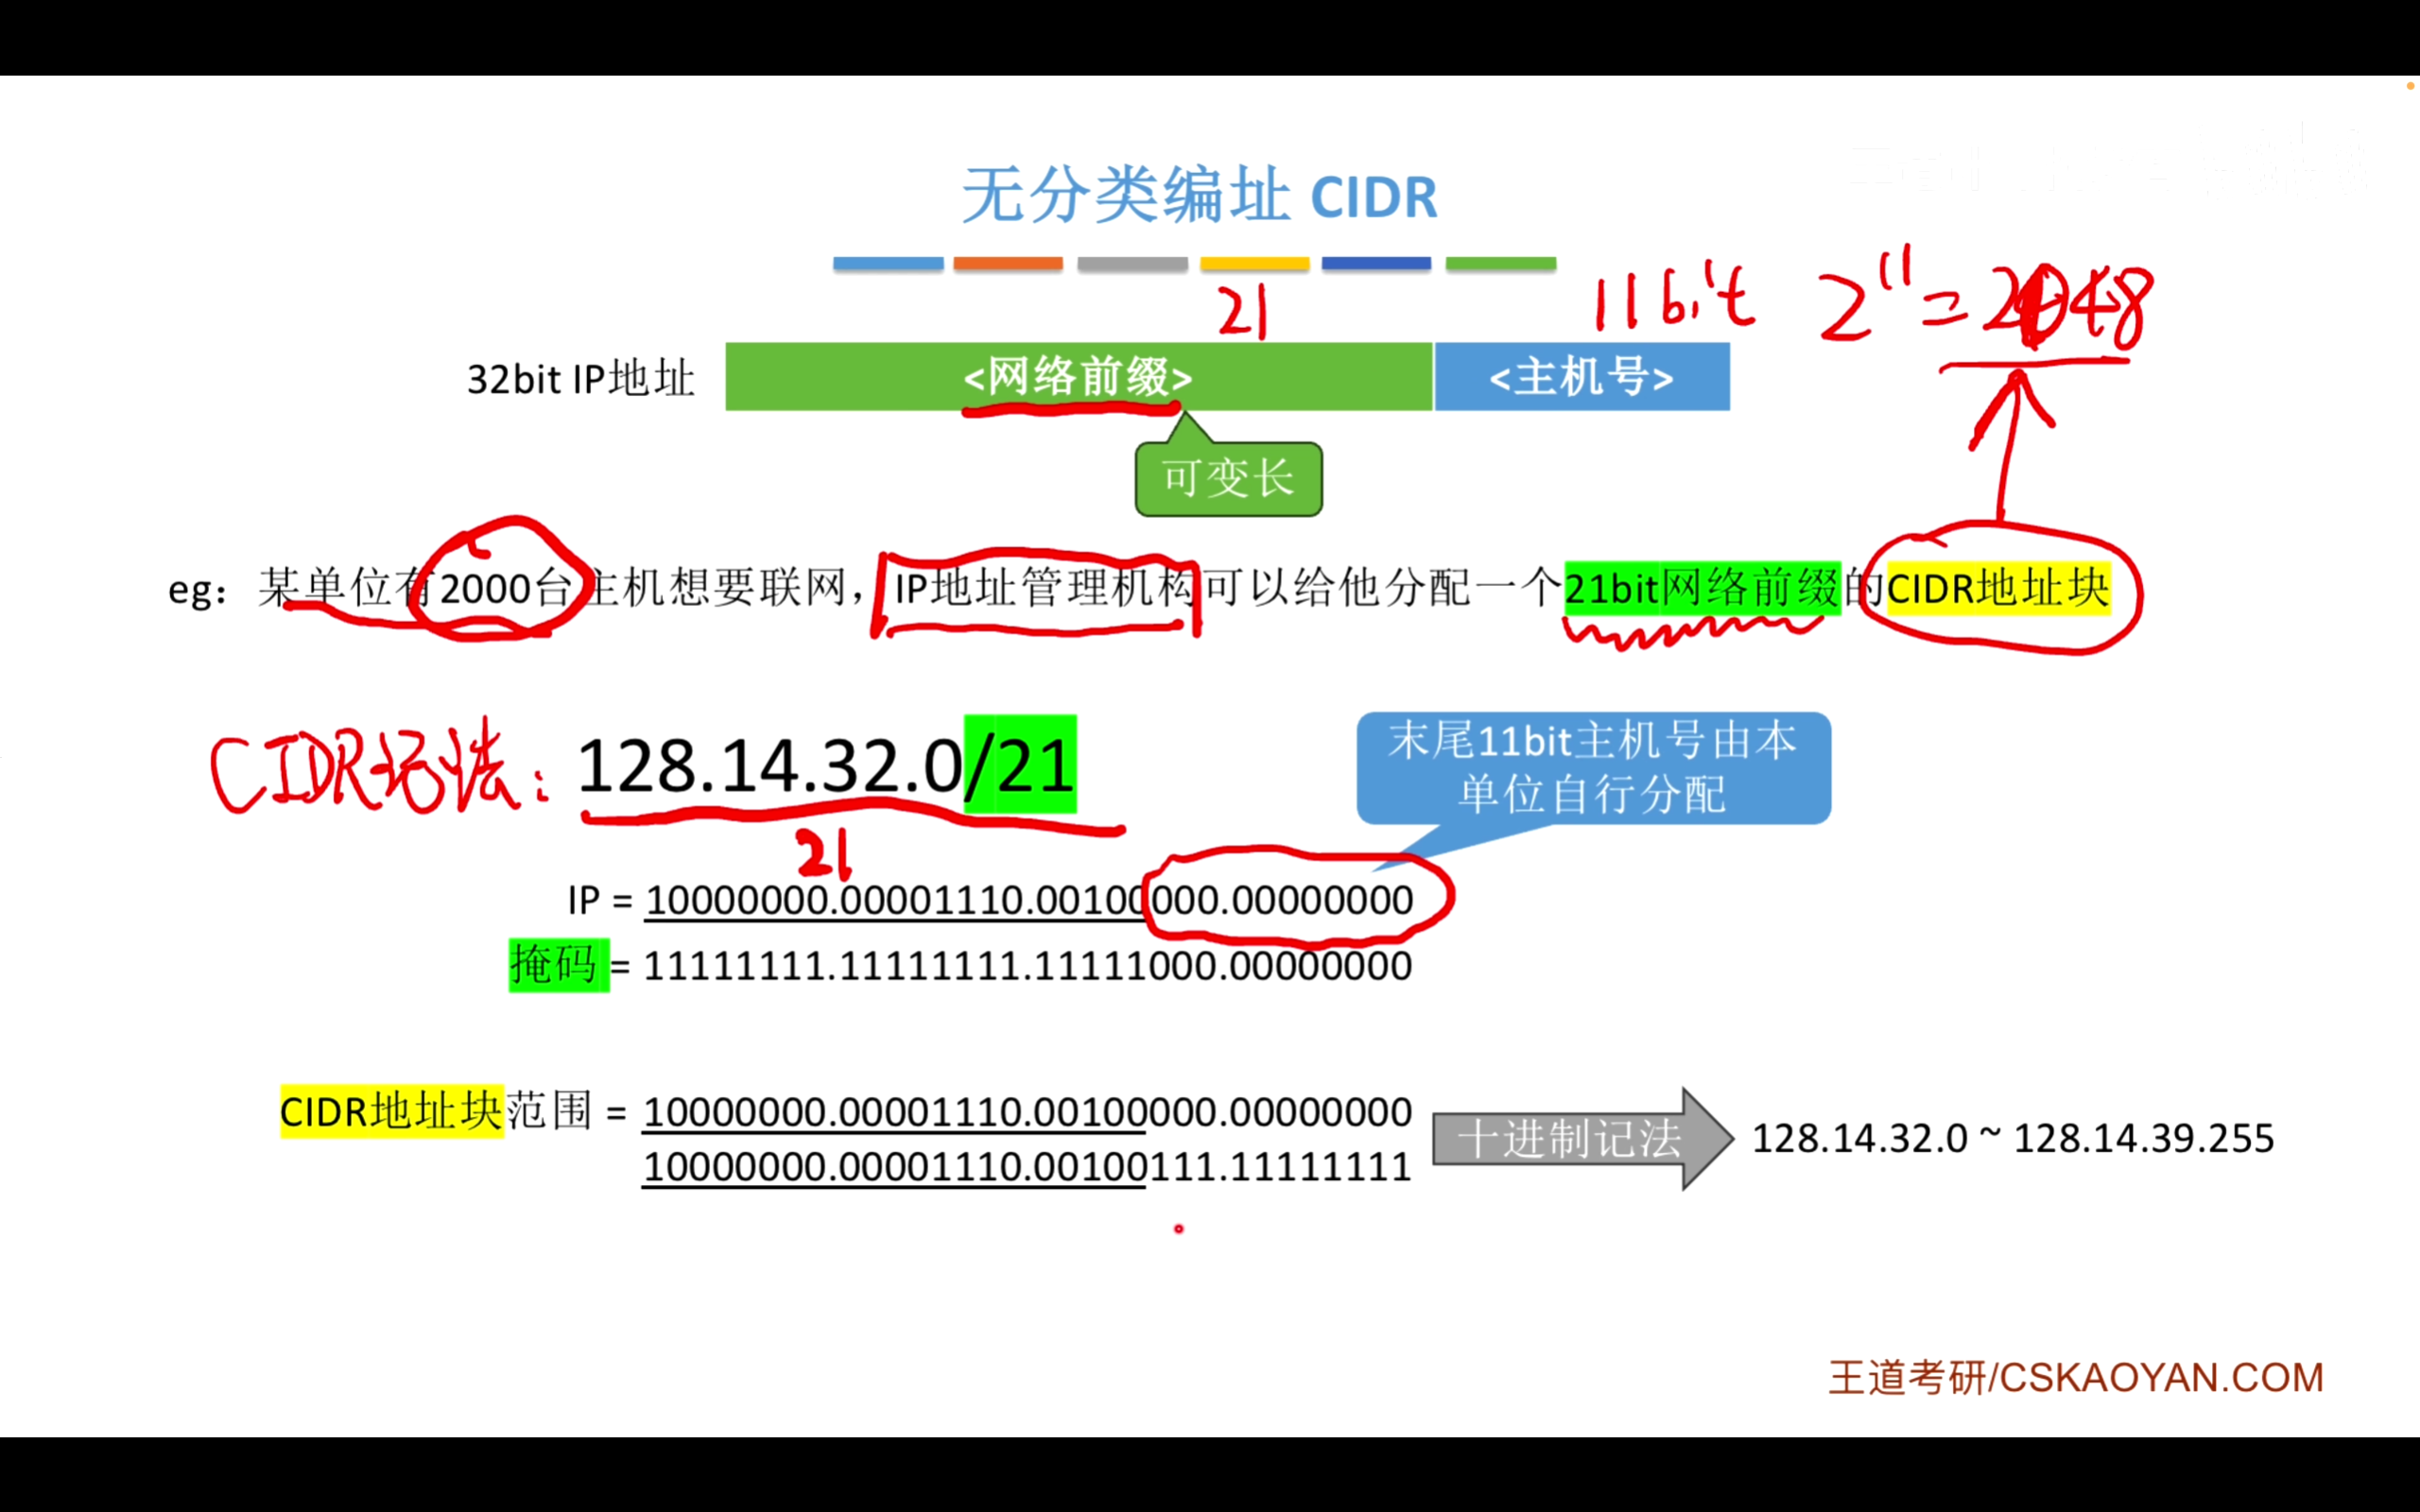
无分类编址CIDR
==网络前缀(的子网部分), 可变长!==
不再区分网络类别!用网络前缀表示网络部分。
定长子网,变长子网
一个单位获得CIDR地址块后,可以再划分多个子网。
- 定长子网划分:nbit主机号前面用kbit作为子网号。
- 缺点:每个子网都一样大,不够灵活,浪费IP地址资源。(比如不同学校校区主机数不一样多)
- ==变长子网划分==:子网号长度不固定→每个子网包含的IP地址块大小不同。
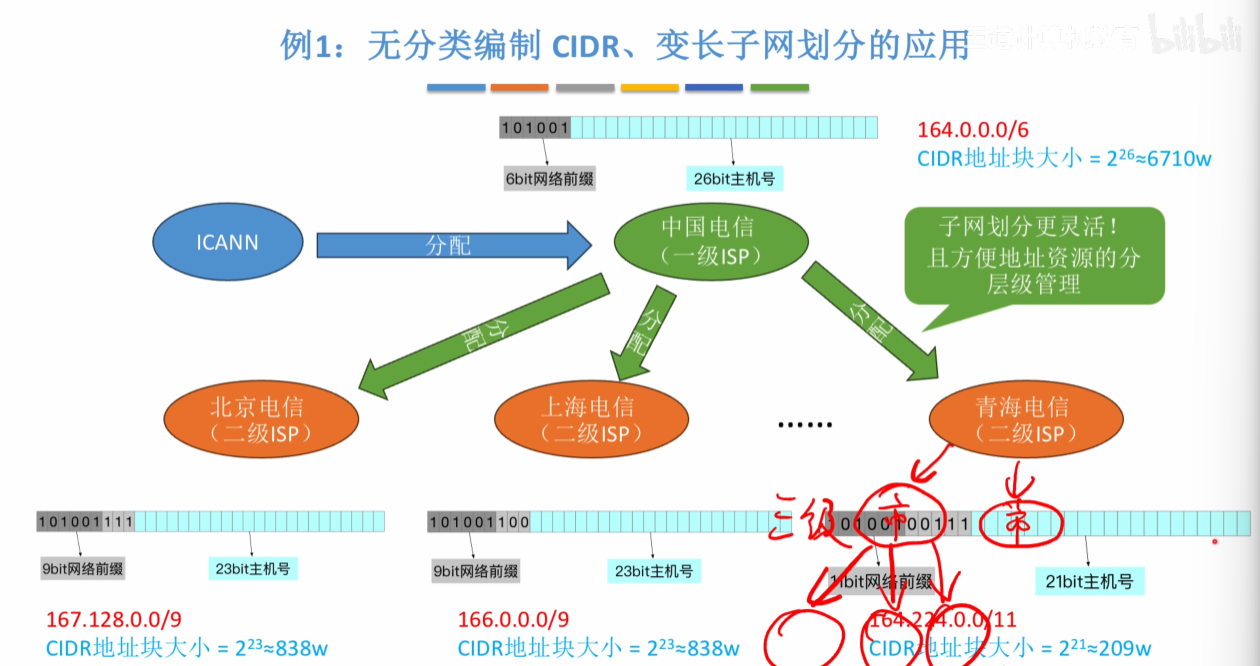
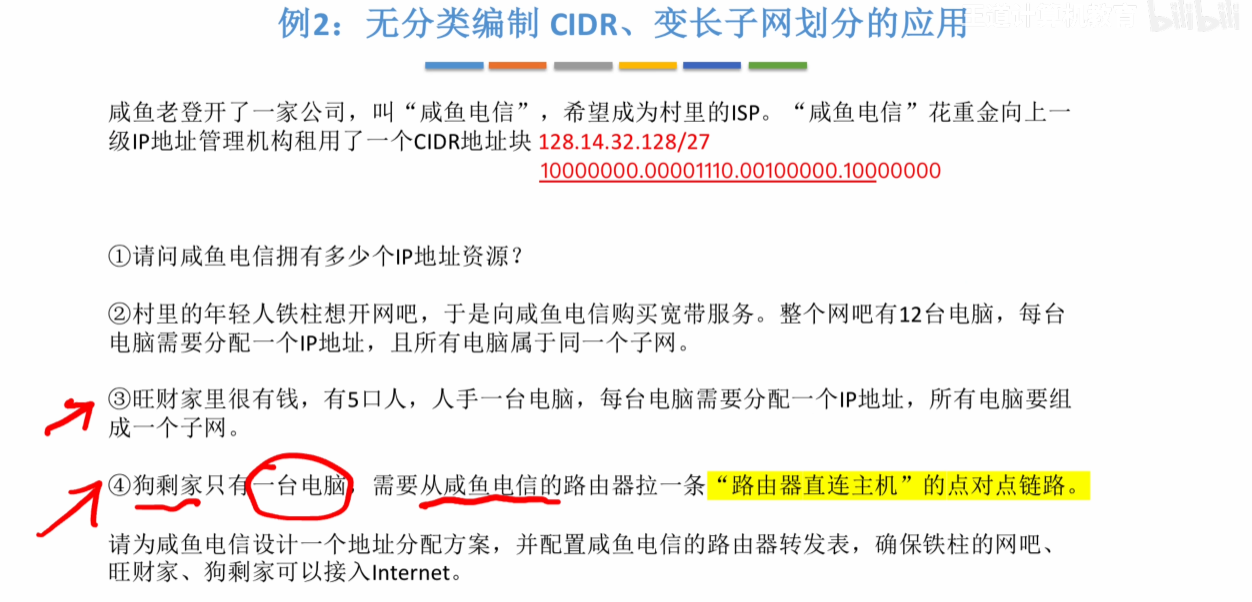
⭐
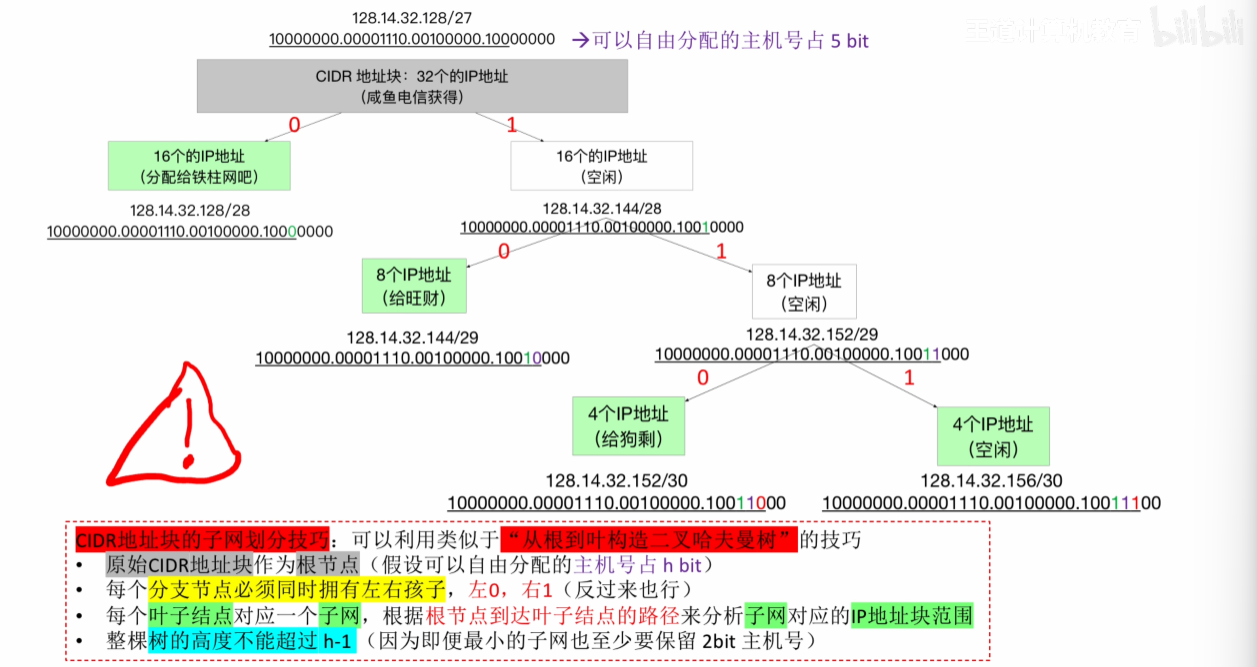
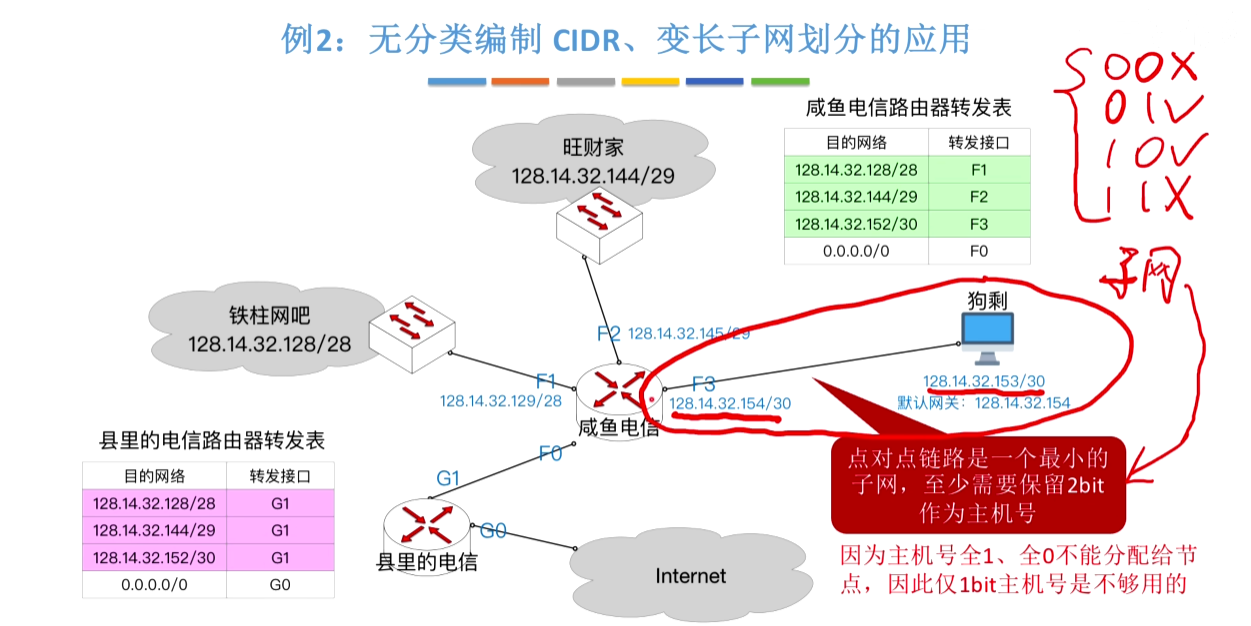
(2bit,实际可用的只有两个而不是四个)
例题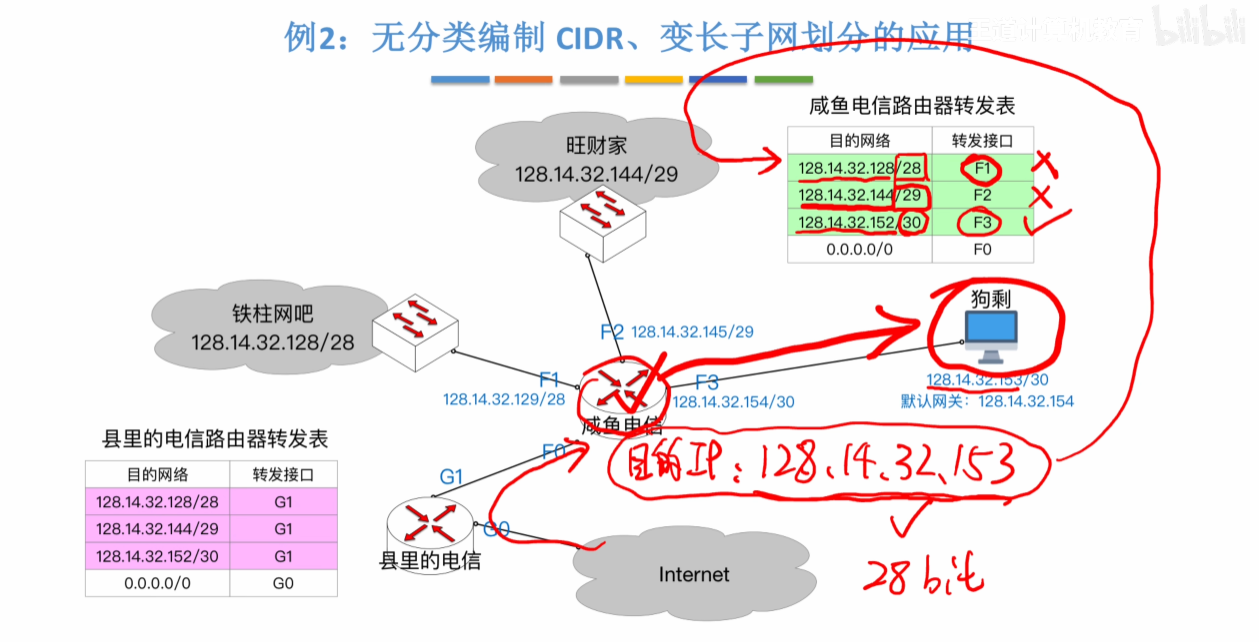
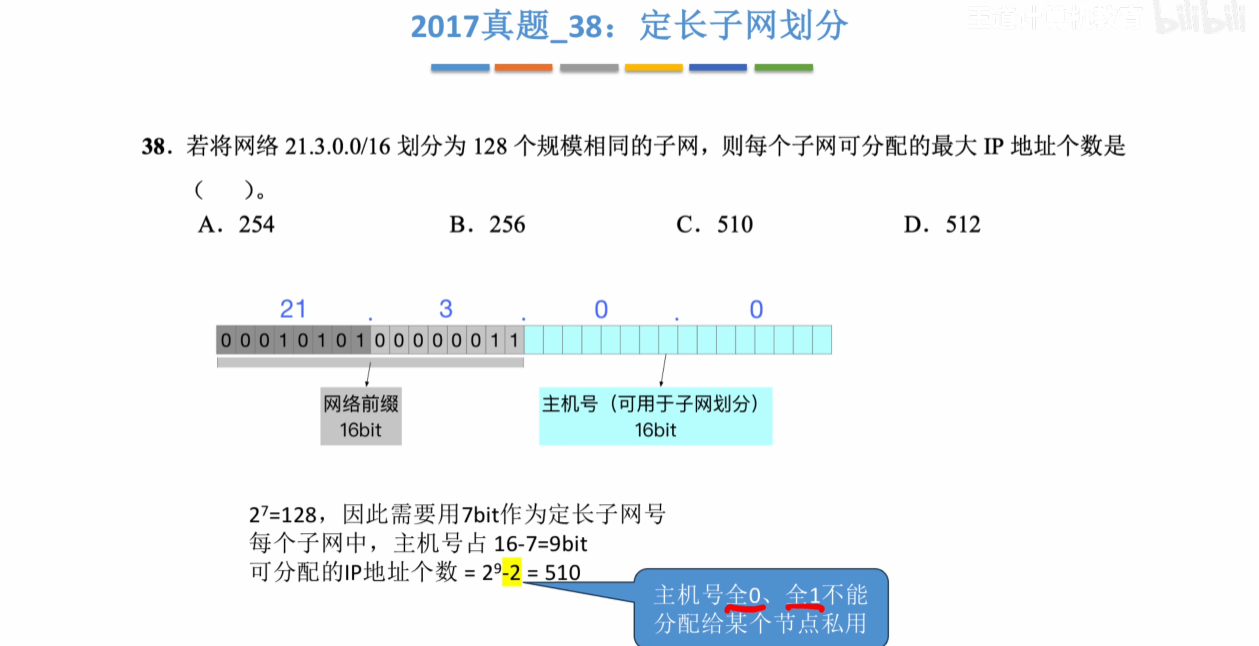
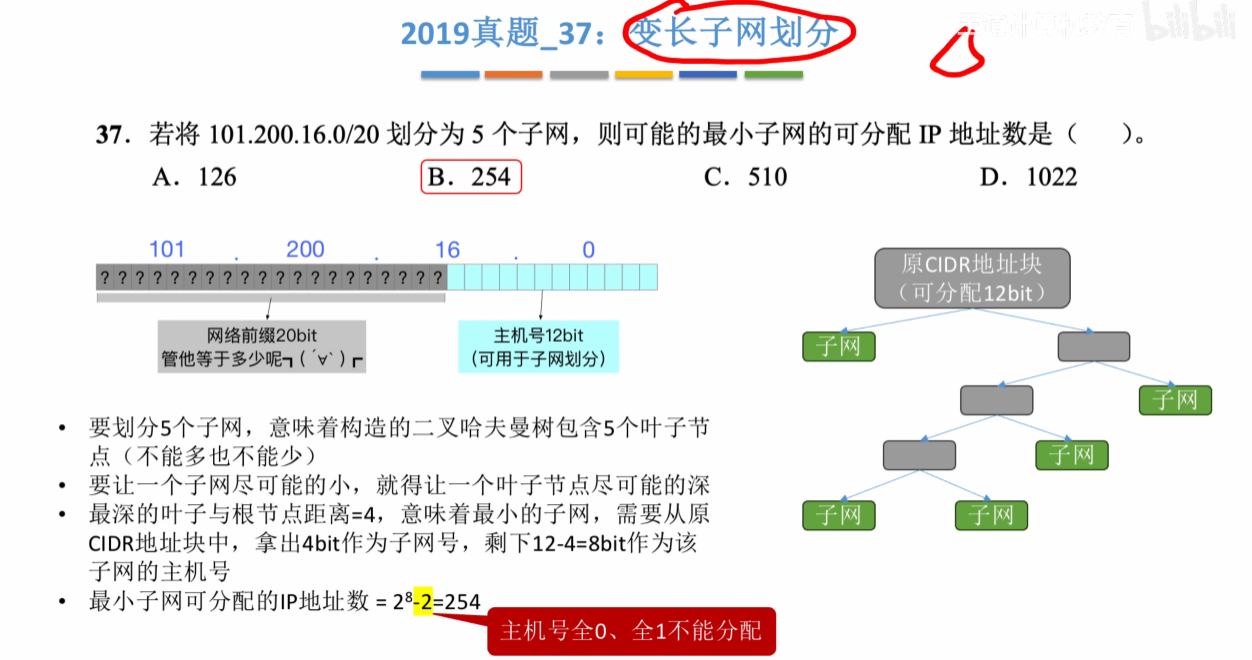
回顾
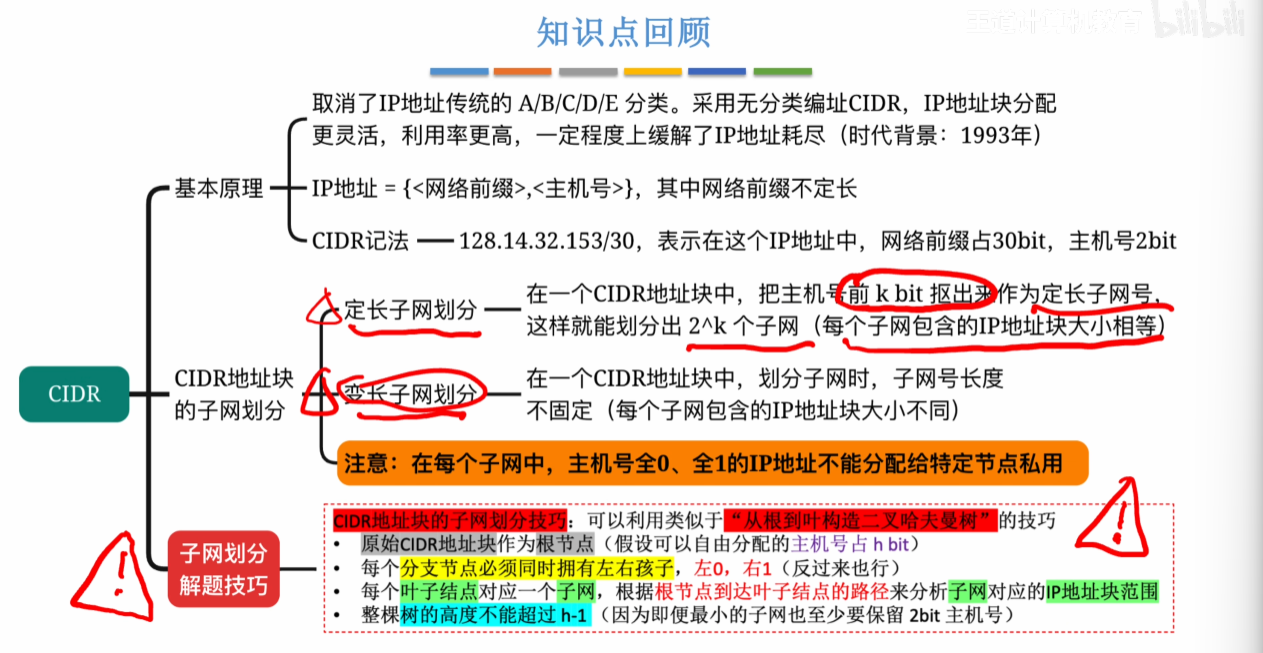
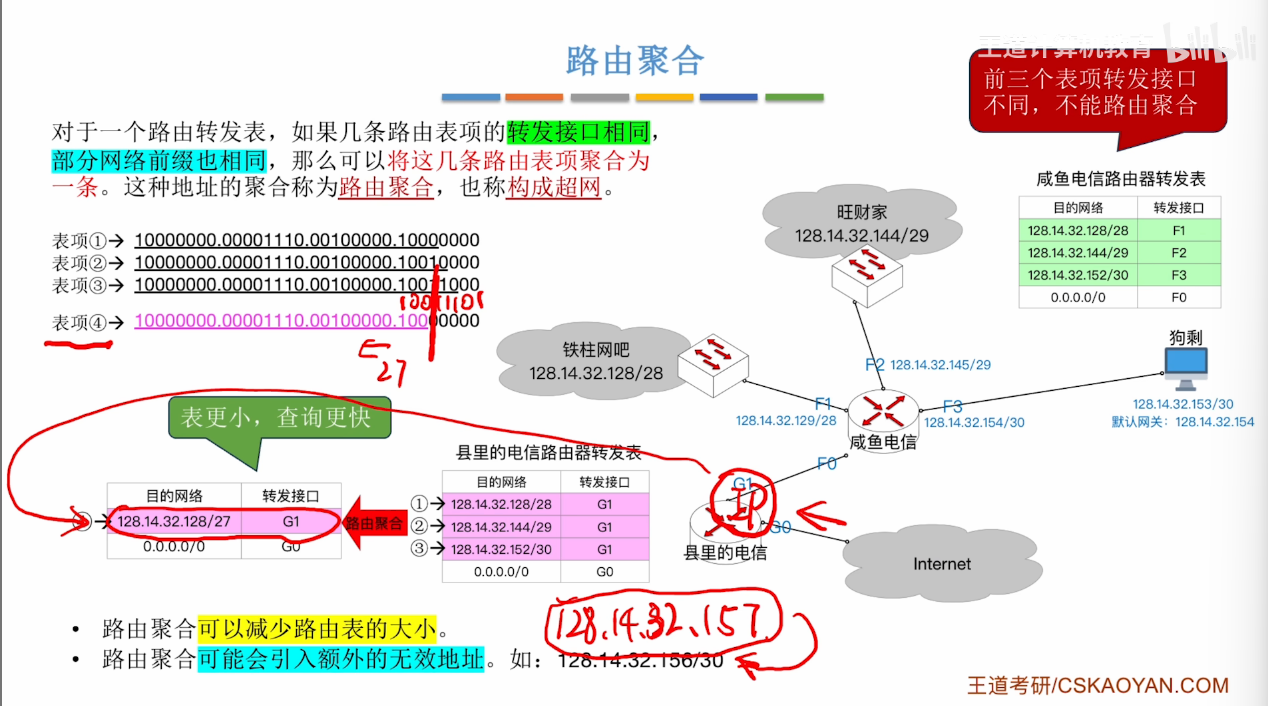
⑤ 路由聚合
配套CIDR的东西
路由聚合(构成超网)
- (IF转发接口,网络前缀相同)将几条路由表项聚合成一条,(原本记录ALL下一层表项的子网IP地址),只记录一个下层路由器的IP地址就行。
- 优点:路由转发表变小了,转发表查询速度提高了。
- 缺点:路由聚合可能会引入额外的无效地址(在终点路由器才能被发现)
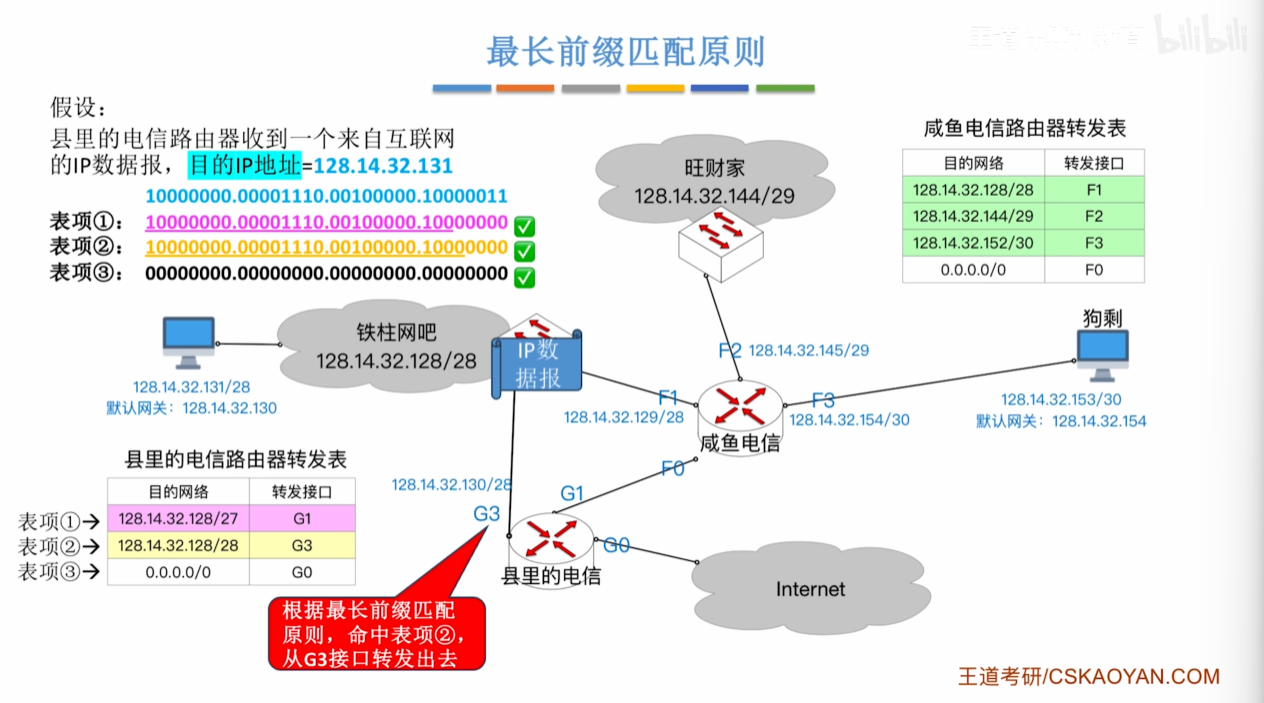
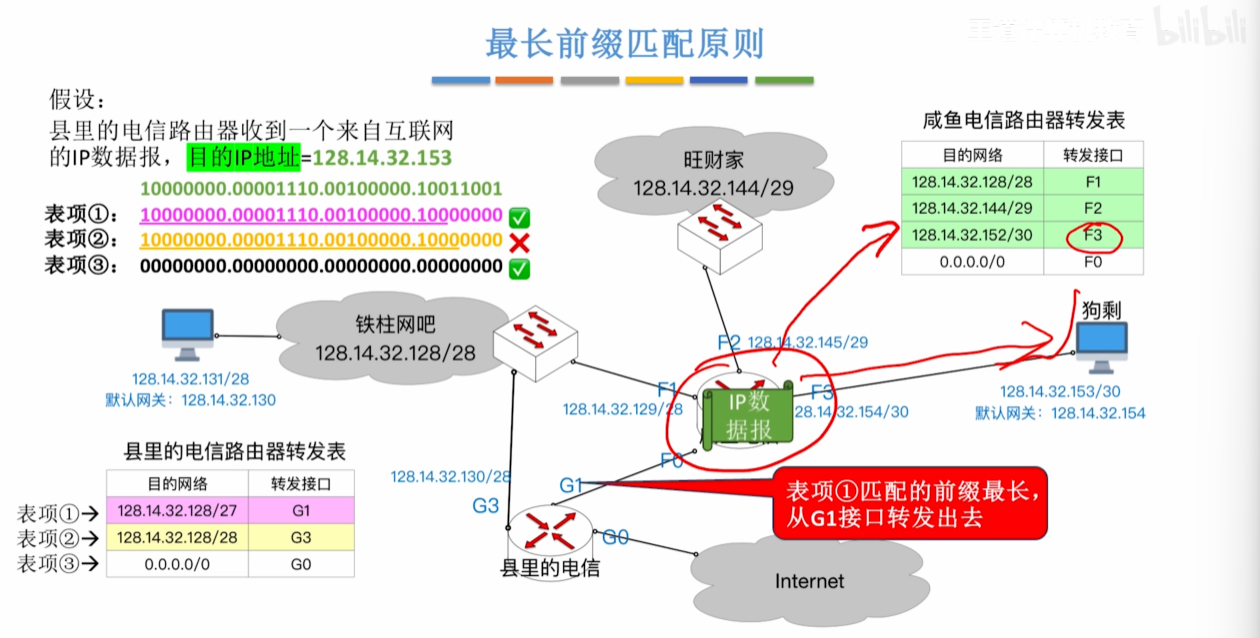
==最长 前缀 匹配原则==
when大局域网和小局域网不止一个接口。
从拥有 最长网络前缀匹配长度 的接口 转发出去。
- 优先级:特定主机路由(前缀32位)>普通路由器>默认路由器(前缀长度为0)
⭐主机发送IP数据过程
使用了CIDR和路由聚合后, 和之前完全相同
⭐路由器转发一个IP数据报的过程
(使用了CIDR和路由聚合后),==查转发表的部分稍有改变==:当IP地址匹配多个表项时,选取匹配长度最长的。
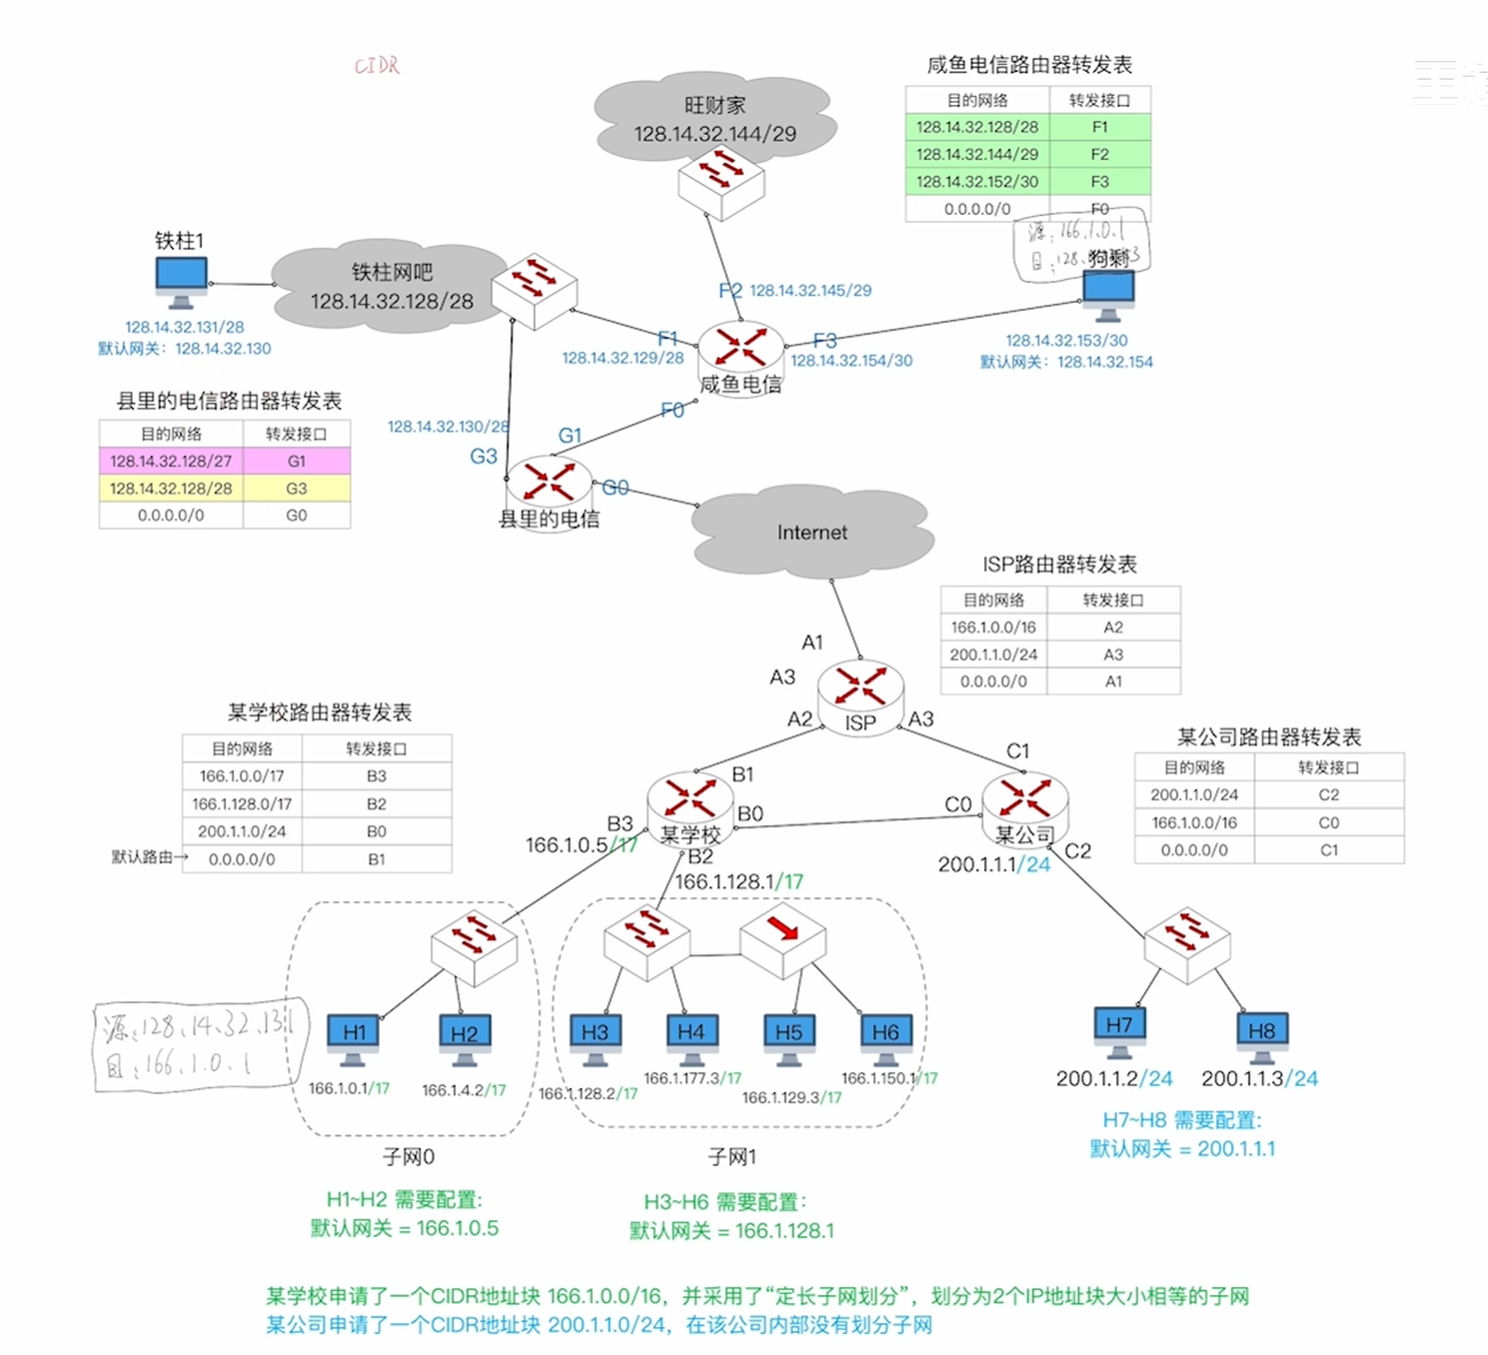
⭐过程再模拟
⑥ NAT 网络地址转换
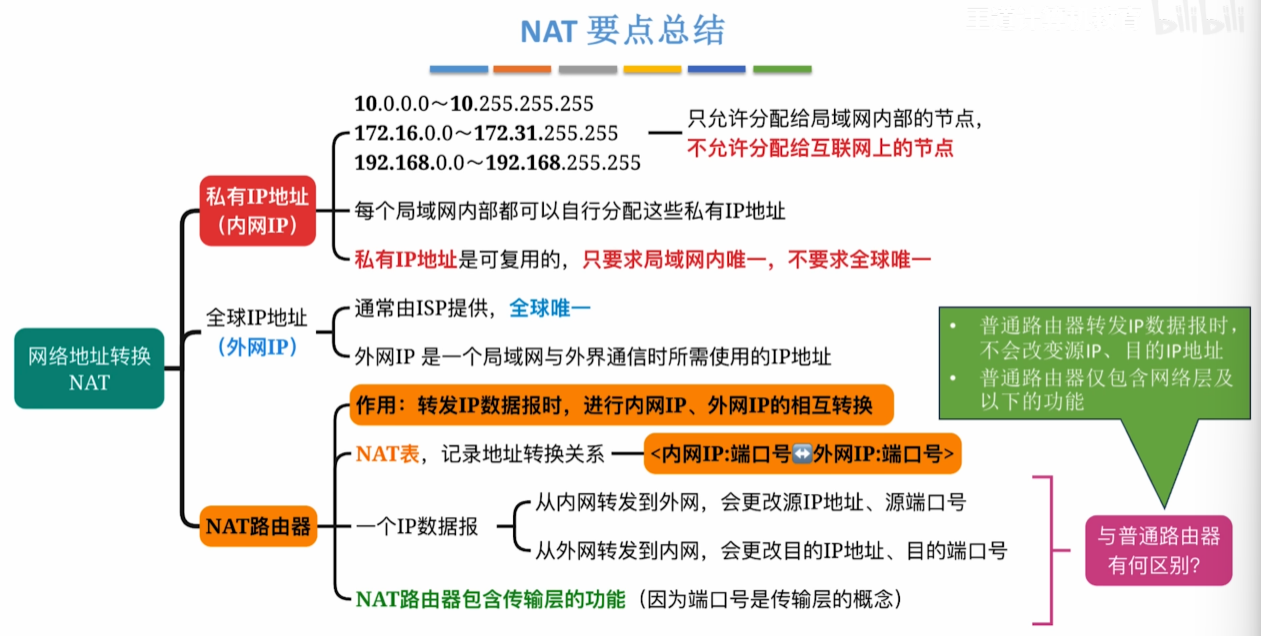
小细节:NAT路由器不同于普通路由器,NAT路由器包含了传输层的功能。
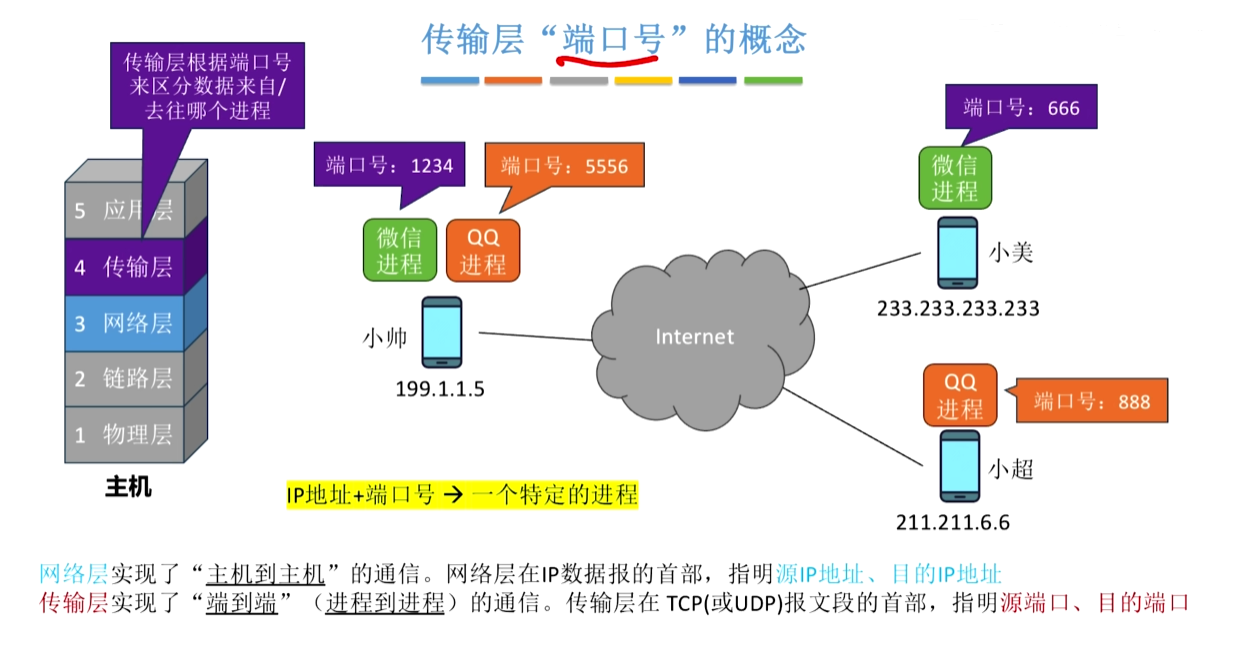
端口号
主机内部进程和进程之间的接口。
==IP地址 + 端口号== → ==一个特定的进程==
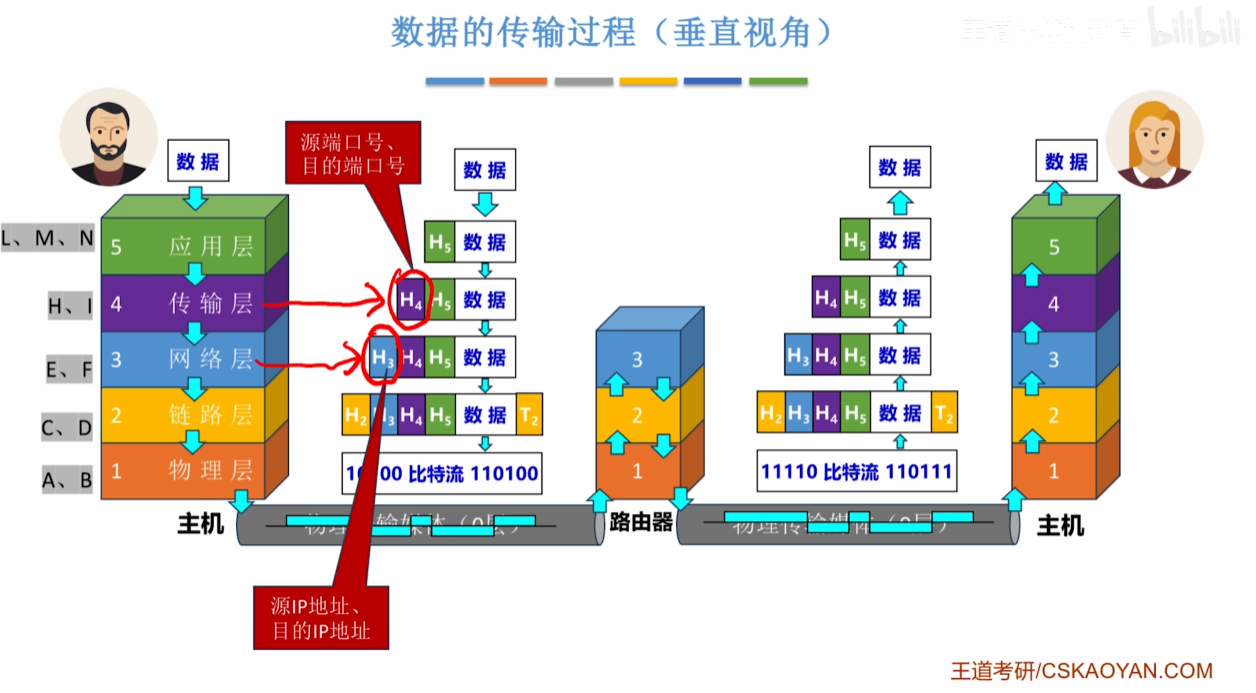
NAT:进一步缓解IP地址不够用的问题
如果==每台主机一个IP地址==:2^32≈32亿,显然不够用
如果==一个局域网一个IP地址 + 一个端口号==(实现定位):好像可以
原来的IP地址:**==外网IP==**(全球IP地址)
私有IP地址:**==内网IP==**(只要求局域网唯一,不要求全球唯一)(分配给局域网内部的节点)
**==三个私有IP地址块==**:
- 10.0.0.0/8(相当于1个A类网络)
- 172.16+.0.0/12(相当于16个连续的B类网络)
- 192.168.0.0/16(相当于256个连续的C类网络
注:==所有路由器对目的地址为私有地址的数据报一律不转发==(所以目的地址得填公共IP)
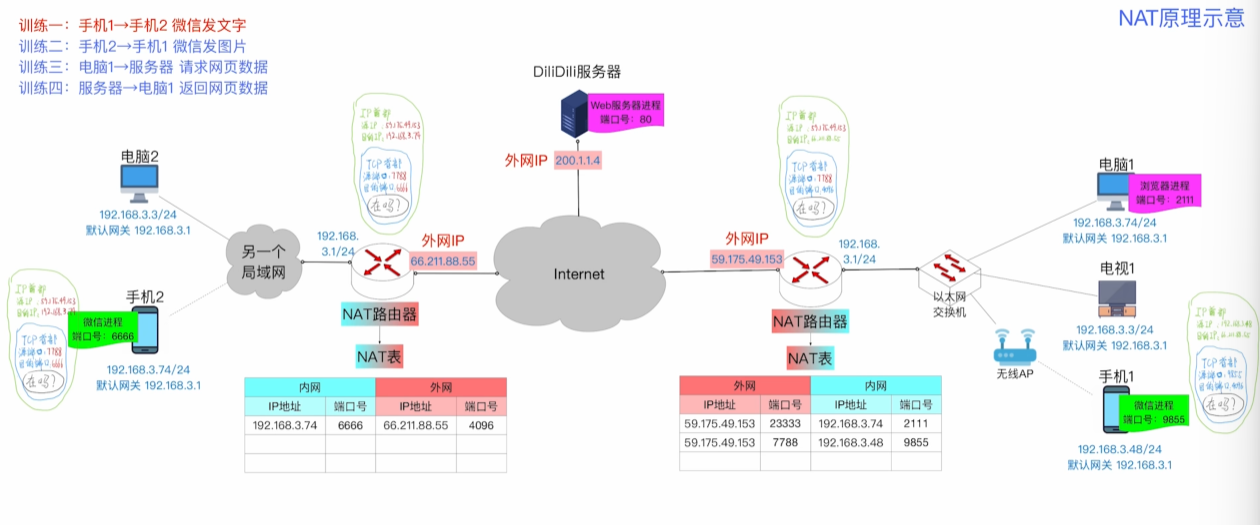
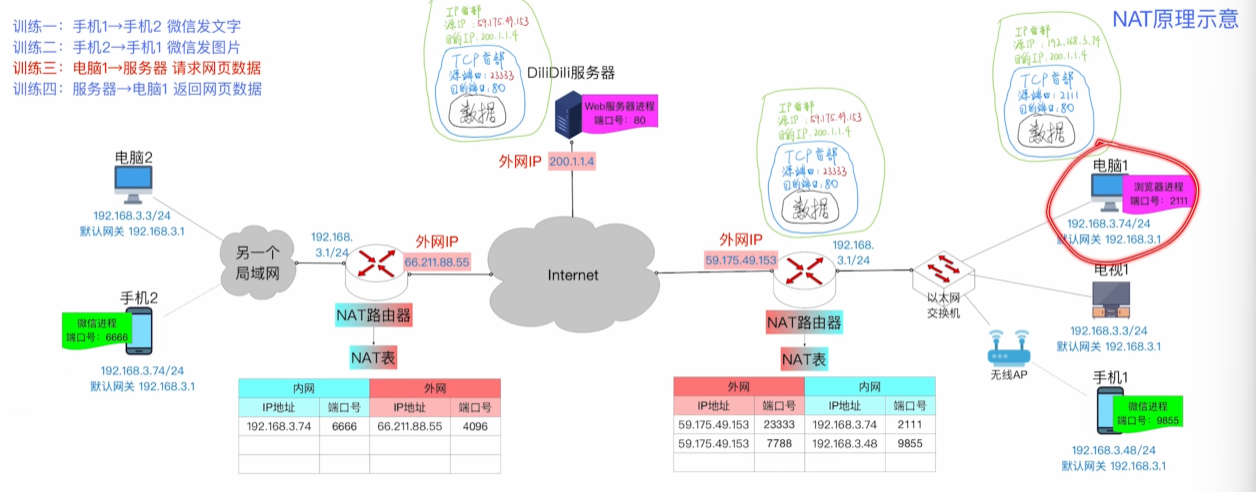
**==NAT路由器==**(普通的路由器仅包含网络层及以下的功能,不包括传输层的功能)
- 转发IP数据报时,进行内网IP和端口号、外围IP和端口号的相互转换
- **==NAT表==**记录的信息:<内网IP:端口号 | 外围IP:端口号>
- 【传输数据:IP首部(内含源/目标IP),TCP首部(内含源/目标端口),数据部分】
回顾
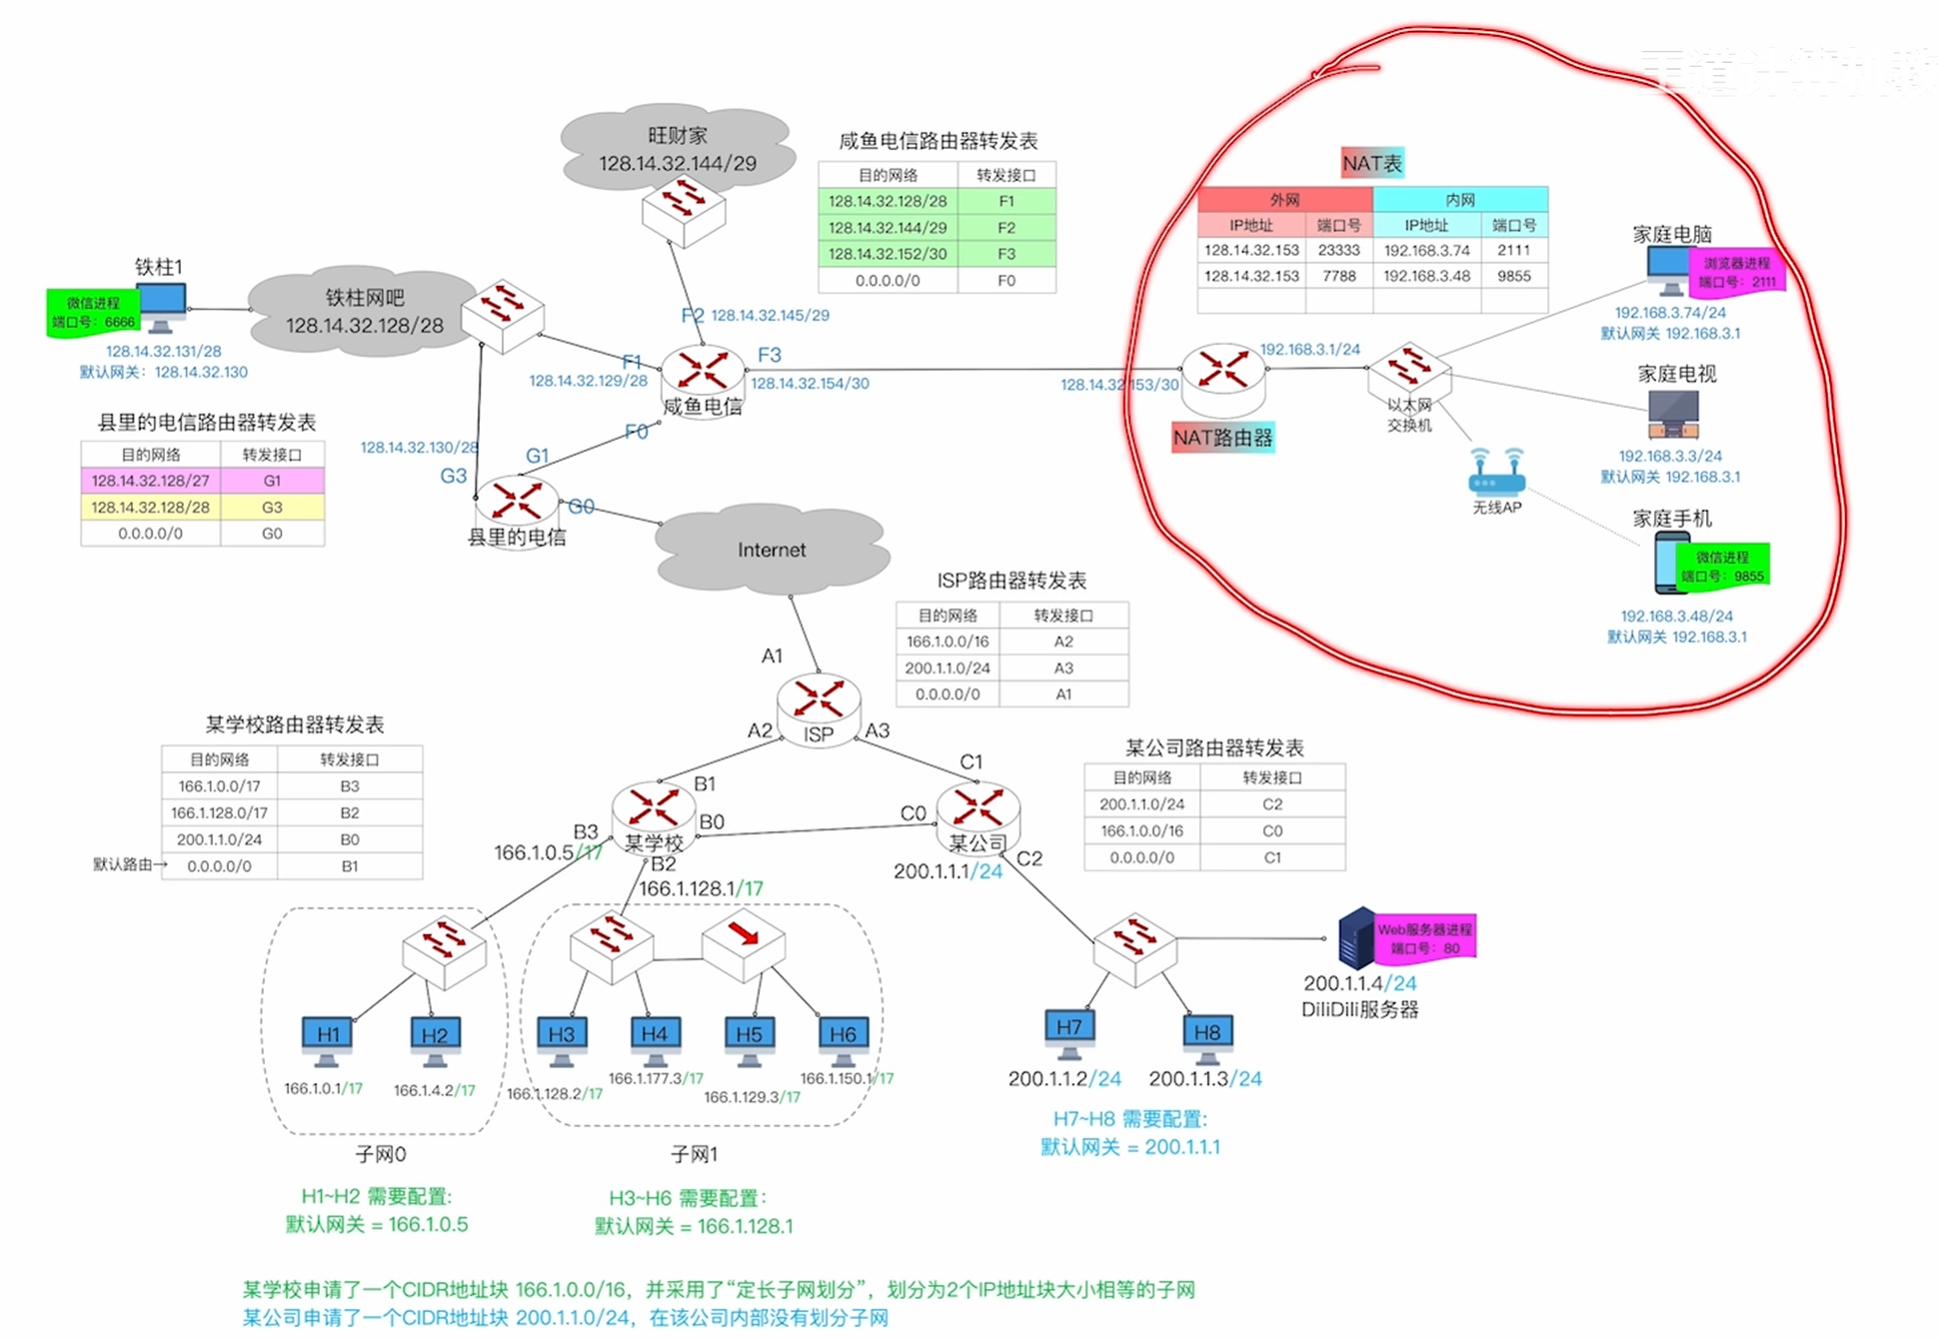
⑦ ARP 地址解析协议
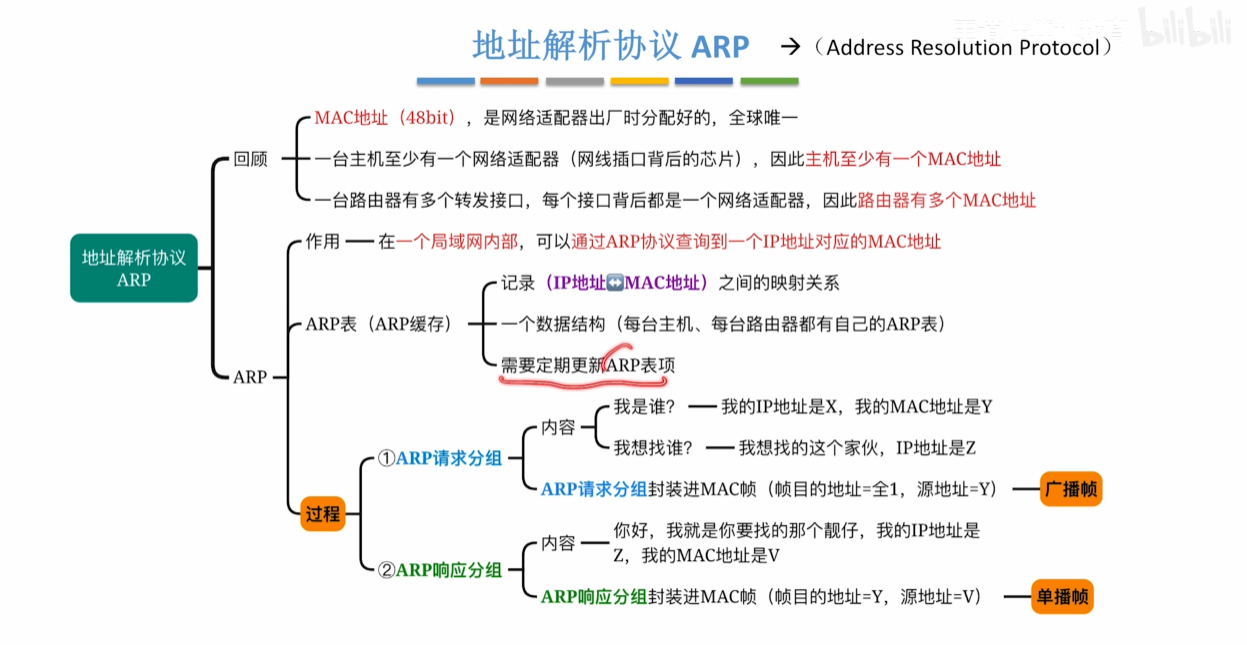
(当主机需要发送信息,但ARP表没有目的IP与MAC地址的映射关系时)
==在一个局域网的 内部,==
==查询一个IP地址对应的 MAC地址==⭐
回顾
- MAC地址(48bit),是网络适配器出厂时分配好的,全球唯一
- 一台主机至少有一个网络适配器(网卡),因此主机至少有一个MAC地址
- 一台路由器有多个转发接口,每一个接口背后都是一个网卡,因此网络适配器有多个MAC地址。
==ARP表==
- 记录 <IP地址,MAC地址> 之间的映射关系
- ARP响应后,双方都可以把对面的 IP地址和MAC地址记录在APR表。
- 需要定期更新(表项有保质期,超时删除表项)
- 每台主机/路由器都有自己的ARP表
==ARP过程==
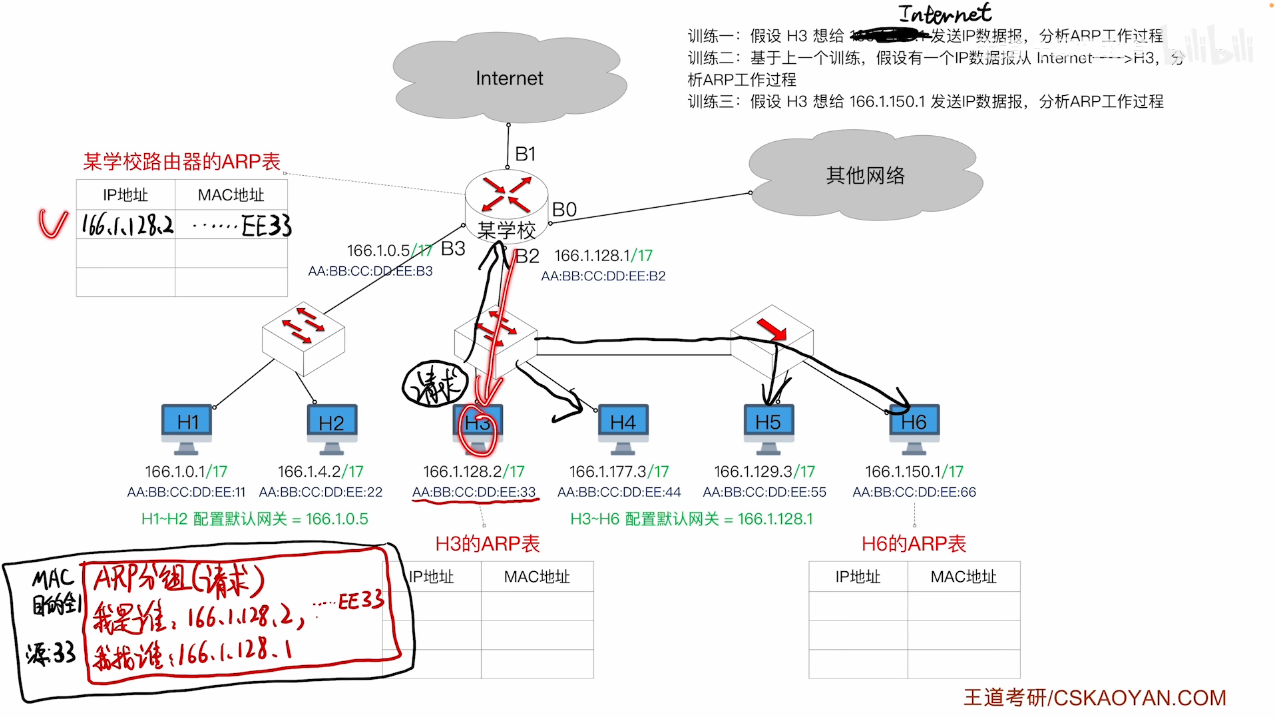
①ARP请求分组
- 内容:我是谁(自己的IP地址,MAC地址),我想找谁(对方的IP地址)
- 把 APR请求分组 封装进自己的MAC帧(帧目的地址全1,源地址=Y)(所有接口都收得到)**==【广播帧】==**⭐
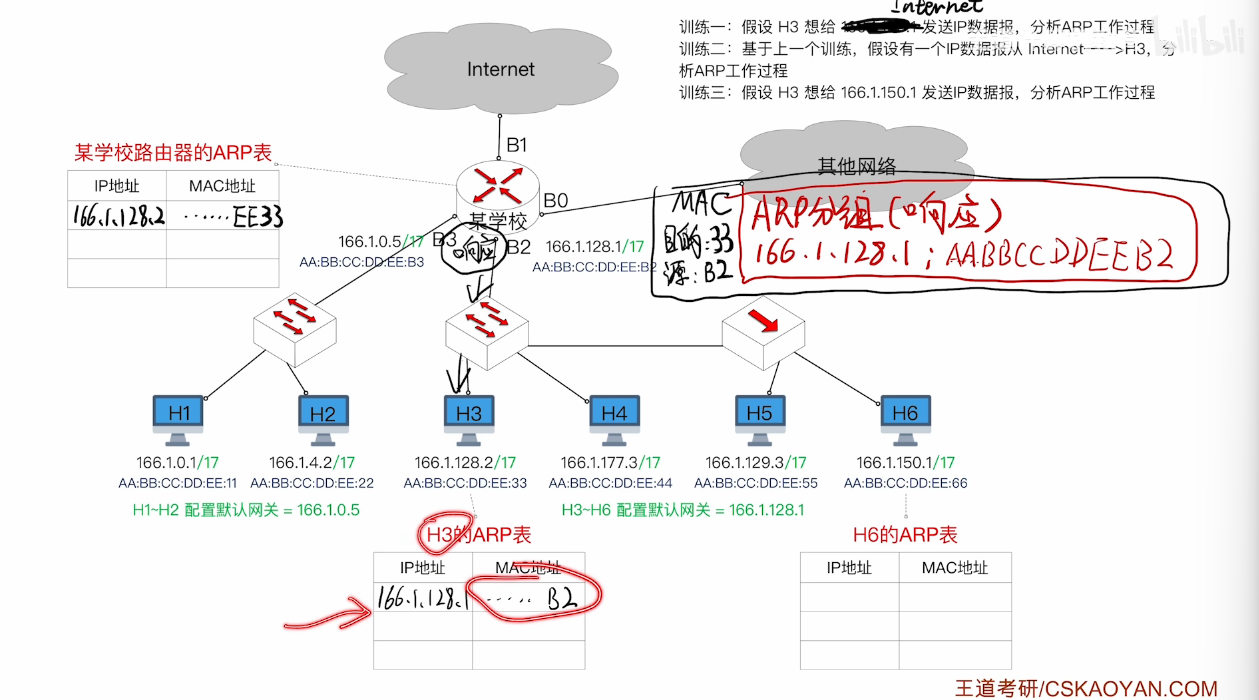
②ARP响应分组
- 内容:我的IP地址是Z,我的MAC地址是V
- 把 ARP响应分组 封装进自己的MAC帧(帧目的地址=Y,源地址=V)**==【单播帧】==**(碰到集线器就不算单播了哈哈哈)
训练一
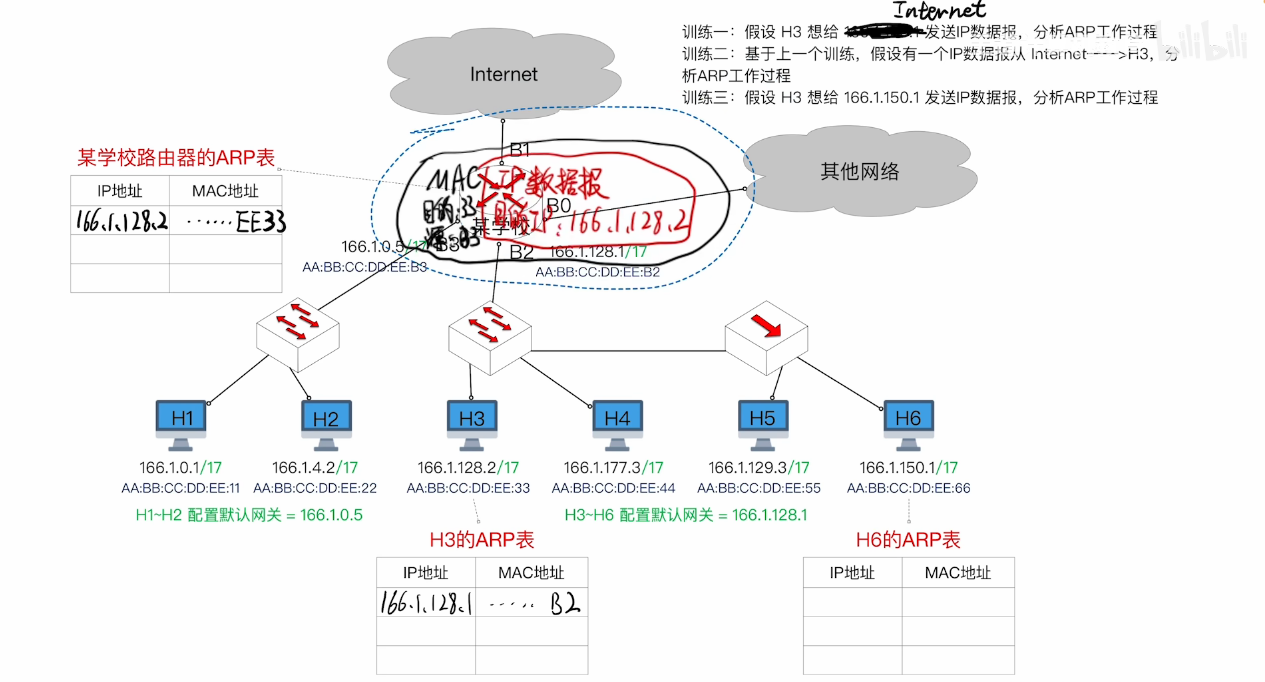
训练二
拓展
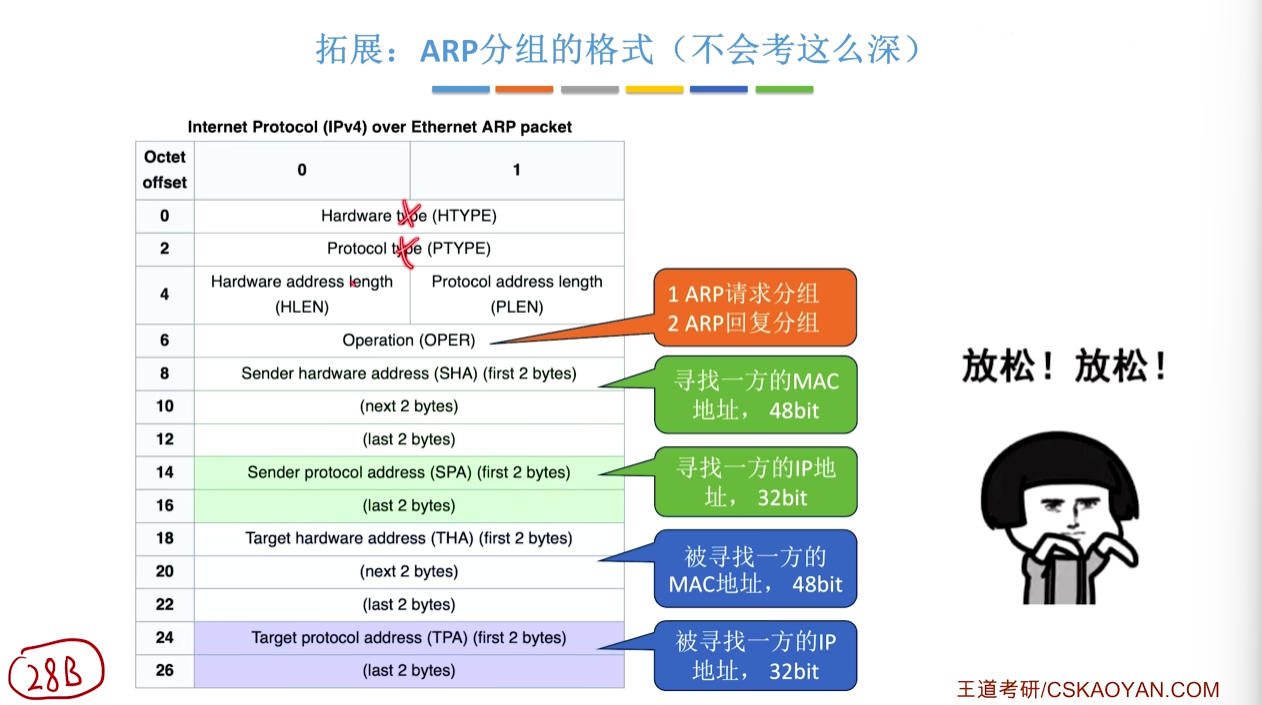
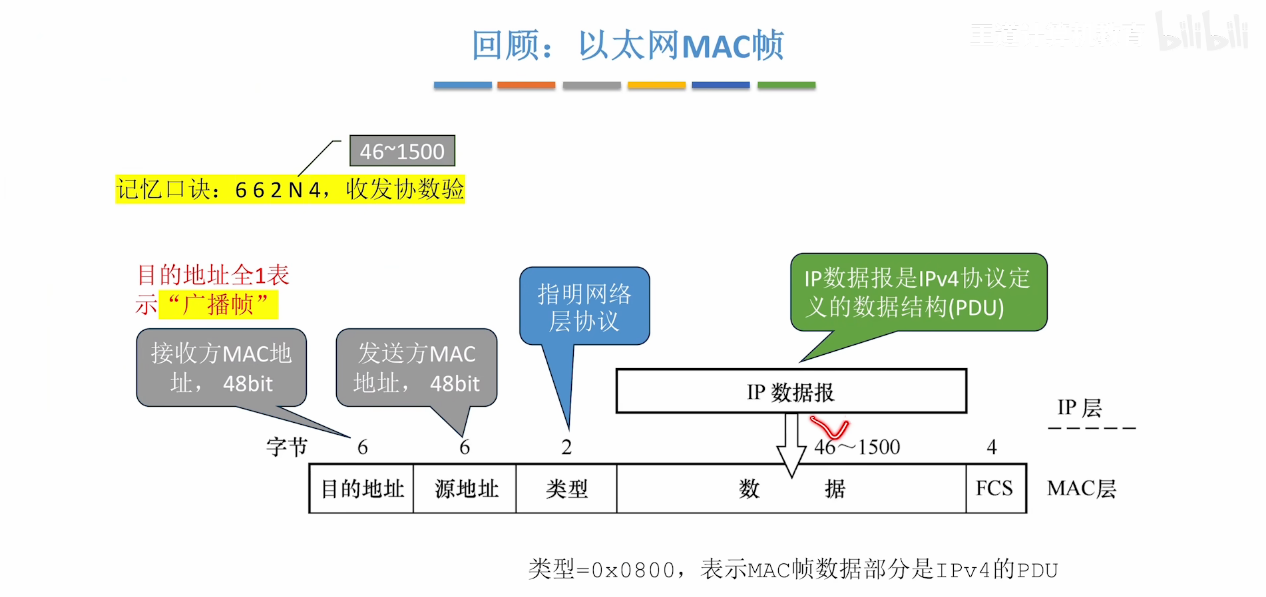
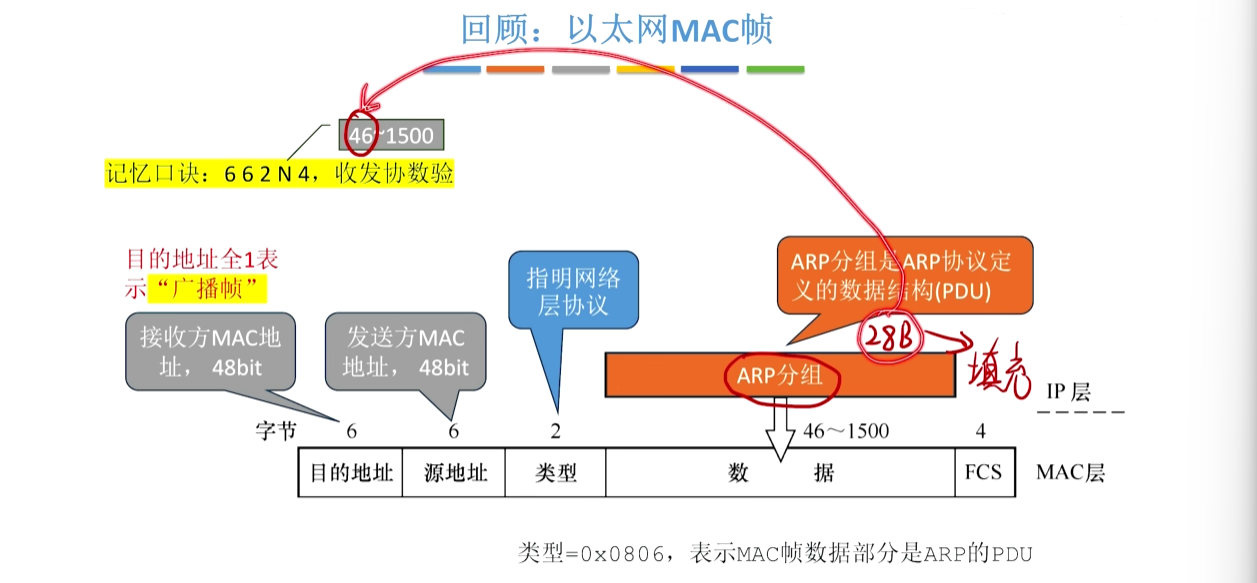
(ARP的28B得填充到46B才能封装进以太网MAC帧)
⑧ DHCP 动态主机配置协议
提供了即插即用的联网机制
==给刚接入网络的主机动态分配IP地址,配置默认网关,子网掩码==
DHCP是 应用层协议!
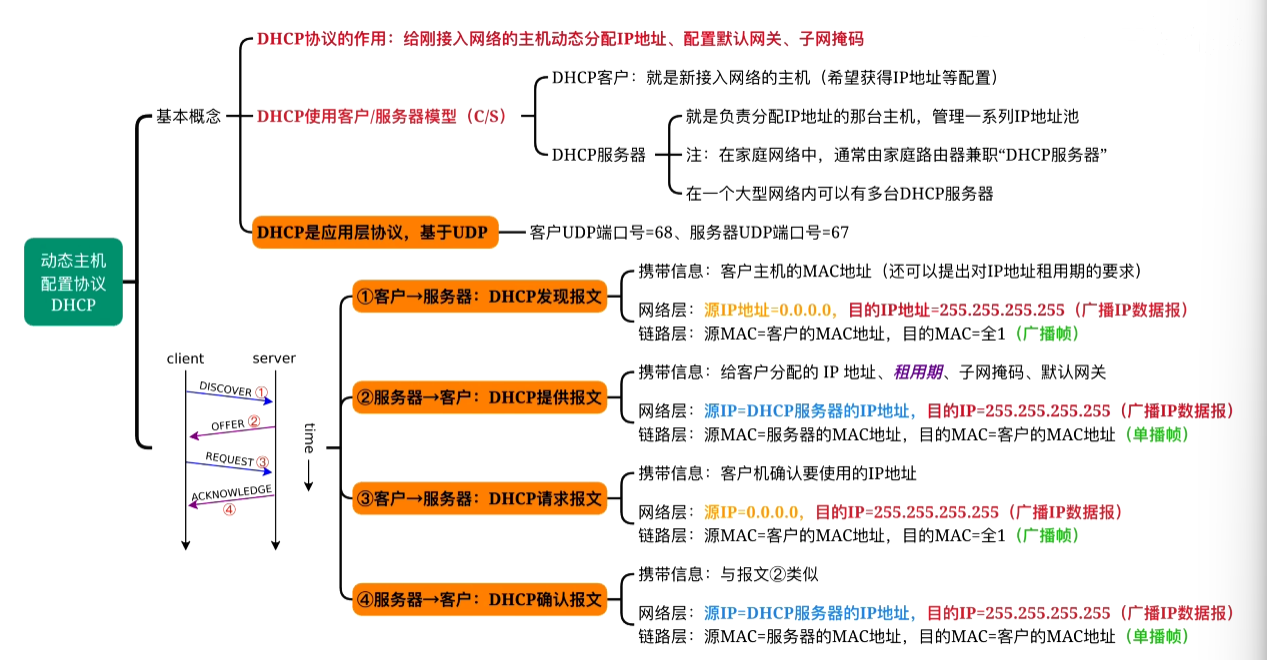
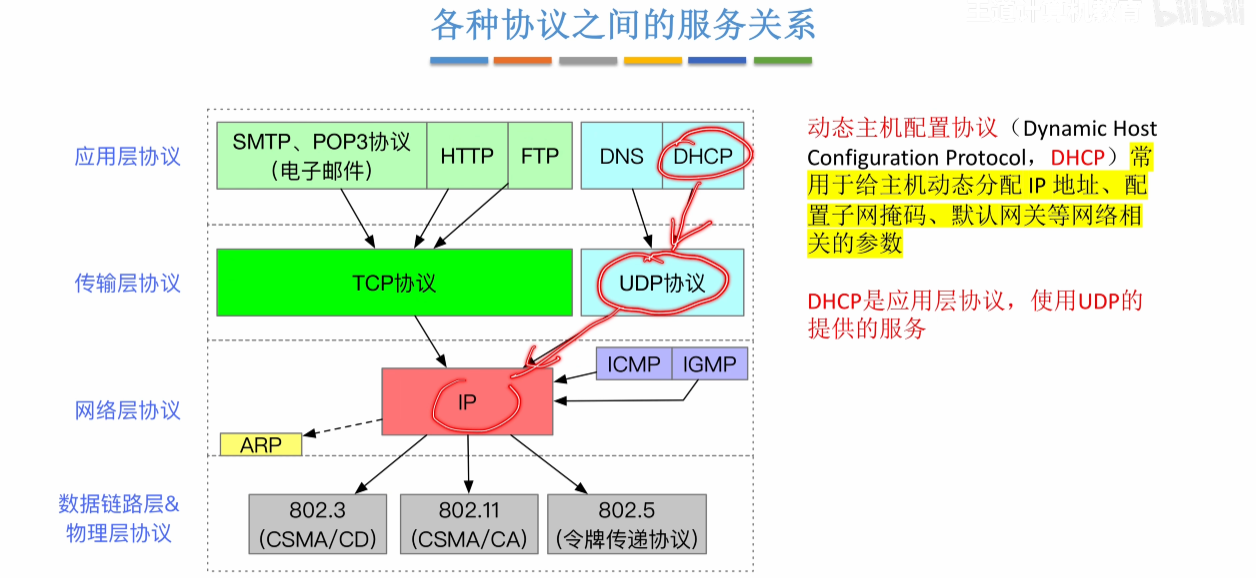
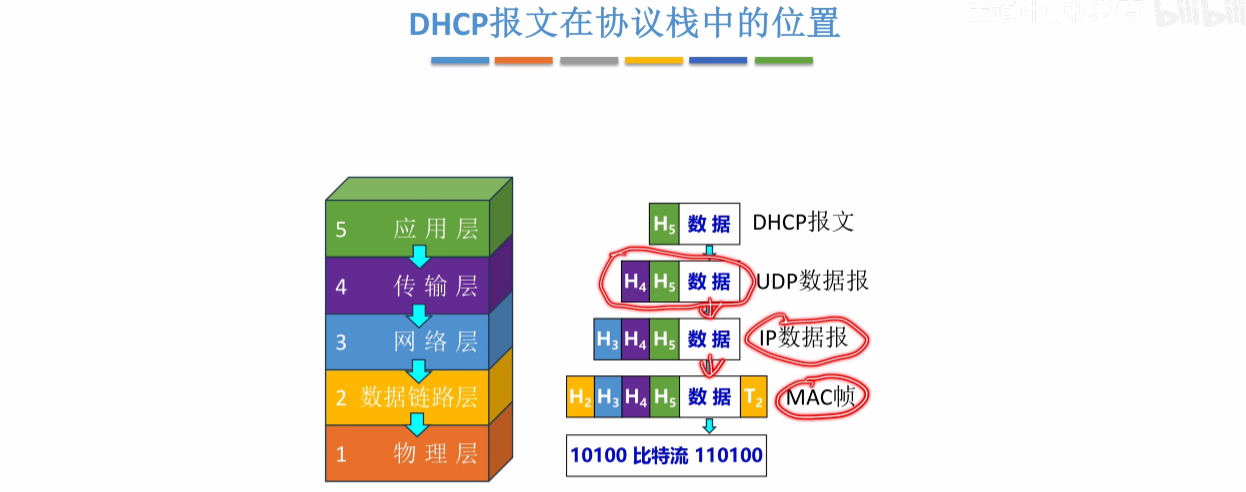
DHCP服务器
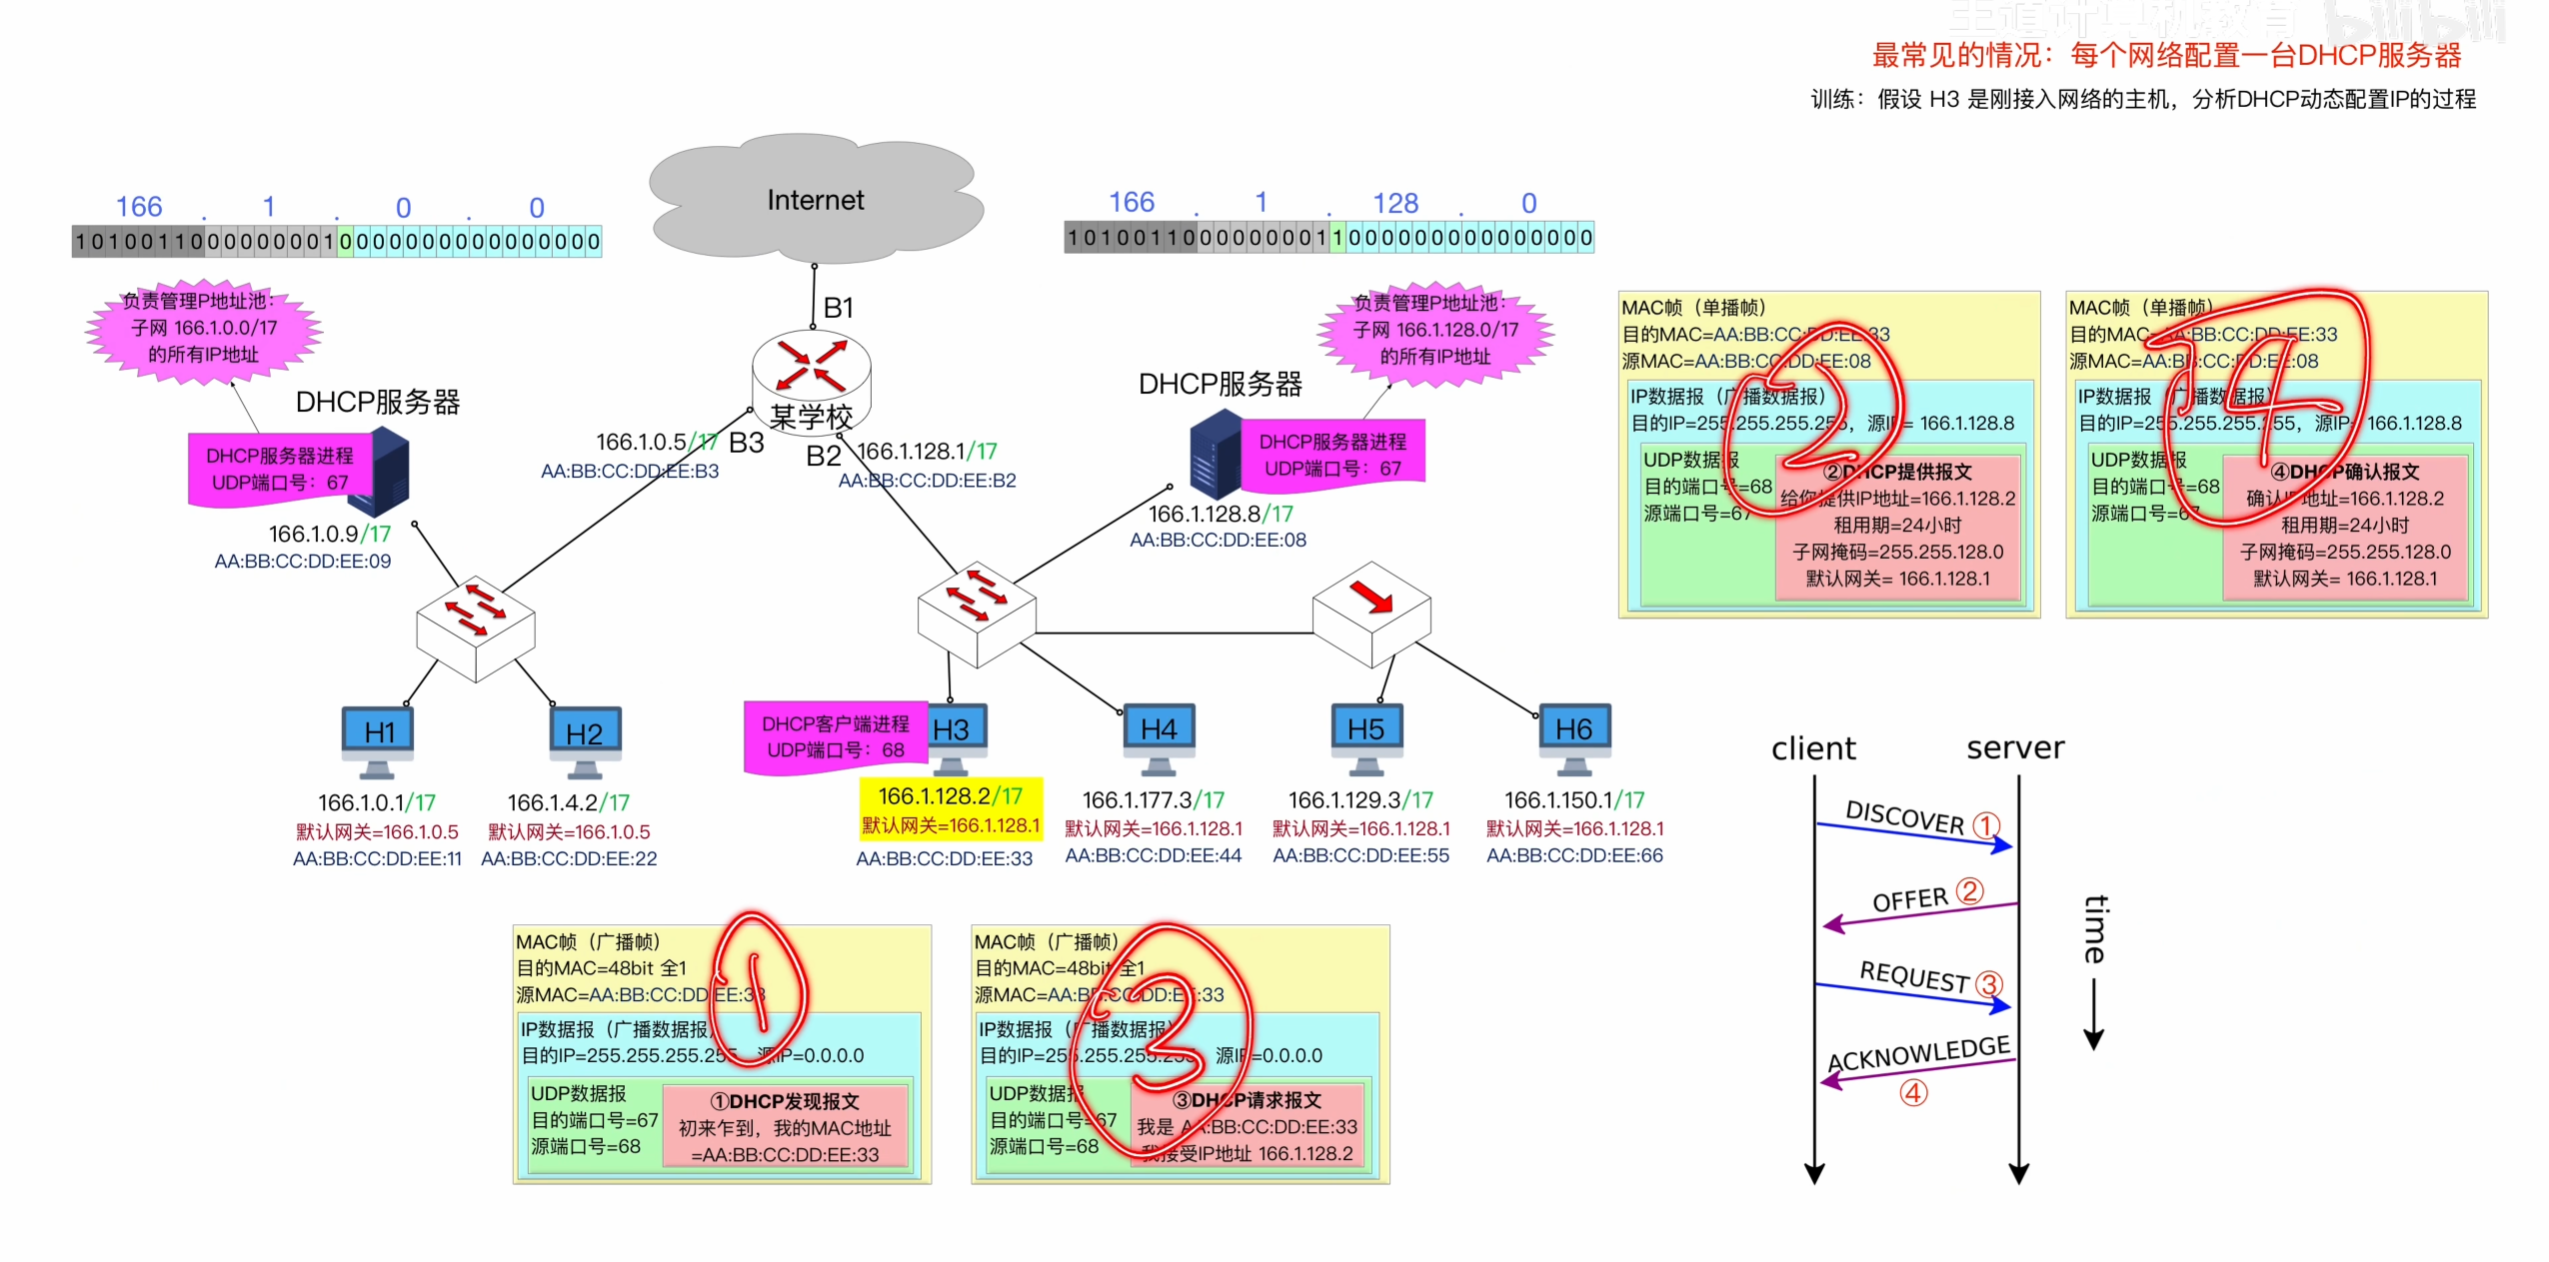
DHCP服务器的IP地址和子网的路由器IP地址相同
DHCP服务器负责管理子网内的所有IP地址。
==新主机连进局域网,会请求DHCP服务器分配【IP地址,配置默认网关,子网掩码】给自己。==
① 发现报文DISCOVER:其他主机能够接收,到达主机传输层看到目的端口号,才发现不匹配,丢弃。
② 提供报文OFFER:DHCP服务器 OFFER 一个IP地址给新主机【MAC帧是单播帧,精准到达新主机】
③ 请求报文REQUEST:新主机告诉服务器我接受IP地址(此时还没有IP地址)
- 因为大型网络可能有多台服务器,多台服务器都进行第②步。所以新节点MAC帧需广播所有人,我最终选用的是服务器的IP地址。
④ ACKNOWLEDGE确认报文
DHCP服务器分配给DHCP客户的IP地址是临时的
- 是一段租用期
- 租用期超过50%,DHCP客户发送DHCP请求报文(单播),请求更新租用期
- 租用期超过87.5%,DHCP客户发送DHCP请求报文(广播),请求更新租用期
回顾
⑨ ICMP 网际控制层协议
==让主机和路由器互相报告网络中发生的差错和异常情况==
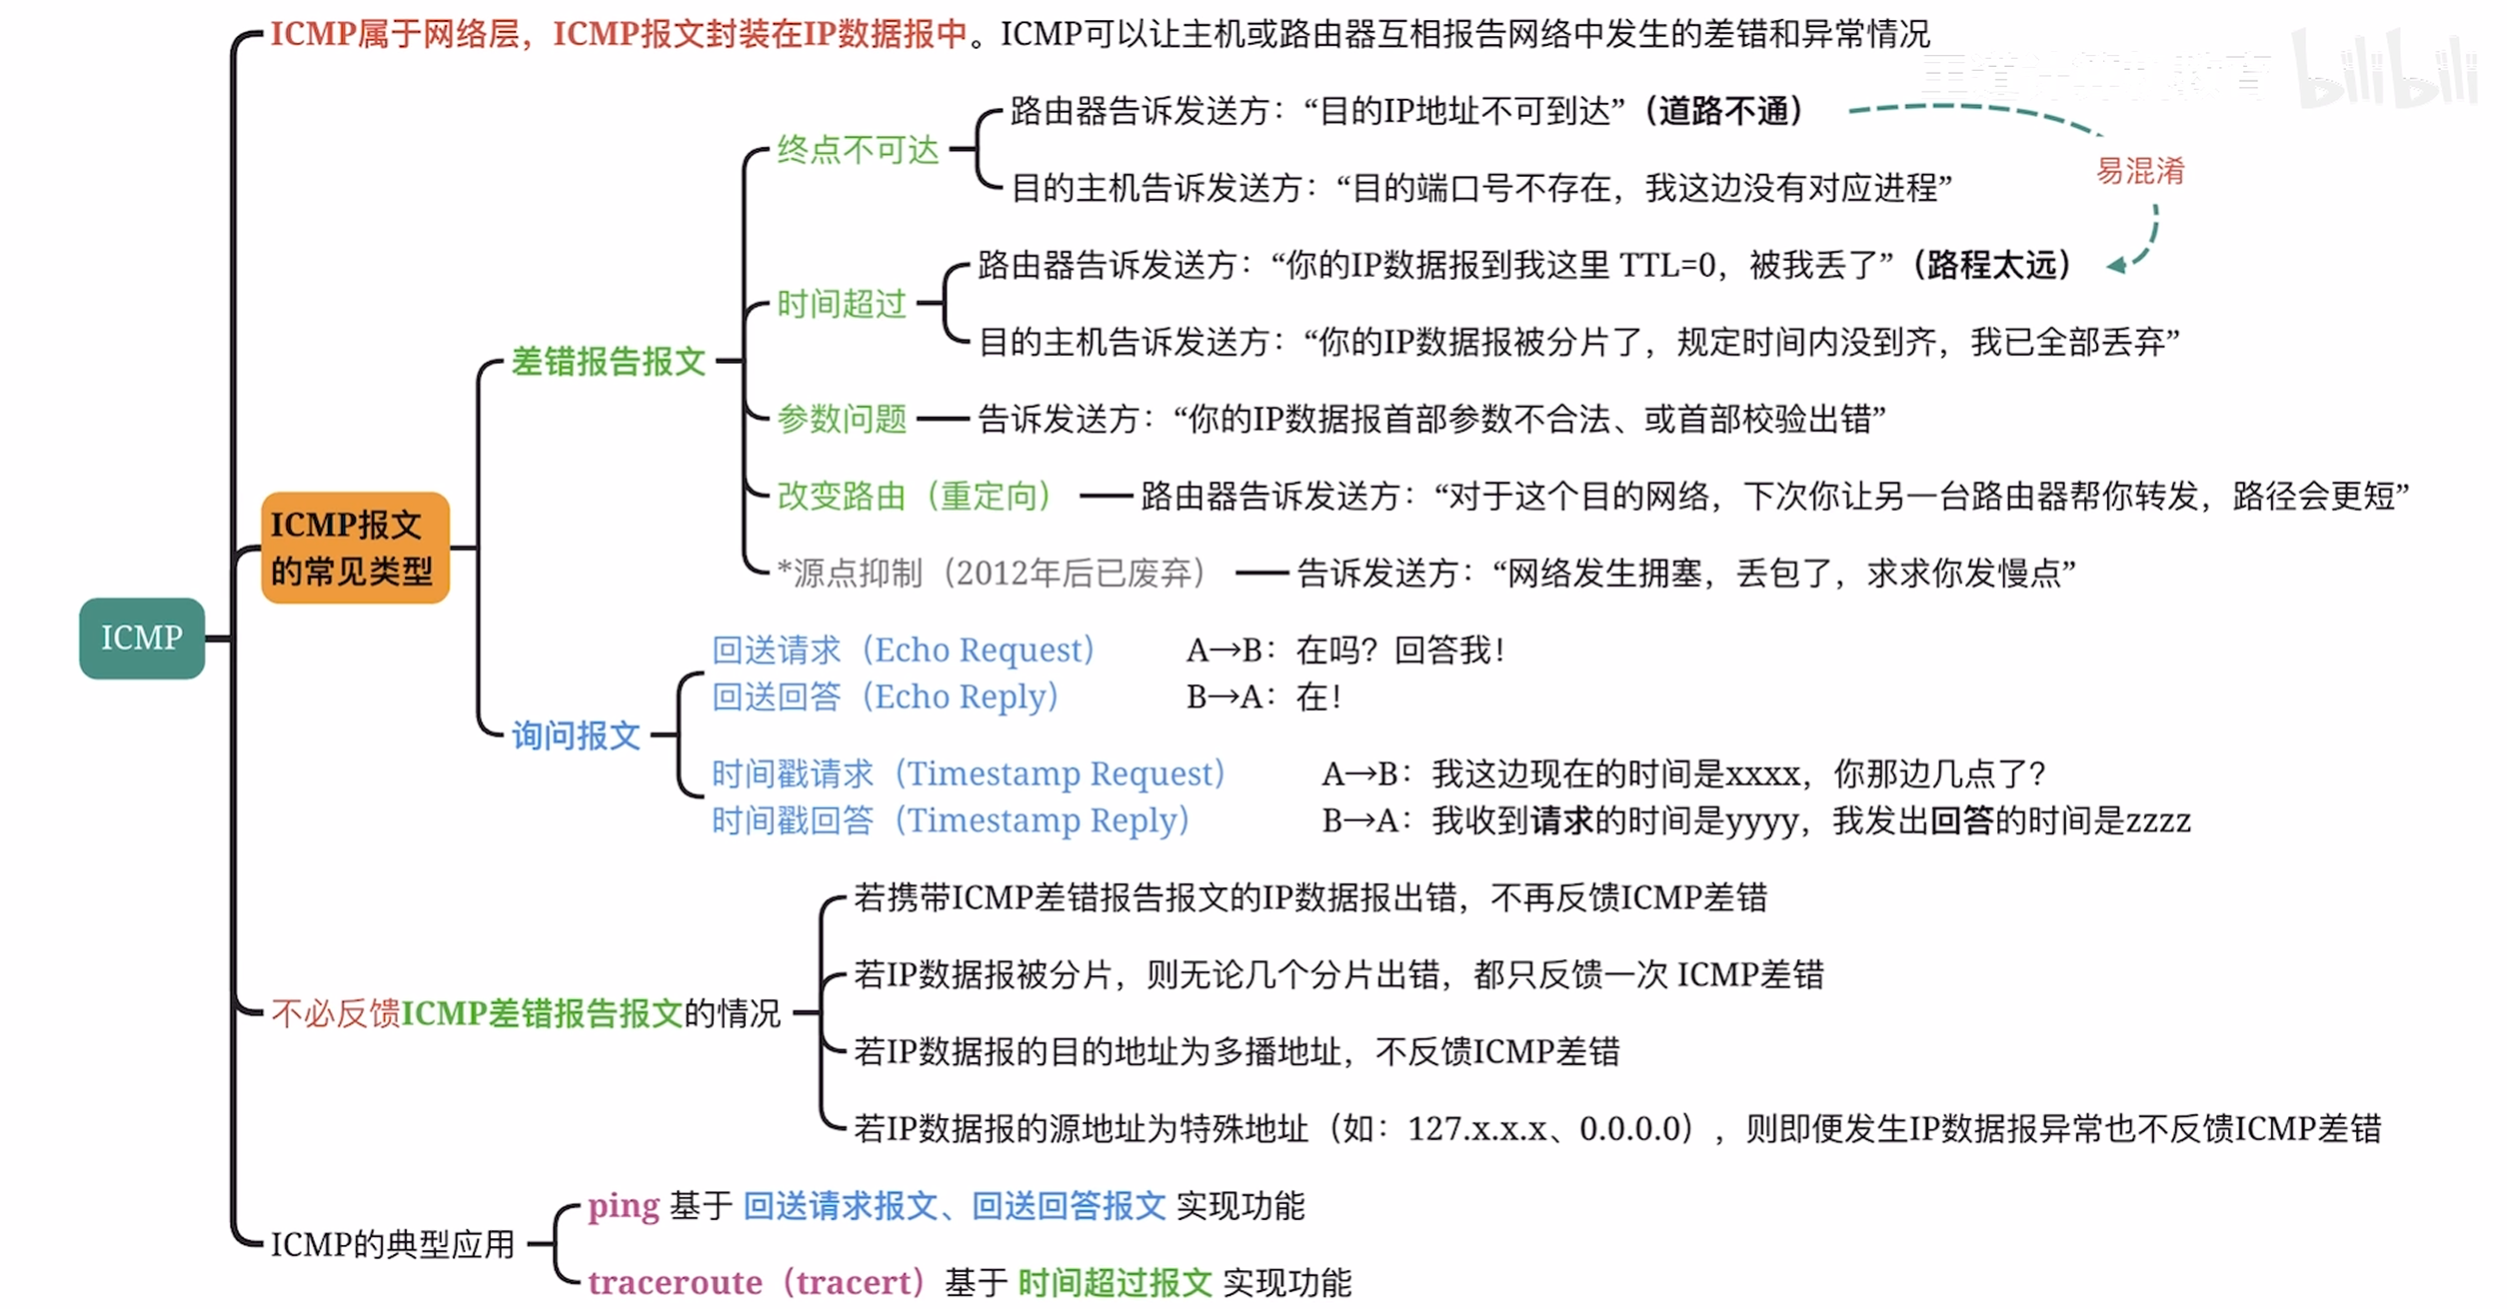
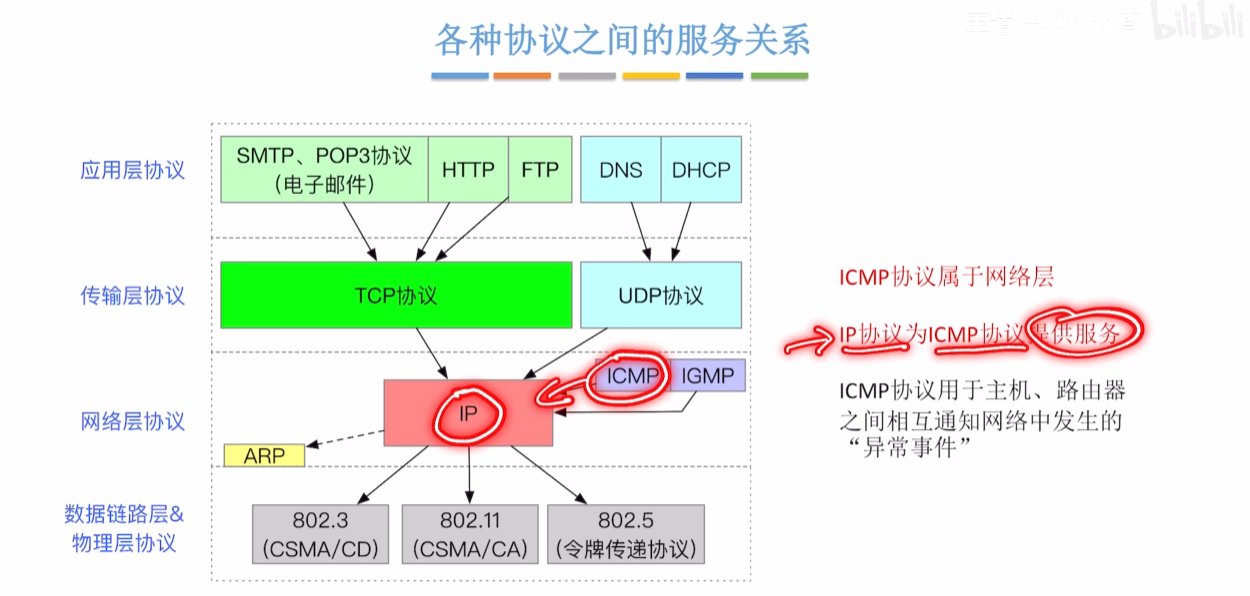
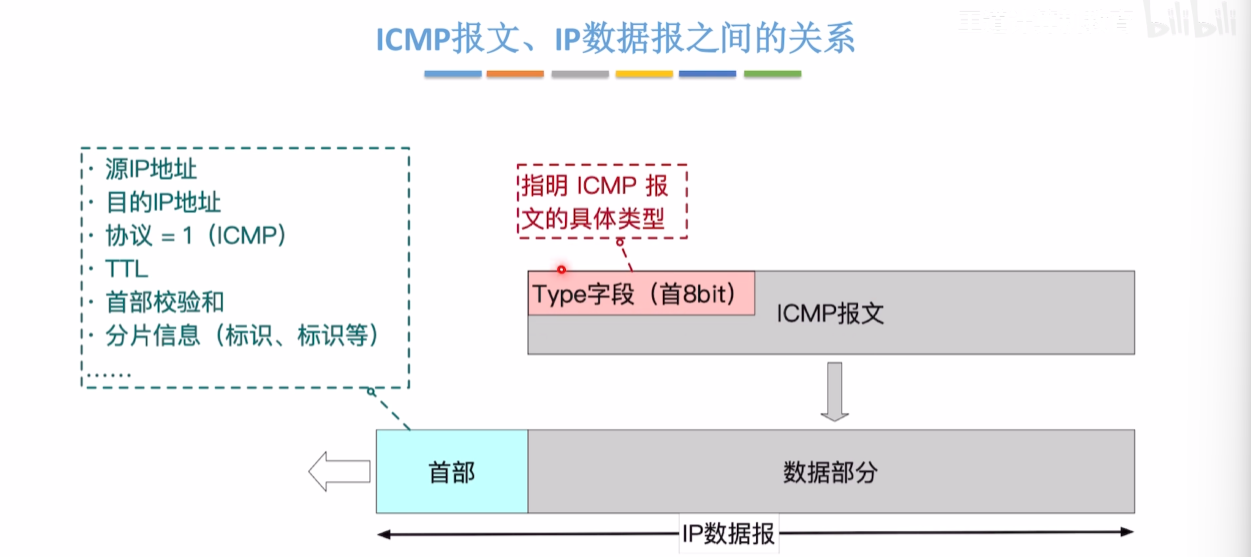
==ICMP属于网络层==,ICMP报文封装在IP数据报中。
ICMP报文最前面的8bit指明报文具体类型。
ICMP报文的常见类型
A.差错报告报文
- 终点不可达
- 路由器告诉发送方:目的IP地址不可到达
- 目的主机告诉发送方:目的端口号不存在
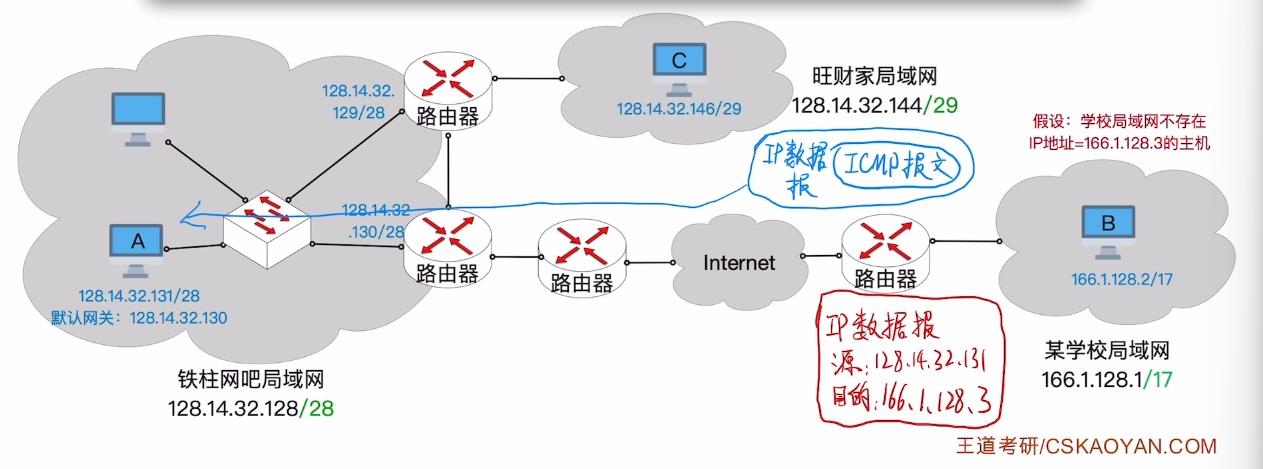
- 时间超过
- 路由器告诉发送方:IP数据报的TTL=0,被丢弃了。
- 目的主机告诉发送方:IP数据报被分片了,规定时间没到齐,被丢弃了。
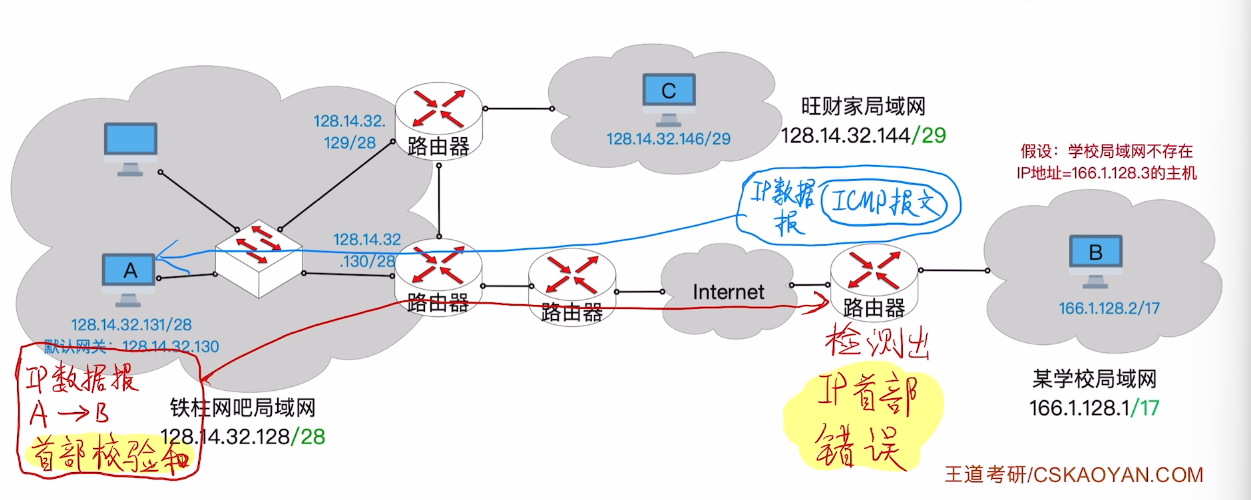
- 参数问题
- 告诉发送方:IP数据报首部不合法,或者首部校验出错
- 改变路由(重定向)
- 路由器告诉发送方:下次用另一台路由器转发,路径更短
B.询问报文
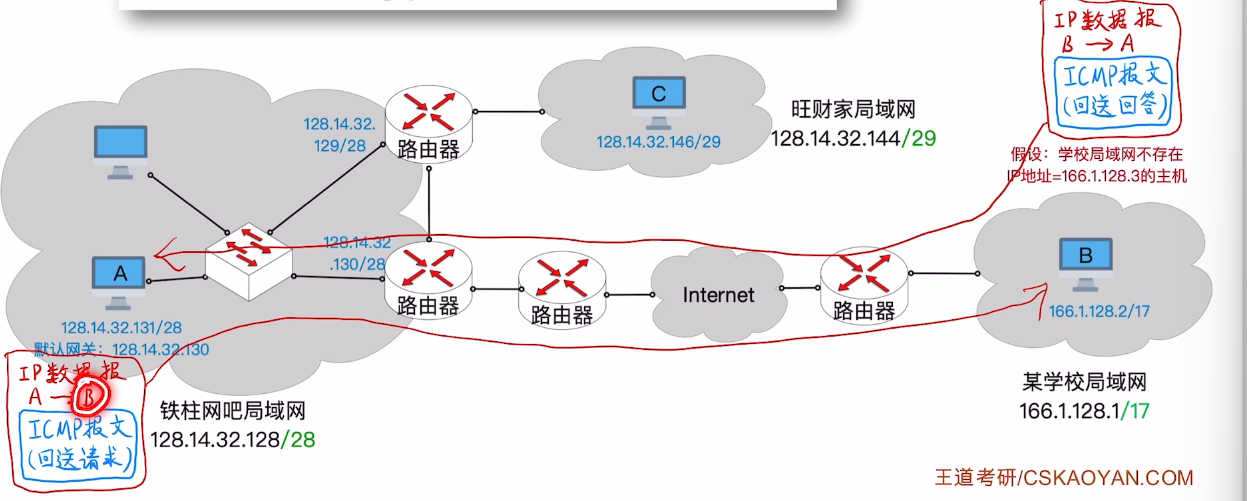
回送请求(Echo Request):A→B:在吗?回答我!
回送回答(Echo Reply):B→A:在!
(eg:ping命令)
时间戳请求:A→B:我这边现在的时间是xxx,你那边现在几点了?
时间戳回答:B→A:我收到请求的时间是yyy,我发出回答的时间是zzz
- (eg电脑开机自动校准时间)
C.不用反馈ICMP差错报告报文的情况
- 若携带ICMP差错报告报文的IP数据报出错,不再反馈ICMP差错
- 若IP数据报被分片,则无论几个分片出错,都只反馈一次ICMP差错
- 若IP数据报的目的地址为多播地址,不反馈ICMP差错
- 若IP数据报的源地址为特殊地址(如 127.x.x.x,0.0.0.0),即使发生IP数据报异常也不反馈ICMP差错
ICMP的应用
- 分组网间探测 ping 基于 回送请求报文,回送回答报文 实现功能
- 路由跟踪 traceroute(tracert)基于 时间超过报文 实现功能
⑩ 其他
【NAT】每经过一个路由器时候,==MAC源地址目的地址都会重新封装/改变,但是目的IP地址不变。==
- (硬件地址只具有本地意义,每当路由器将IP数据报转发到一个具体的网络时,都需要重新封装源硬件地址和目的硬件地址。)
子网重叠:就是A地址是C地址的子网,A地址重叠了C地址的网络前缀。或者是有交集。
- 子网的判断重叠,子网划分的题:画图⭐
若一台主机有两个或两个以上的IP地址,说明这台主机属于两个或两个以上的网络。(eg:WiFi+宽带)
在一条点对点链路中,只需要两个主机IP地址,一个网络地址,和一个广播地址的4种组合,主机号只需2位。(子网掩码应设定为255.255.255.254)
不考虑NAT时,传输过程中IP数据报的源地址和目的地址都不会发生变化。
4.3 IPv6
真正解决了IP地址资源问题
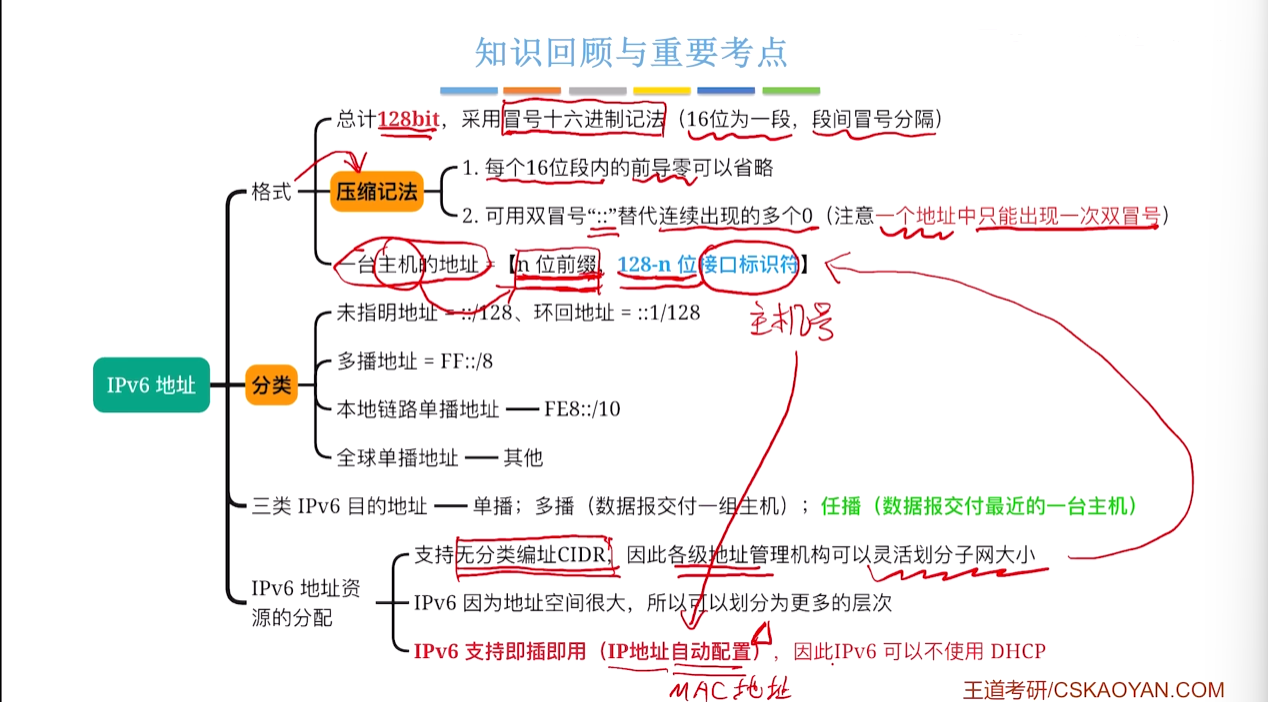
IPv4地址:==32位==
IPv6地址:==128位==
1.如何表示这么多位的IPv6地址?
IPv4:点分十进制记法:==8bit为一段,一共4段==。
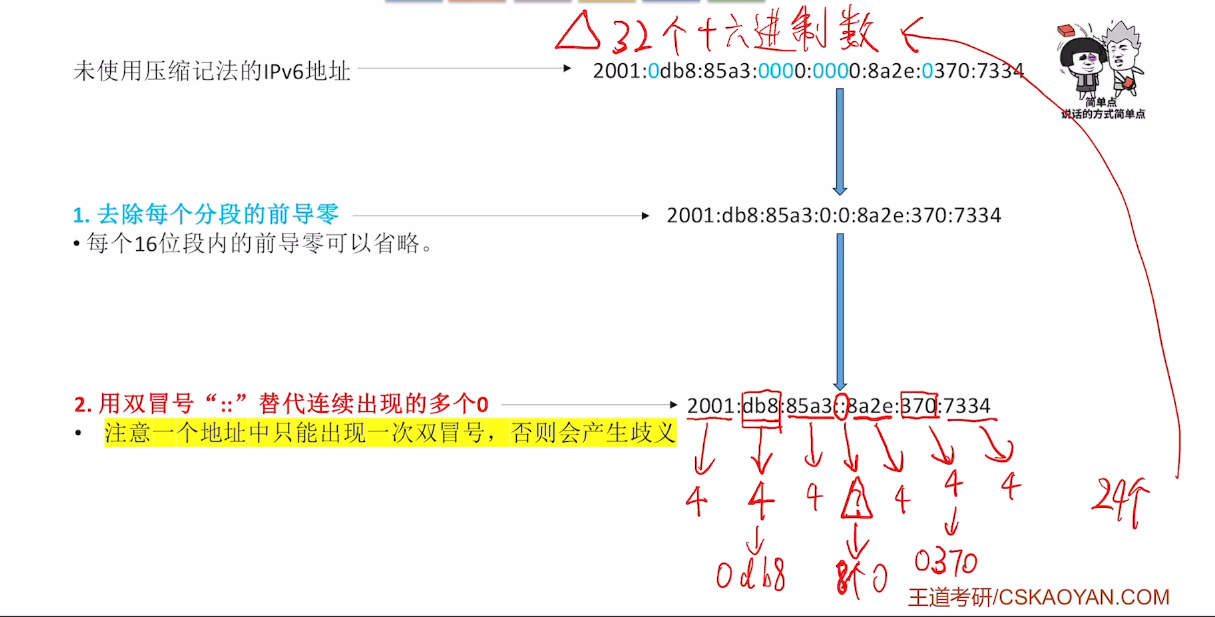
IPv6:冒号十六进制记法:==16bit为一段==,段间以冒号分割,==一共8个段==。(所以一共有32个十六进制数)
IPv6压缩记法:
- ① 去除每一个分段的前导0。
- ② 双冒号替代连续出现的多个0(一个地址只能用一次,否则会出现歧义 )
2.IPv6地址资源分配
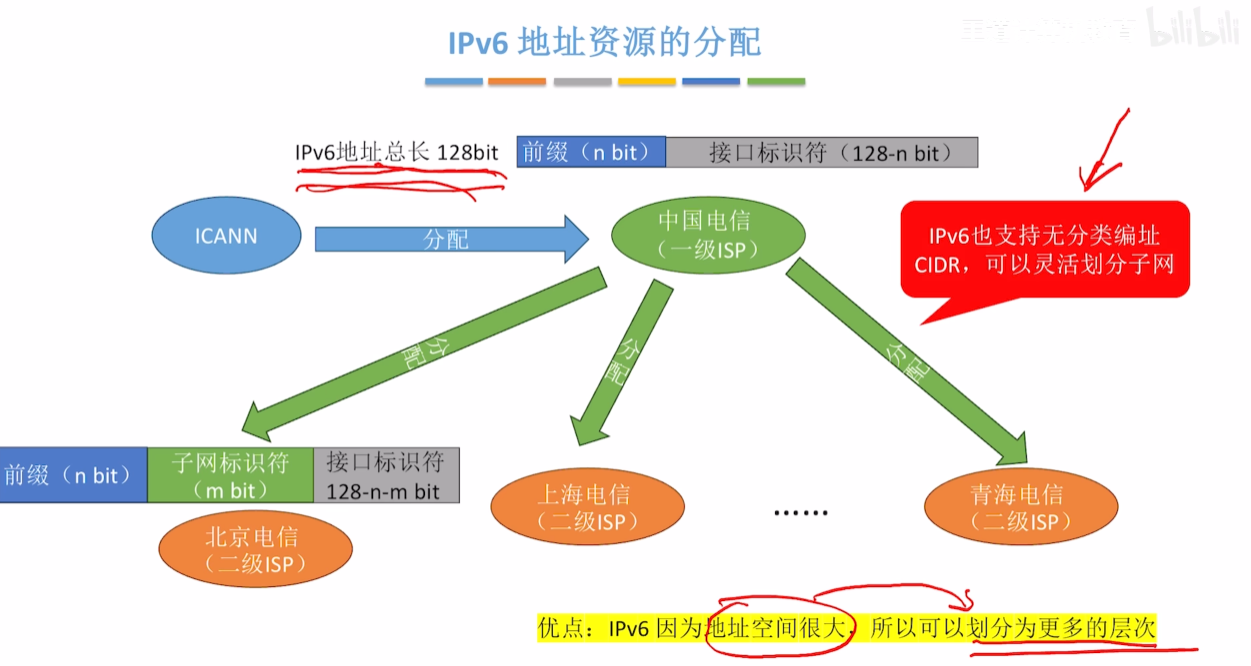
nbit前缀 + 128-n bit接口标识符
- 接口标识符可以接着层层分配的
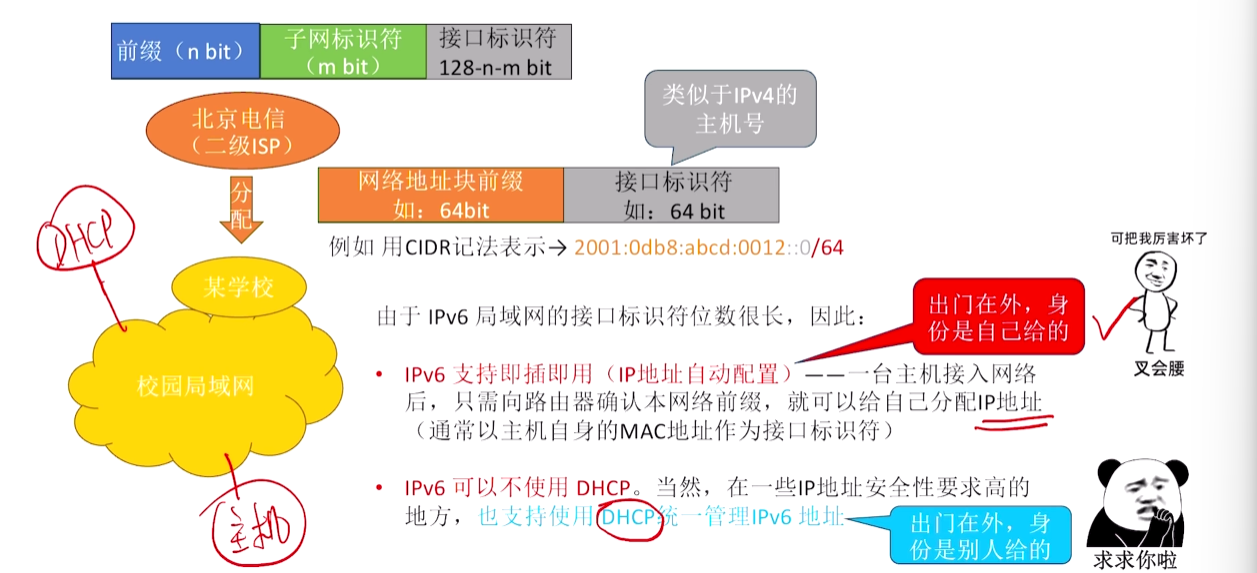
==IPv6支持即插即用(IP地址自动配置)==(通常把主机主机自身48位AMC地址作为接口标识符,唯一)(IPv4不支持即插即用)
IPv6可以不使用DHCP,也可以使用,安全性高。
I3.Pv6地址的分类
任播地址:任播的终点是一组计算机,但数据报只会交付其中的一台计算机,通常是距离最近的一台计算机。(eg多个DNS服务器共享一个任播地址)
地址类型:
- ① 未指明地址,
- ② 环回地址,
- ③ 多播地址,这类地址占IPv6的1/256
- ④ 本地链路单播地址,
- ⑤ 全球单播地址
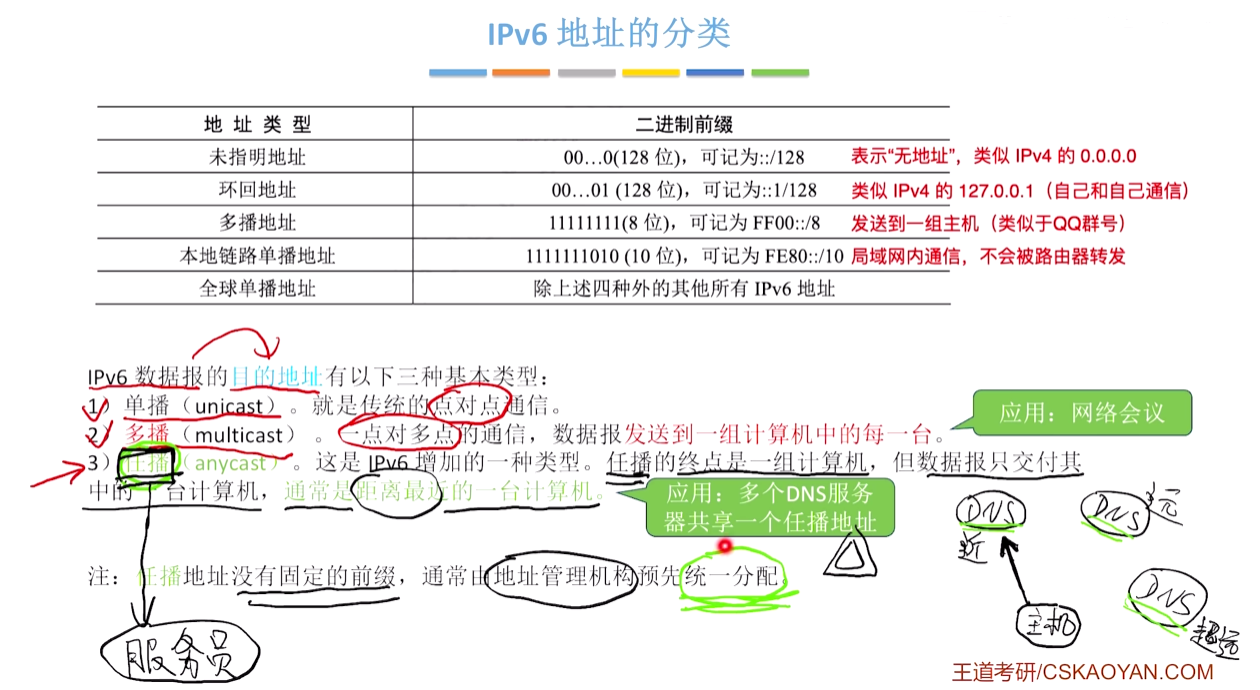
- 任播:数据报交付最近的一台主机。
回顾
==4.IPv6的特点:==
地址空间大:为IPv4的2^96倍
可划分多个层次
支持即插即用
IPv6只有源主机才能分片(⭐中间的路由器不能分片)
IPv6首部长度固定40B
⭐减少了首部字段数量,仅有8个字段
⭐取消首部检验和字段,不提供差错检验(传输层提供)
首部格式灵活,有可选的扩展首部
改进的选项放在有效载荷(有效数据)中。而IPv4将其放在首部的可变部分中。
允许协议继续扩充
支持资源的预分配
增加了安全性,身份鉴别由扩展首部提供。
5.IPv6数据报的基本首部
IPv6数据报由 ==基本首部==(40B) + ==有效载荷== 组成。
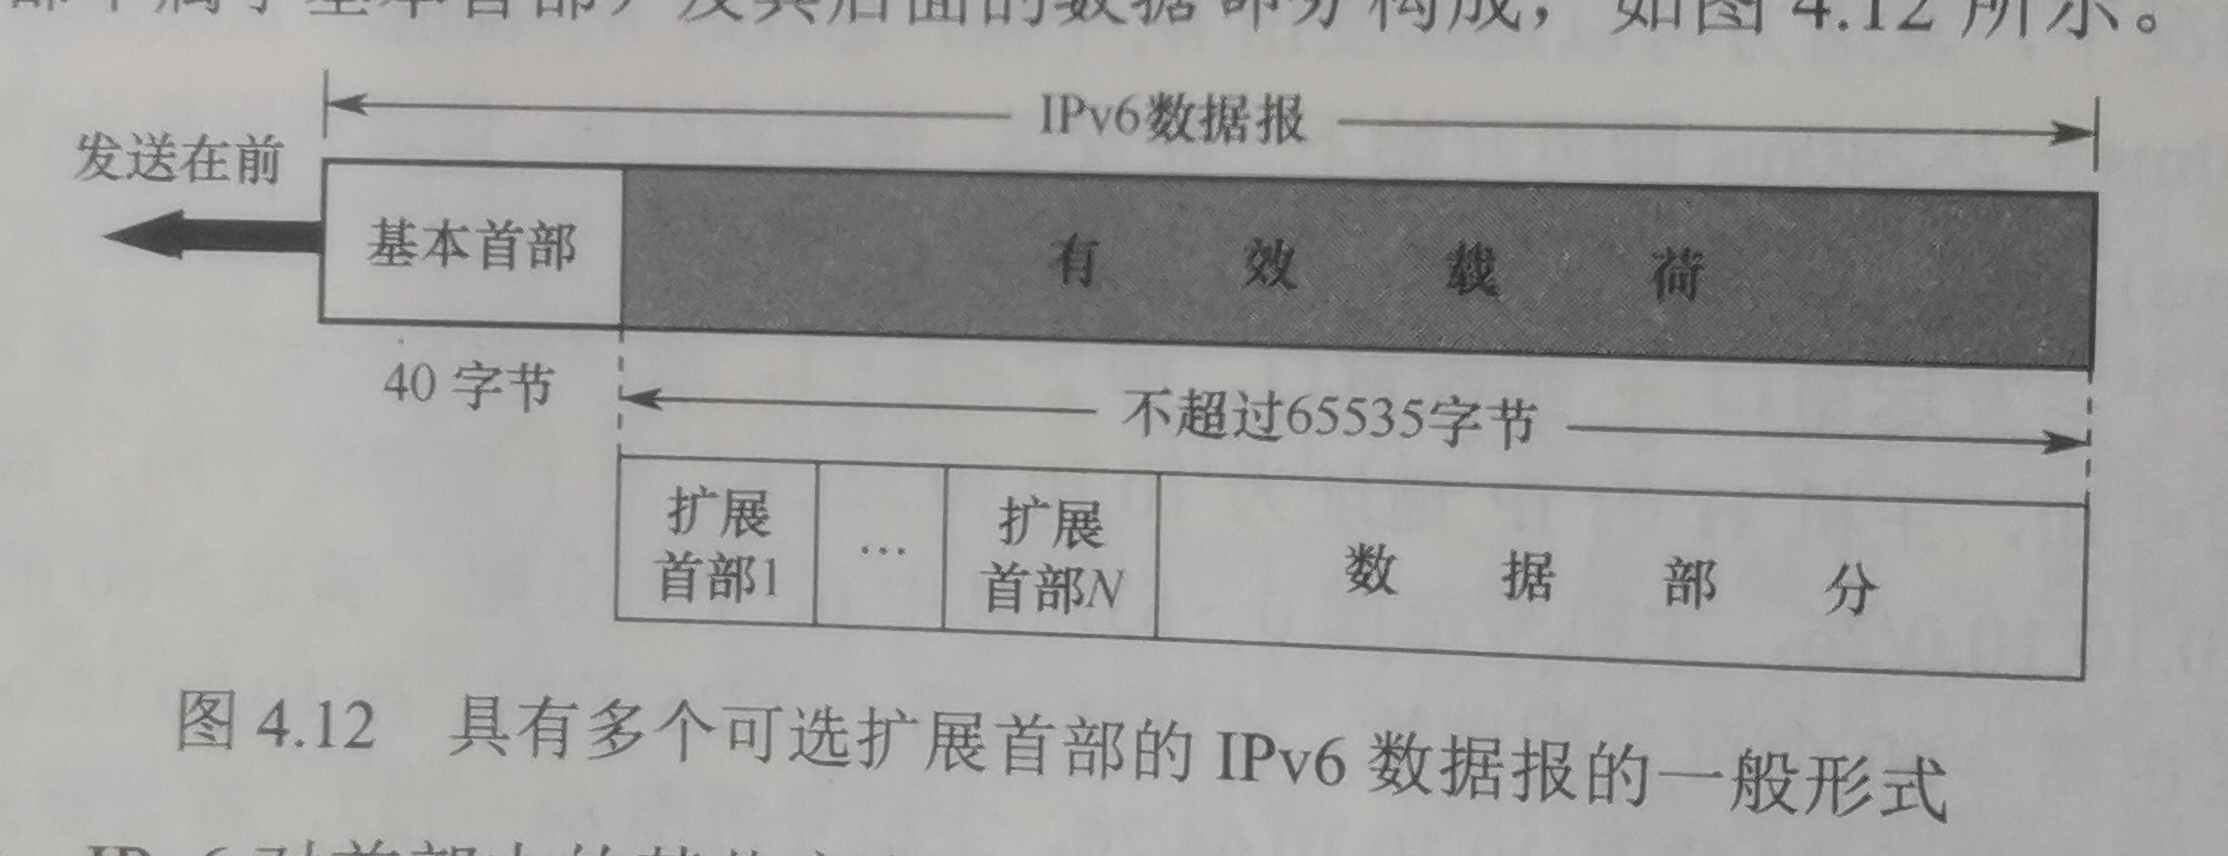
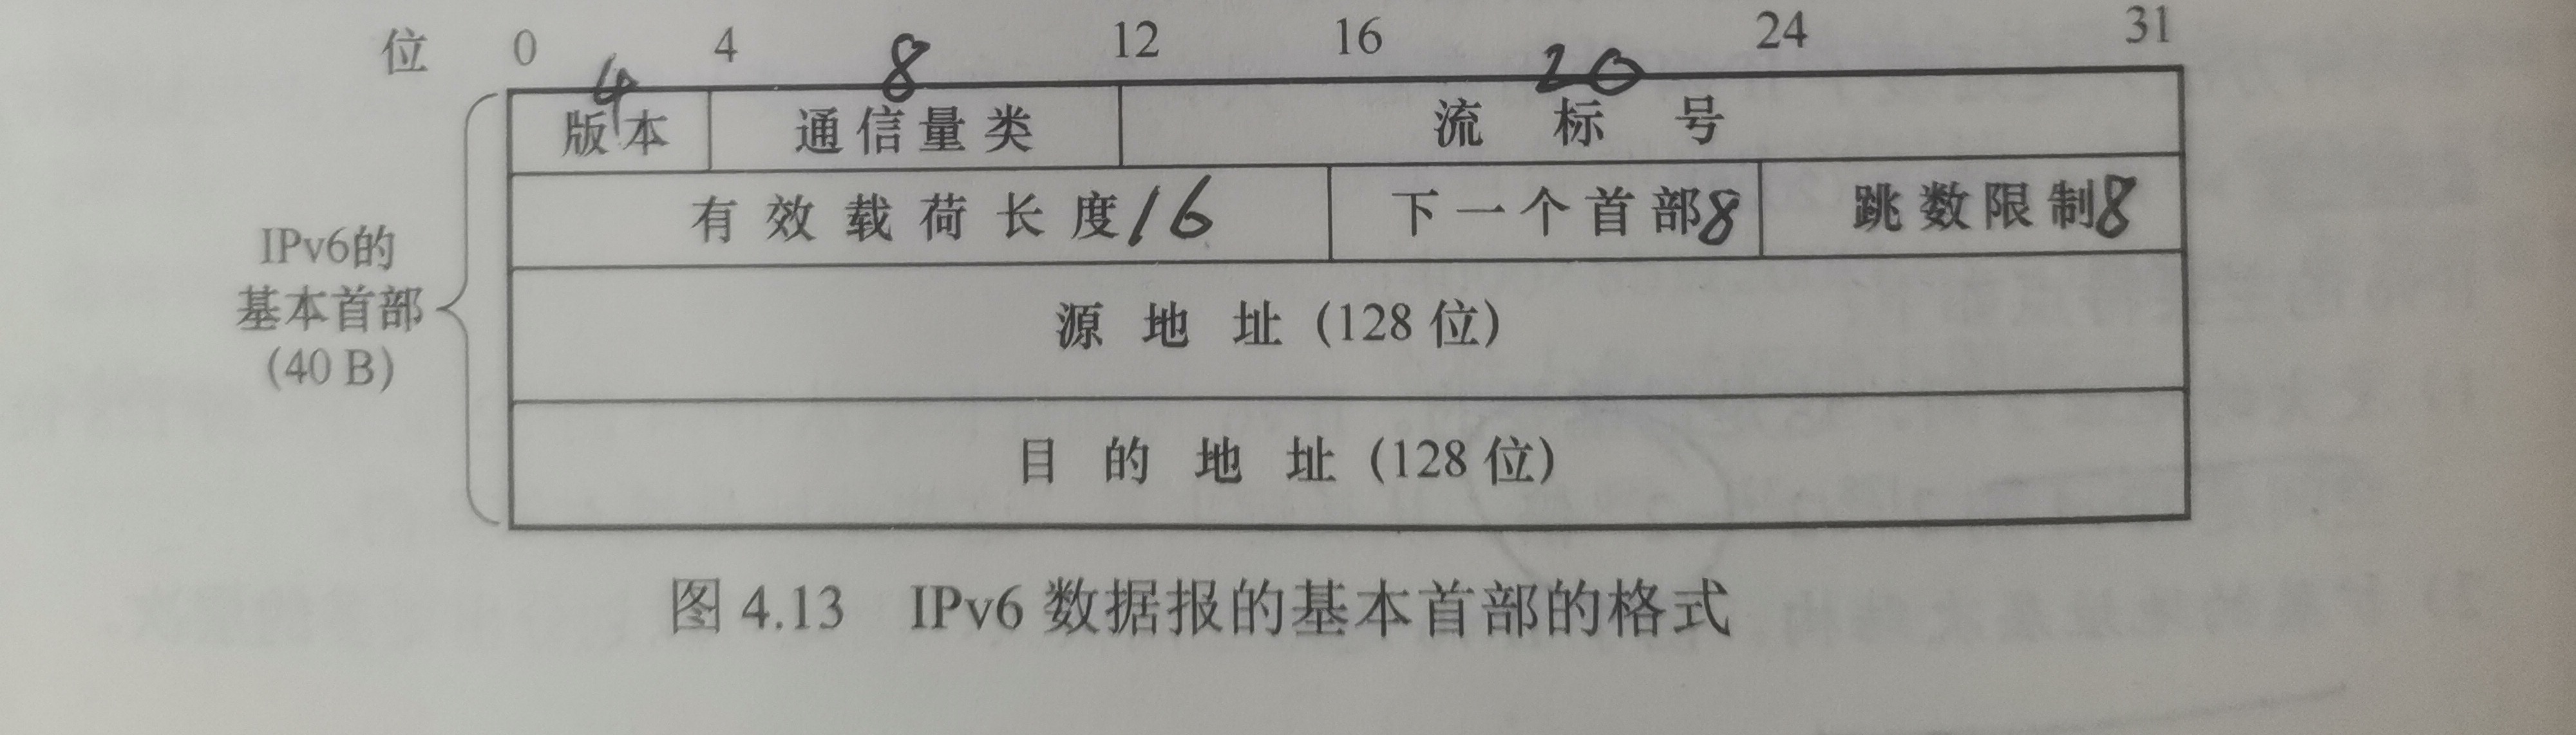
有效载荷长度:类似IPv4的“总长度”,也是16bit。
下一个首部:类似IPv4的协议字段。
跳数限制:类似IPv4的TTL。
(通信量类:区分不同IPv6数据报的类别或者优先级
(流编号:用于实时视频传输等,保证传输质量。
6.从IPv4向IPv6过渡
双协议栈:一台主机同时安装IPv4和IPv6两个协议栈,分别配置一个IPv4地址和一个IPv6地址。
隧道技术:当IPv6数据报需要接入IPv4网络时,将其封装为IPv4数据报的数据部分,使原IPv6数据报如同在IPv4网络的隧道传输。
4.4 路由算法和路由协议
① 路由算法
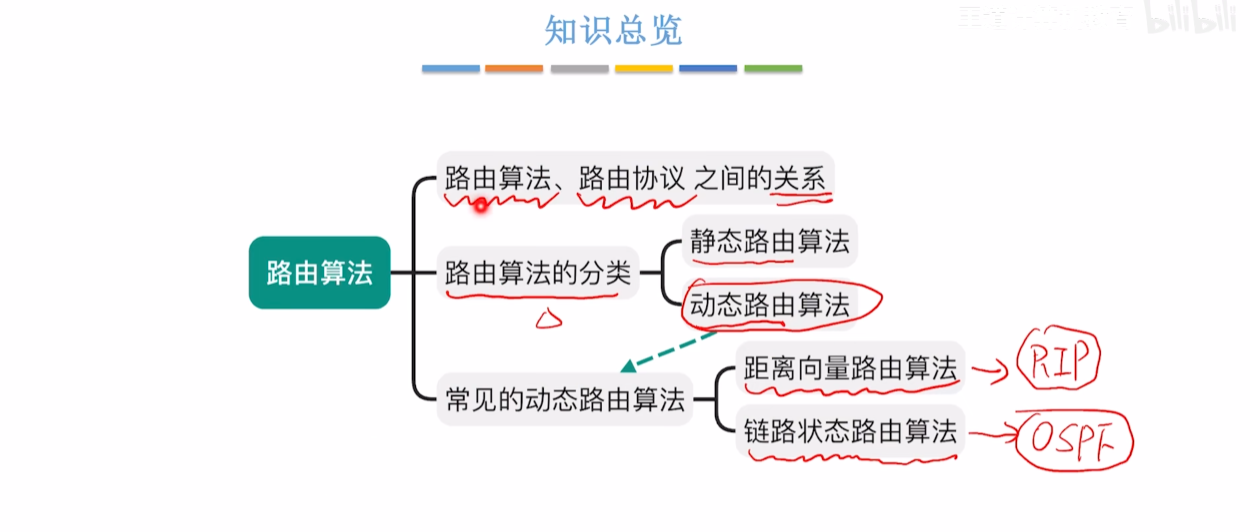
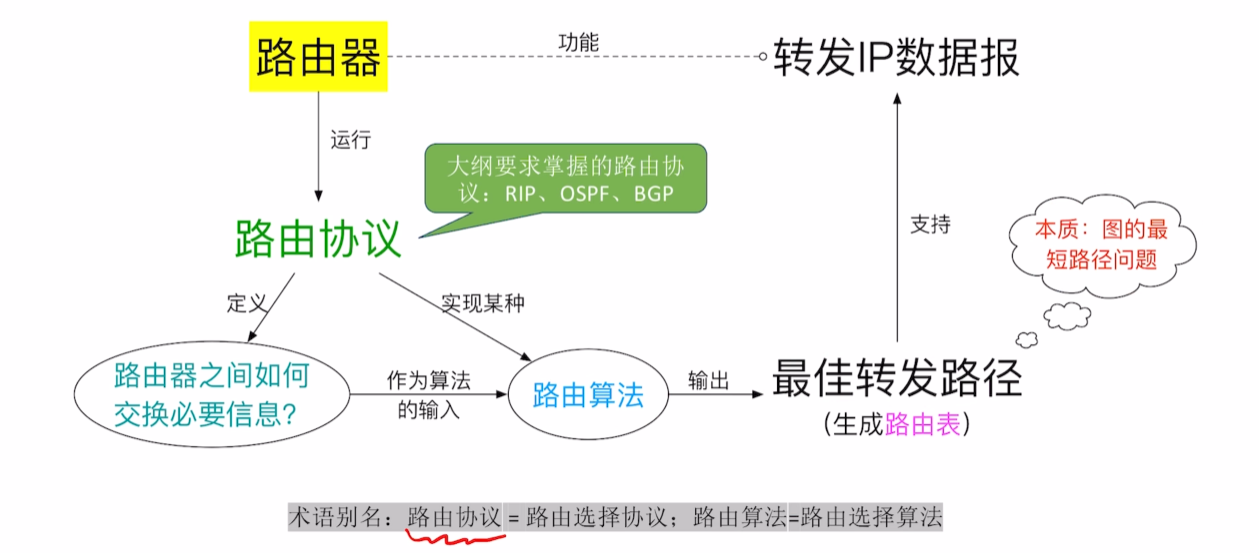
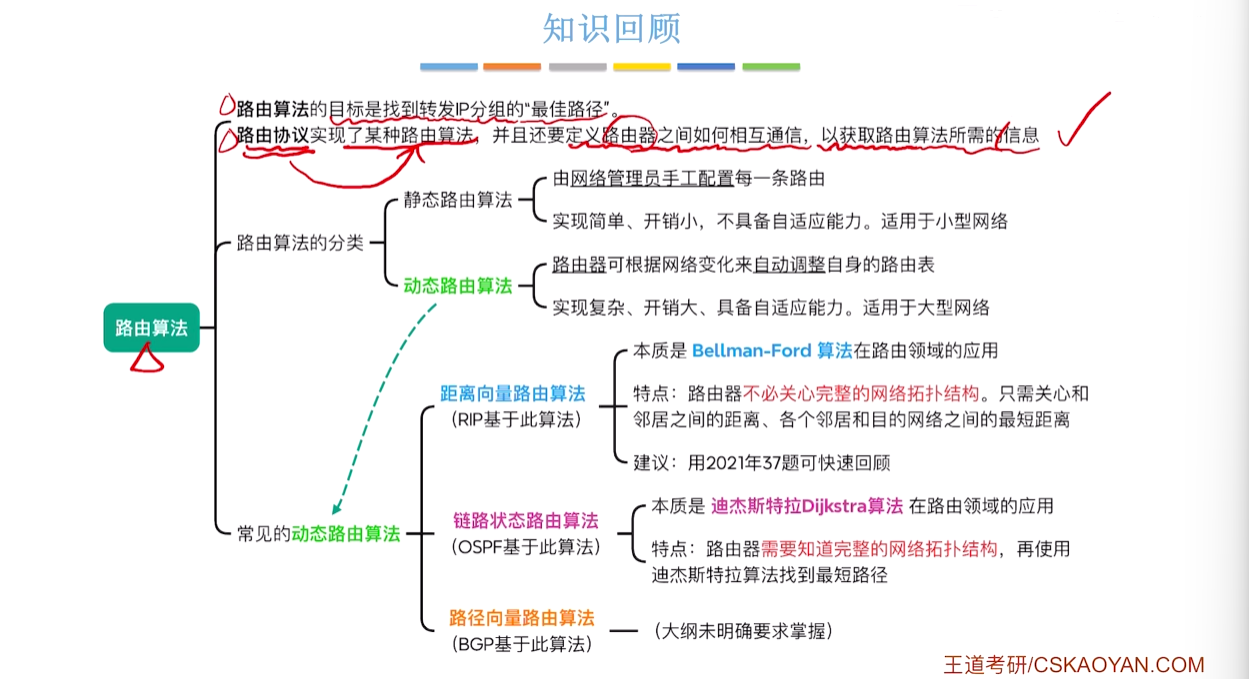
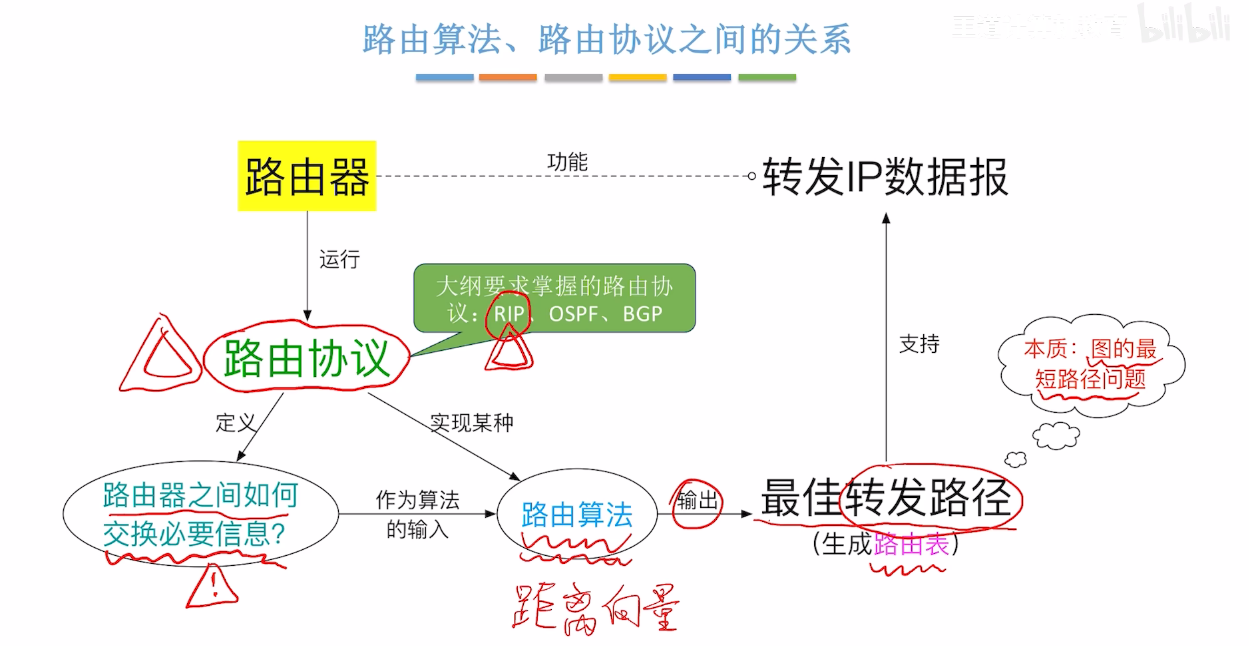
1. 路由算法和路由协议之间的关系
==路由协议==(规定路由器之间如何通信,以获取路由算法所需的信息)
→输入进==路由算法==(目标:找到转发IP分组(源路由器到目的路由器)的最短路径)
→生成==路由表==(得到最佳转发路径)
2. 路由算法的分类
本质是“图的最短路径问题”
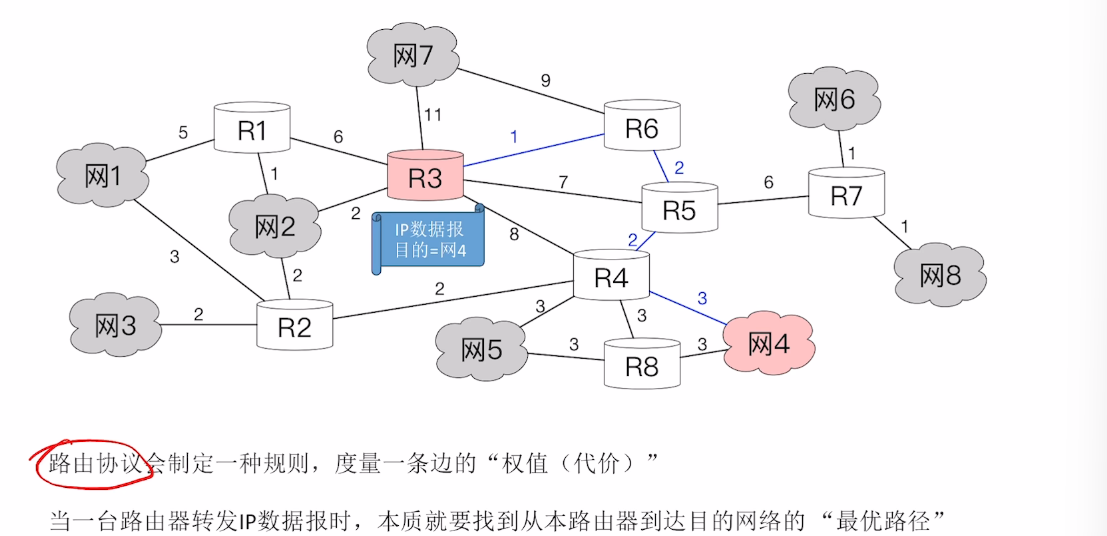
① ==静态路由算法==:手工配置每一条路由(只适合小型网络)==(不会自动调整,但不是不能调整)==
② ==动态路由算法==:路由器根据 网络流量负载 和 拓朴结构 来动态调整自身的路由表
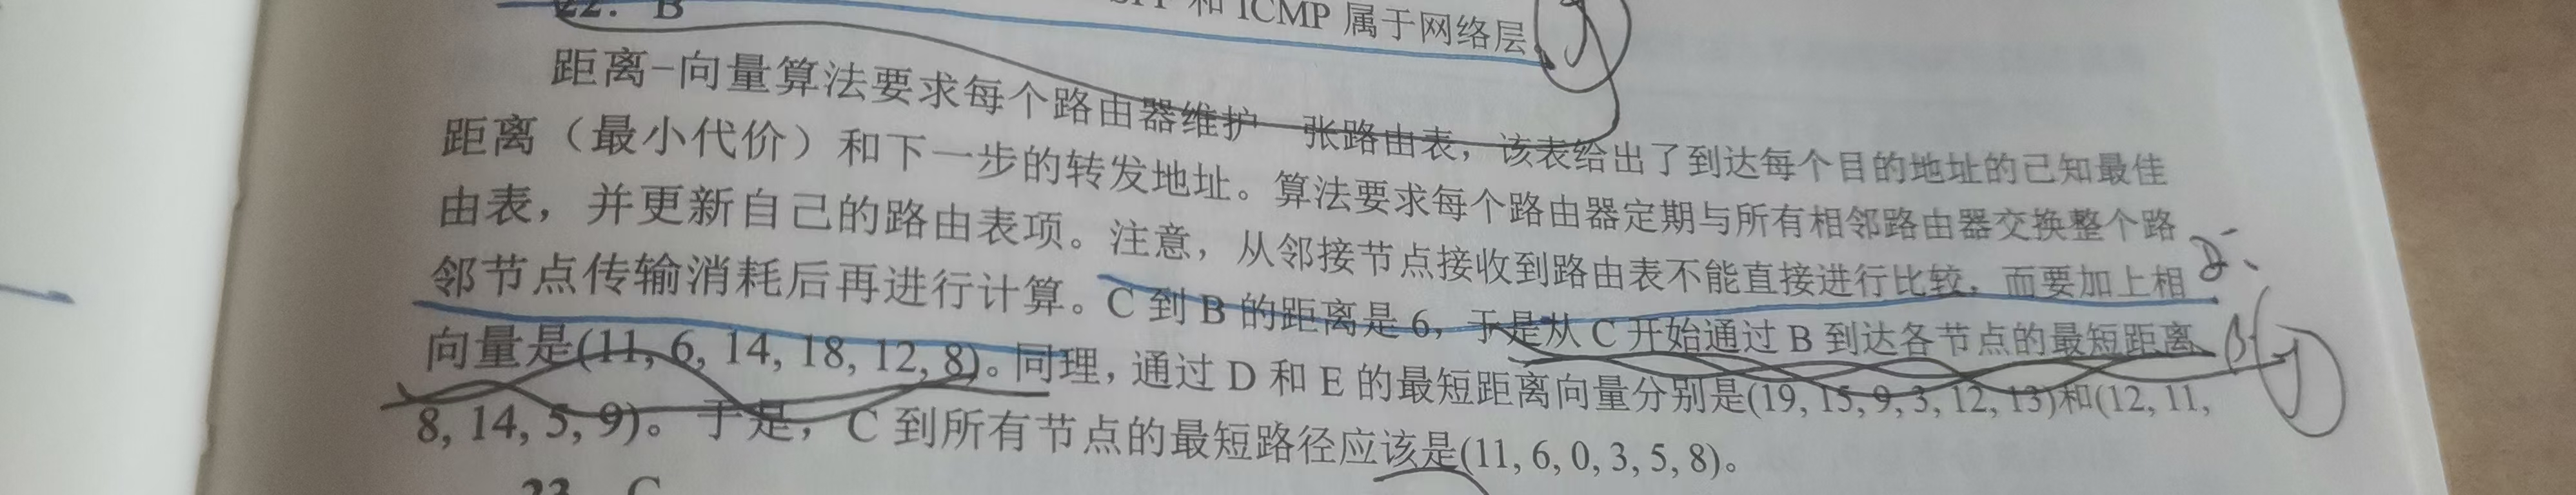
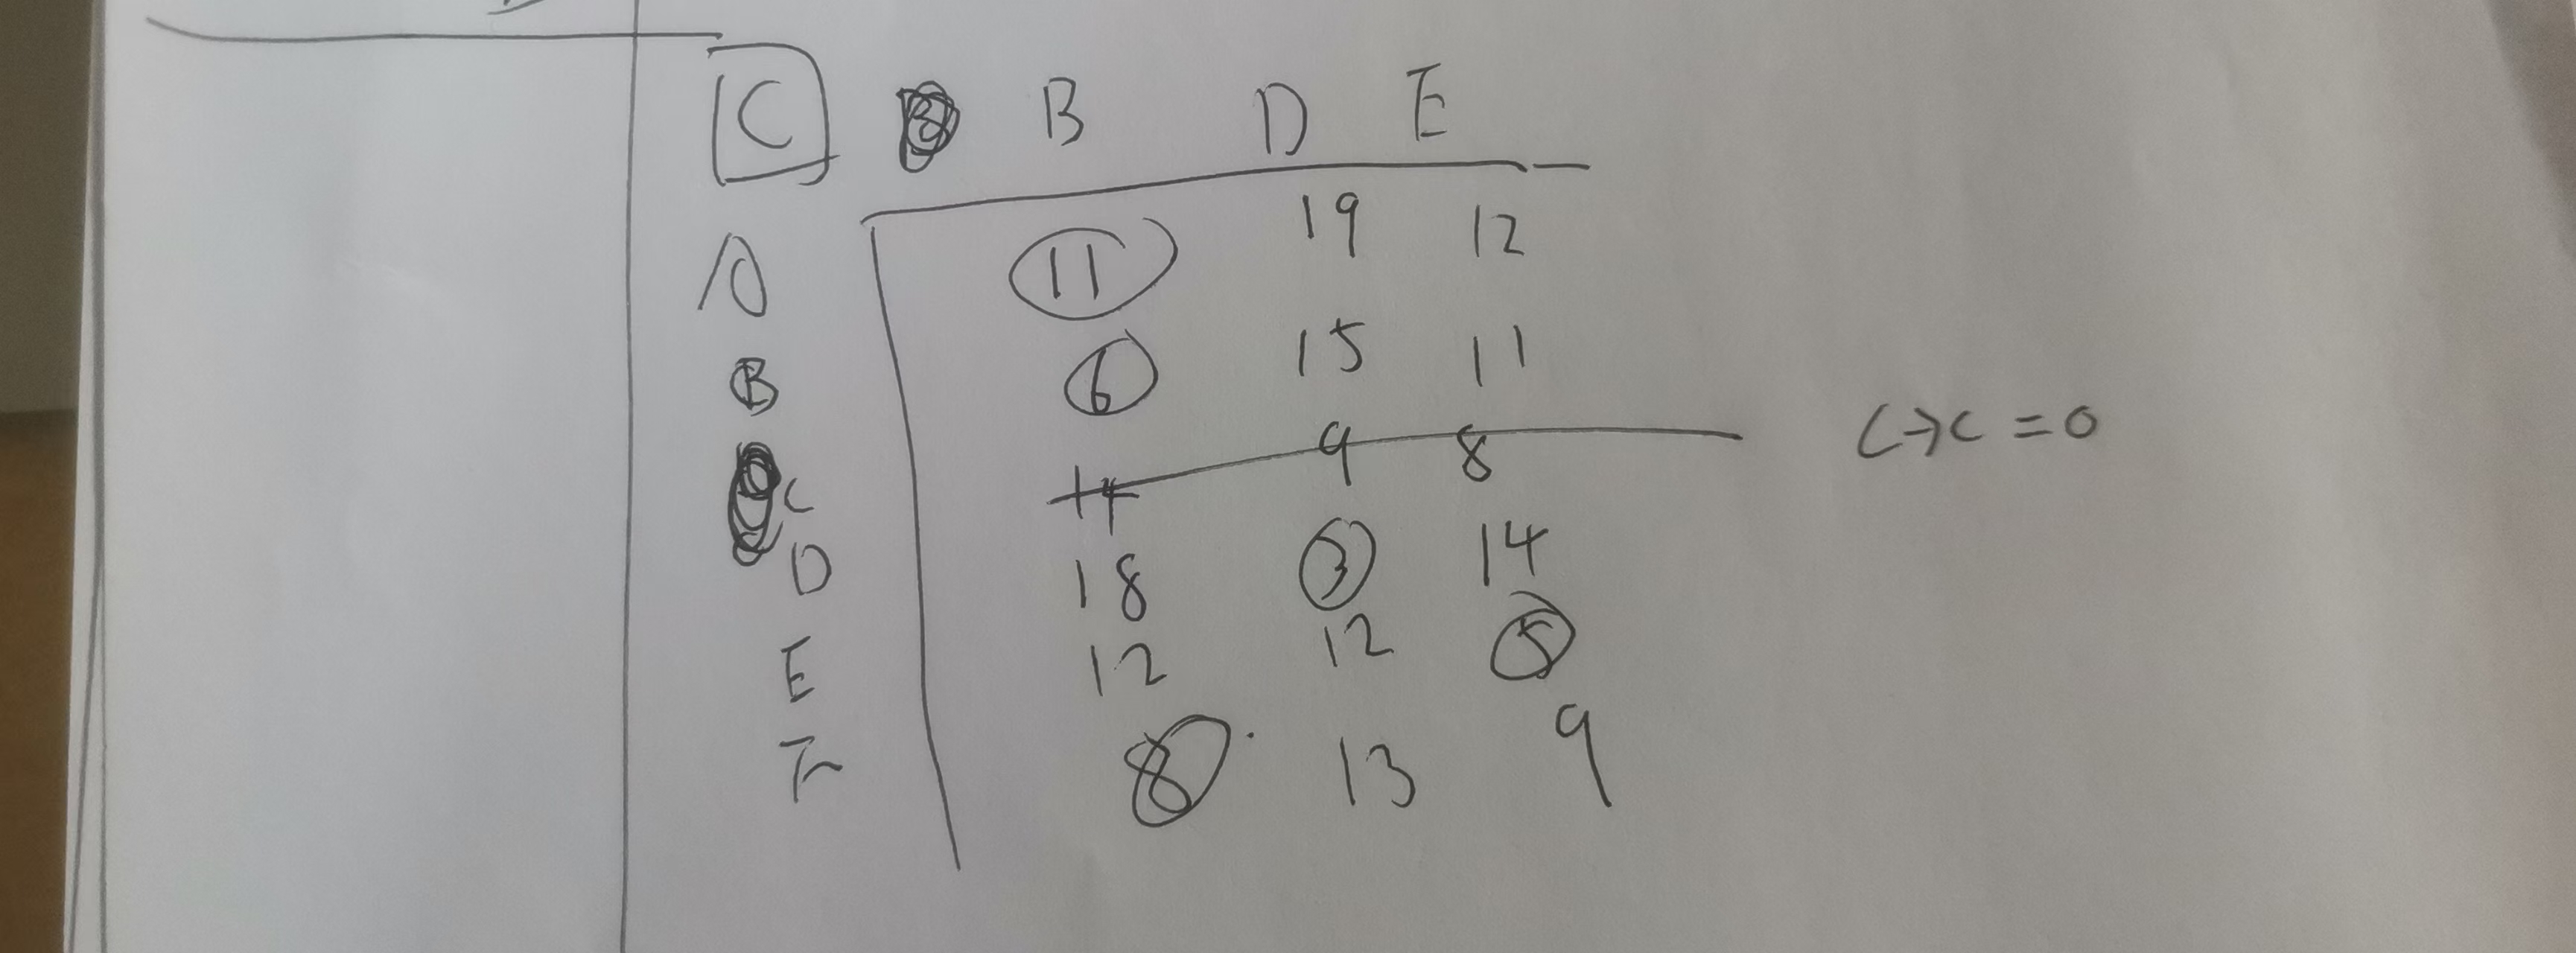
- a.距离-向量路由算法(RIP协议基于此算法),
- b.链路状态路由算法(OSFP协议基于此算法),
- c.路径-向量路由算法(BGP协议基于此算法)(op)
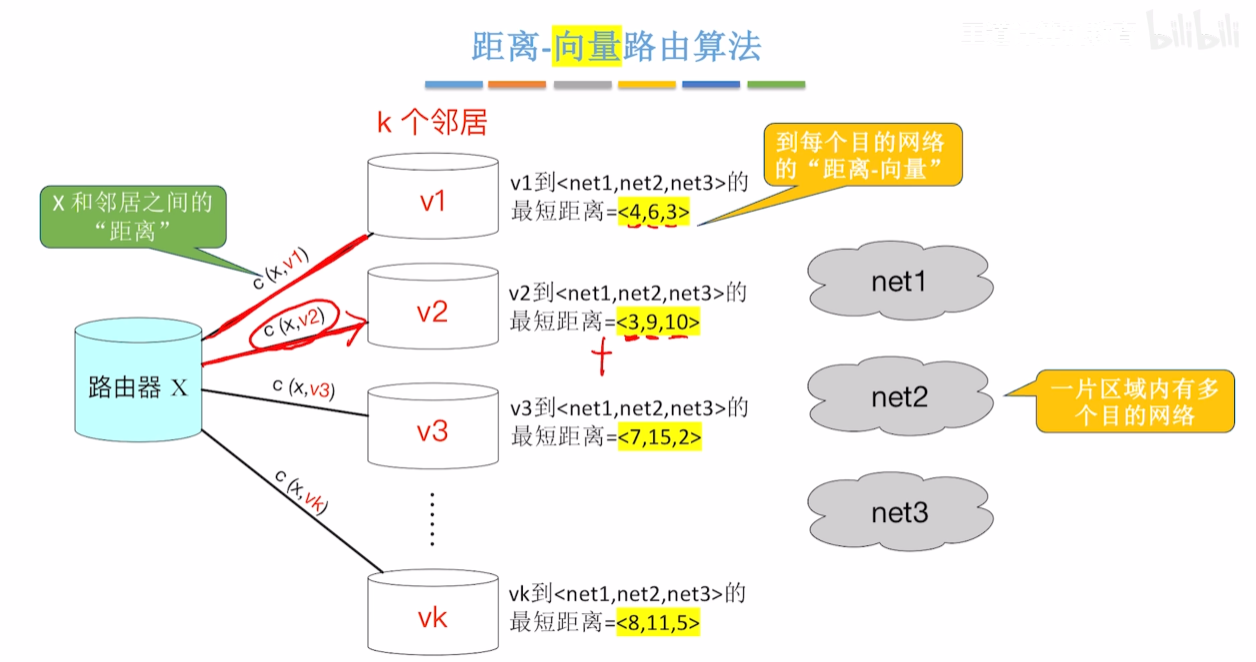
a.距离-向量路由算法
算法特点:不必了解完整的网络拓扑结构,
只需要关注:你到相邻的节点,相邻节点到目的节点之间的最短距离,
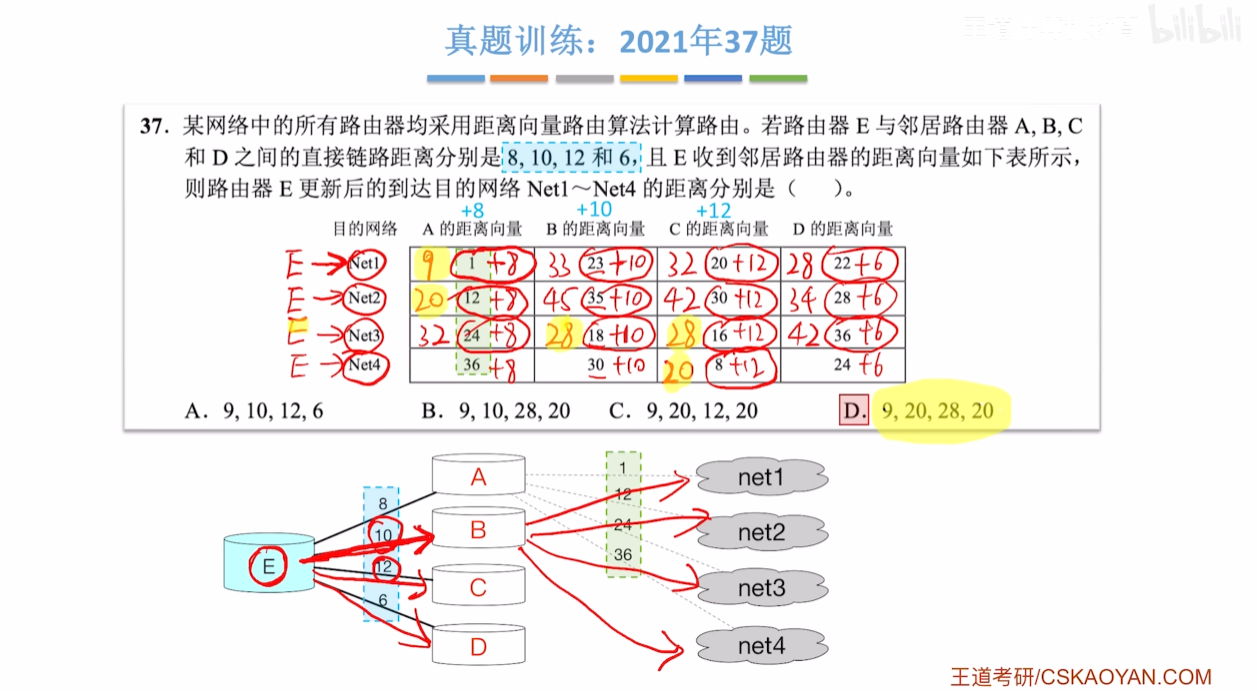
最后使用Ford算法算出最短路径。
- 距离:X到netx的最短距离,min{ X和邻居之间的距离 + Vi到netx的最短距离 }
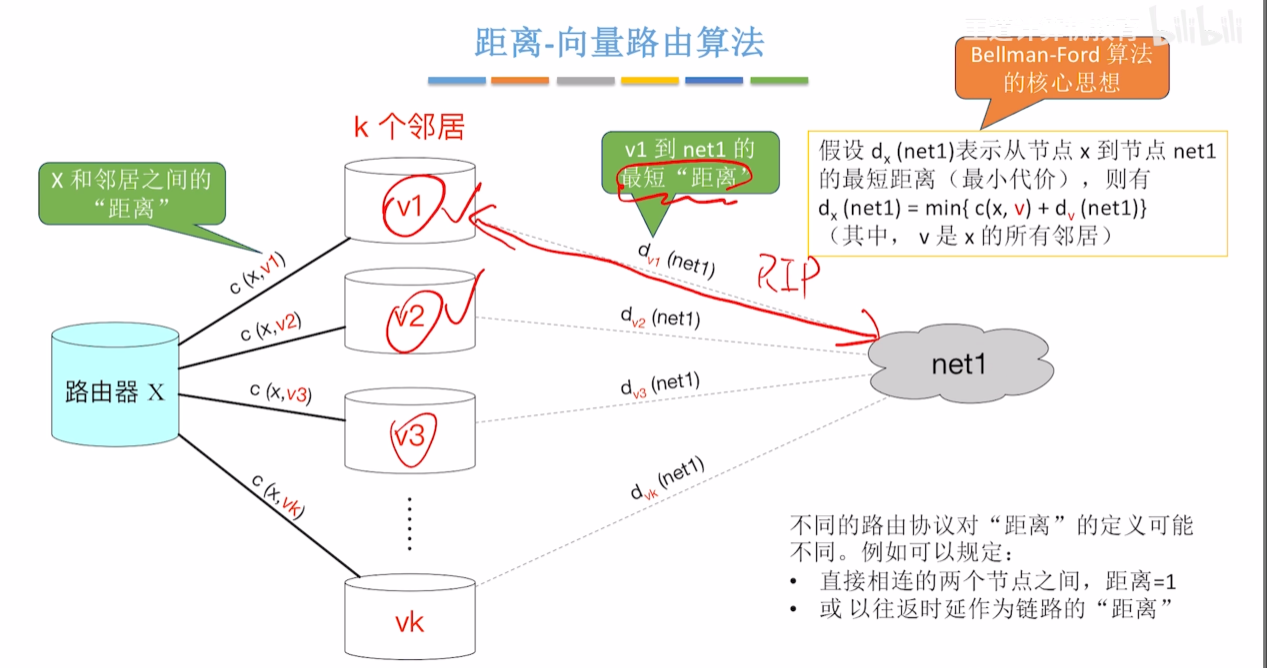
- 向量:如果有多个网络,就有到多个目的网络的多个最短距离/向量。
b.链路状态路由算法
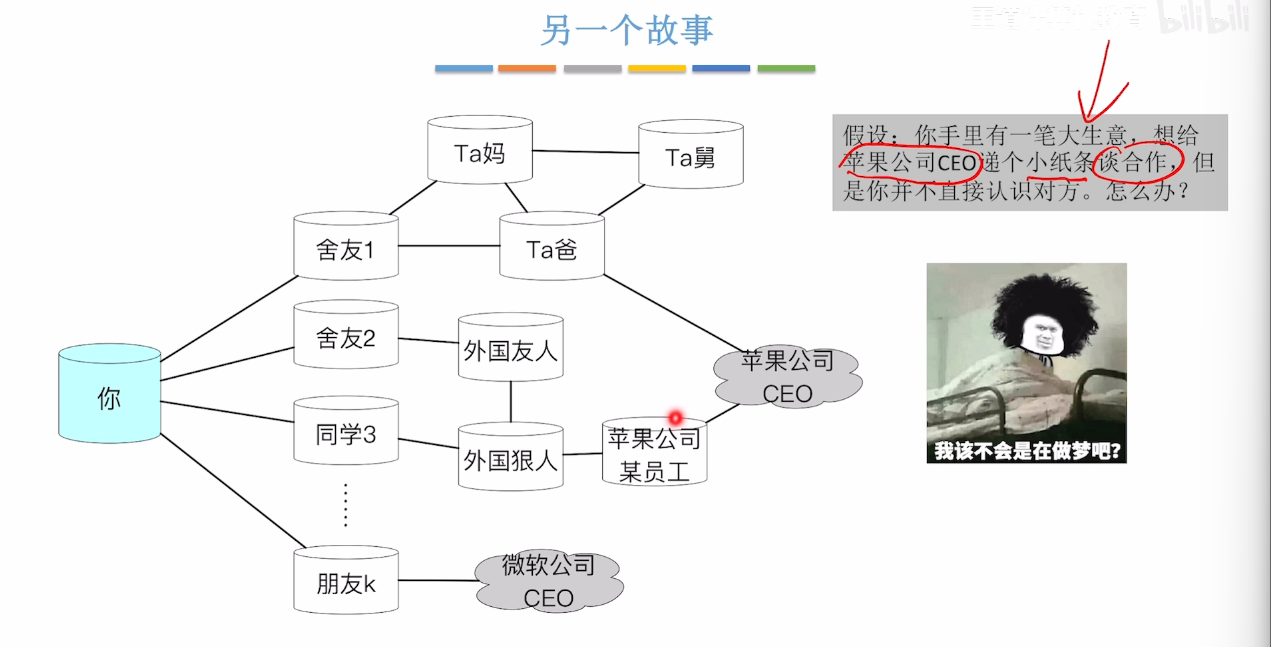
算法特点:让路由器弄明白完整的网络拓扑结构,就可以使用Djsk算法,找到最短路径。
回顾
② 分层次的路由协议
思考:RIP,OSPF是否适用全世界范围的路由器?
RIP路由协议(基于距离向量路由算法)。网络数量越多,距离向量越大。
OSPF路由协议(基于链路状态路由算法)。要求每一台路由器都要建立整个网络的拓扑图。
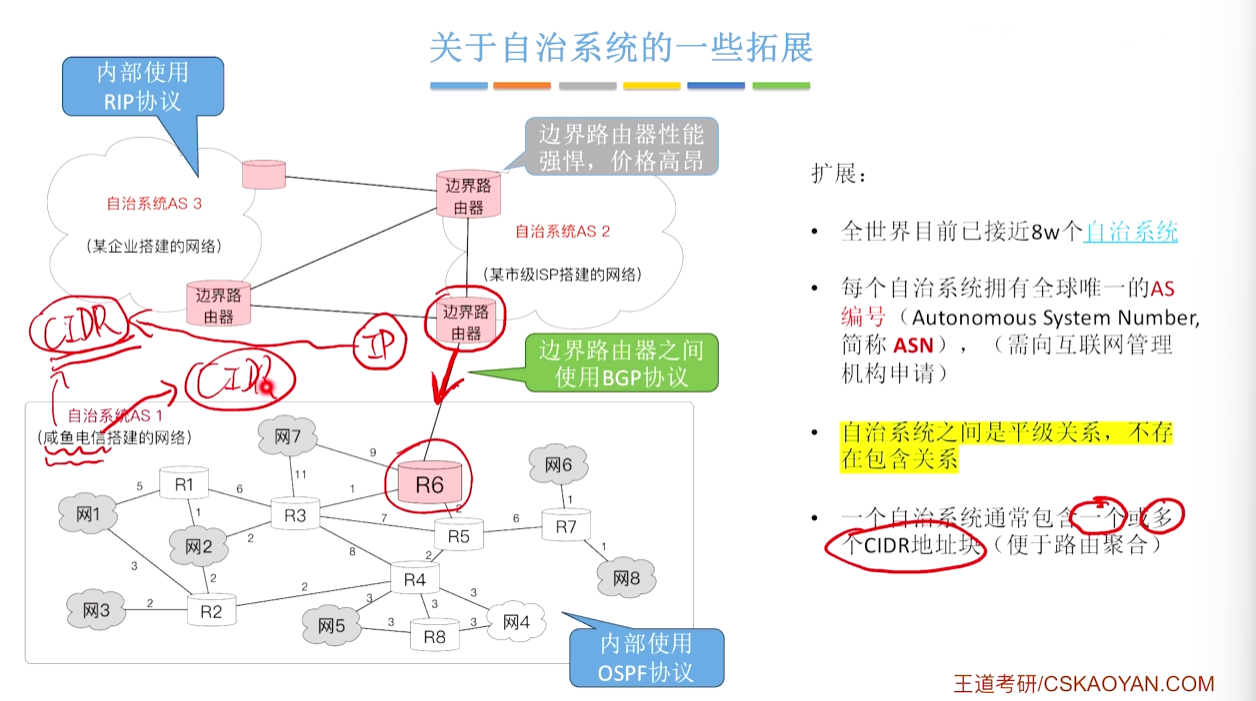
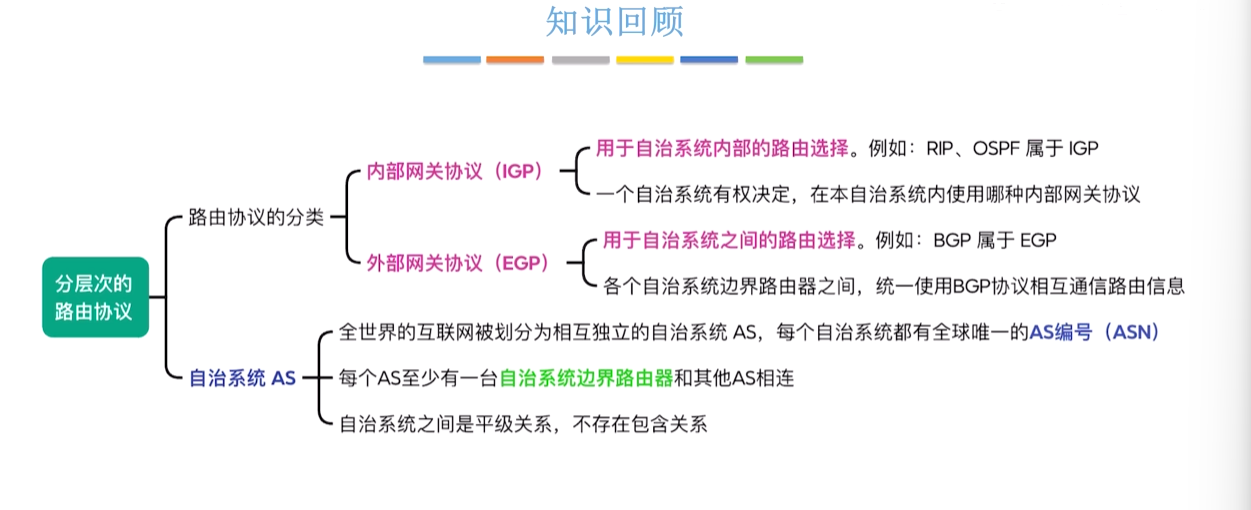
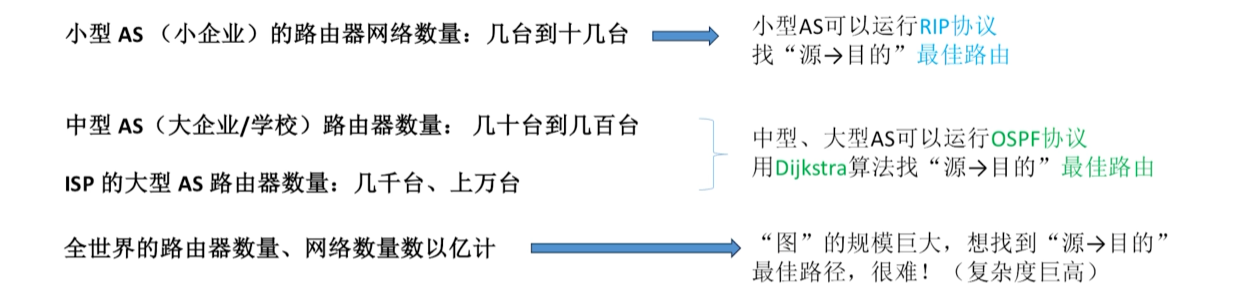
将全世界的网络划分为多个相互独立的自治系统AS。(唯一的编号ASN)
AS的管理单位有权决定在本AS内,使用何种内部路由协议(RIP,OSPF..)
每一个AS至少有一台AS边界路由器,与其他AS相连。各个边界路由器之间,使用统一的外部路由协议。
AS之间的路由选择也称 域间路由选择,AS内部的路由选择称为 域内路由选择。
一个AS通常包含一个或多个CIDR地址块(便于路由聚合)
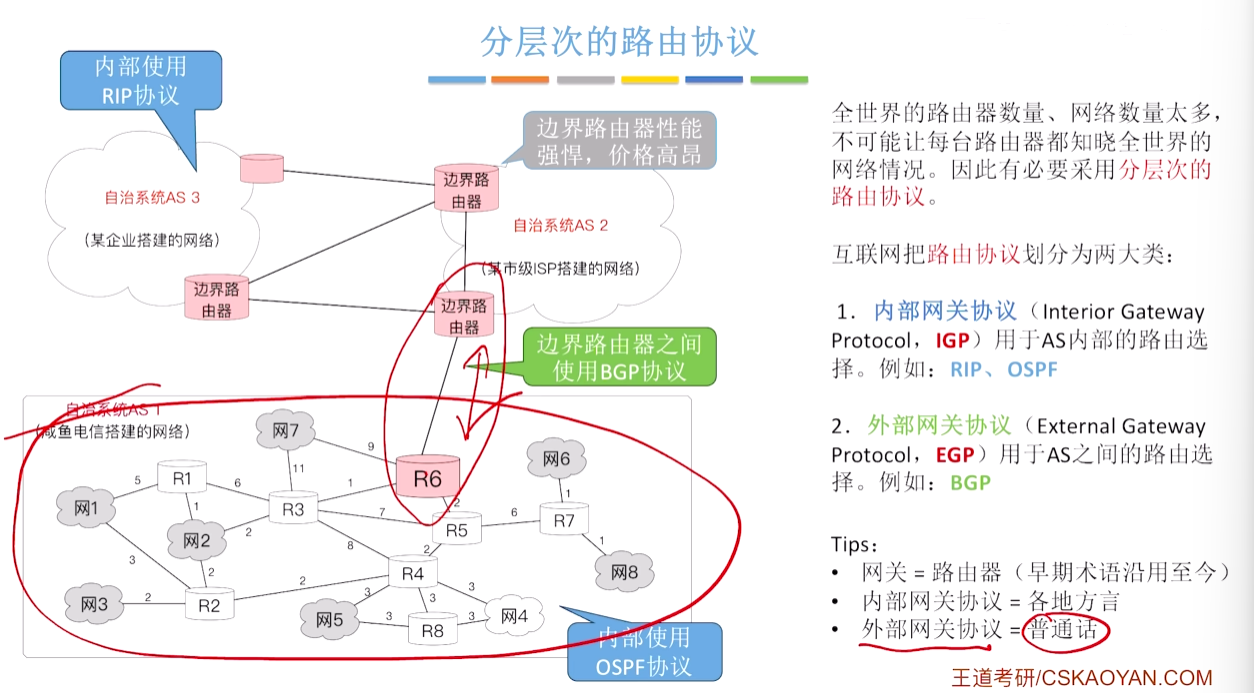
路由协议分为:
- 内部网关协议 IGP(内部路由协议):用于AS内部的路由选择(如RIP,OSPF)(方言
- 外部网关协议 EGP(外部路由协议):用于AS之间的路由选择(如BGP)(普通话)
回顾
③ RIP 路由信息协议
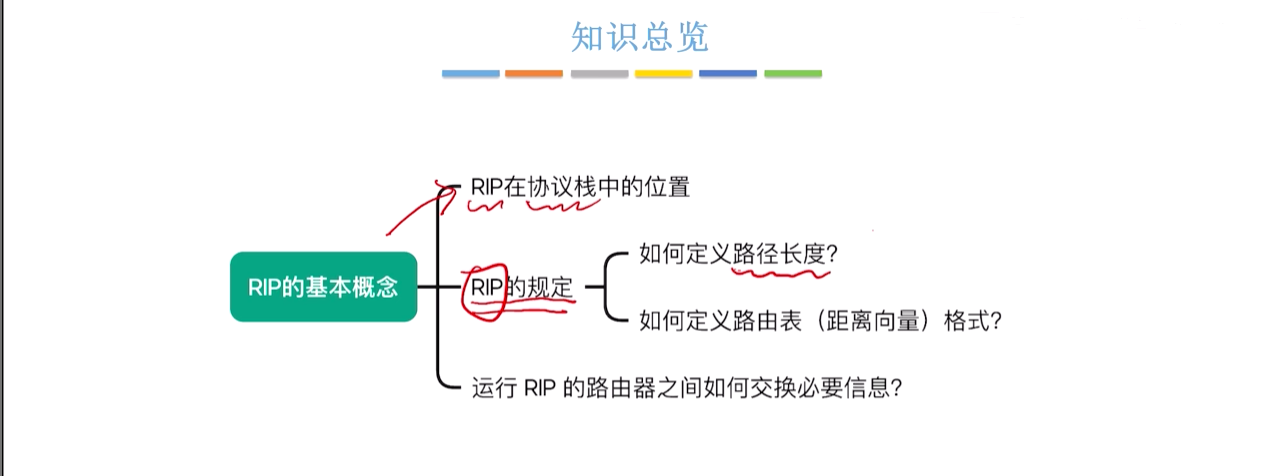
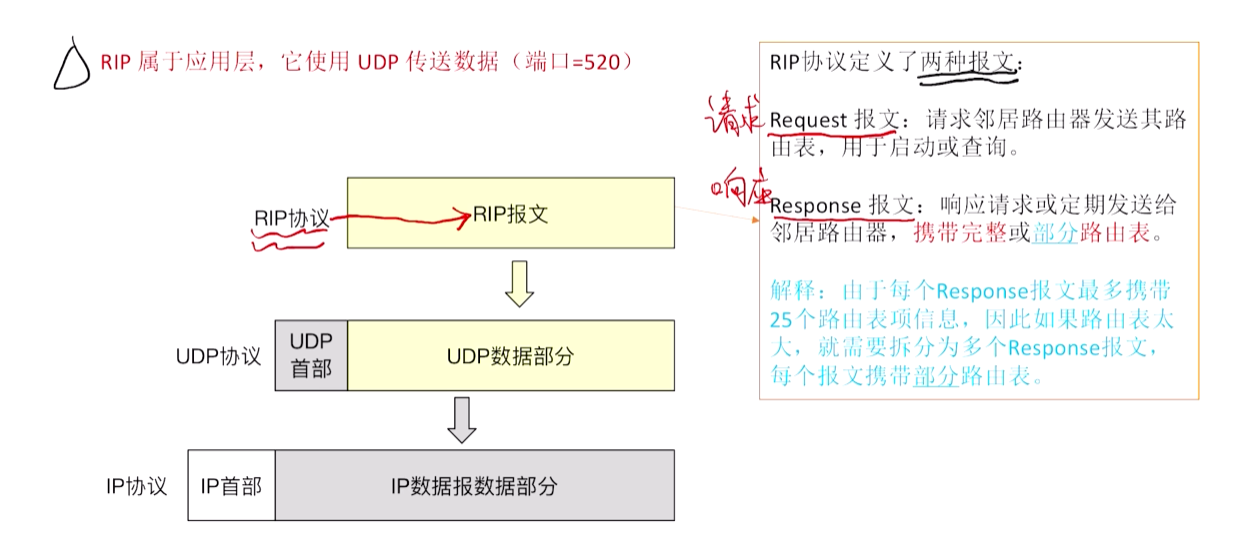
RIP协议在协议栈中的位置
- ==RIP属于应用层,它使用UDP传送数据==(端口520)
- RIP协议定义了两种报文:Request报文,Response报文
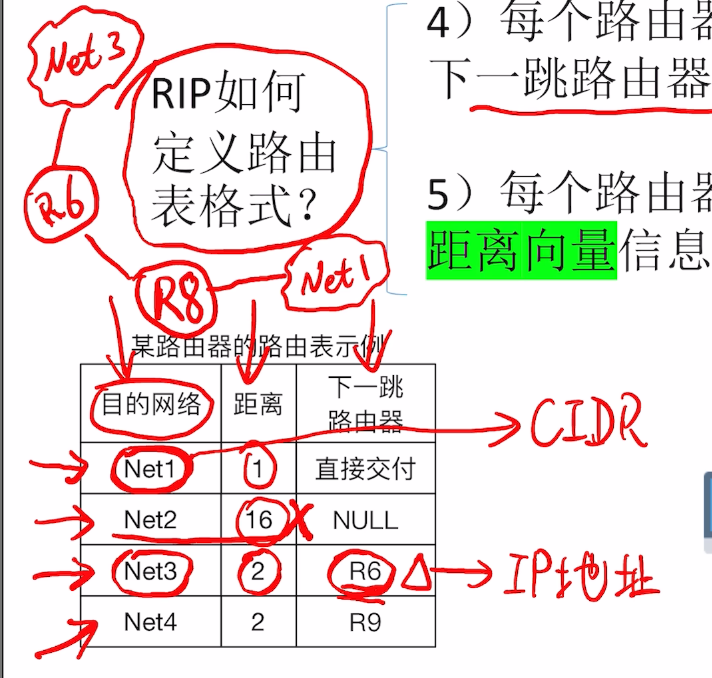
RIP的规定
路径长度:
- ① RIP使用跳数/距离来衡量到达目的网络的距离。(越少越好)
- 注:规定路由器到直连网络的距离为1。
- ② RIP合法路径距离≤15。(可见RIP只适合小型自治系统)
路由器格式:
- ① 每一个路由器都要维护自己的路由表。
- 路由表项 :<目的网络N,**距离d**,下一条路由器地址X>
- ② 每一个路由器都要维护它自身到其他每个目的网络的距离记录,即距离向量d。
运行RIP的路由器 之间 如何交换必要信息?
who:直接的相邻的路由器
what:发送自己的完整路由表(里面就有距离向量)(路由表被封装在response报文里)
when:固定时间间隔(30s)
(为了加快逐步生成的路由表,可以引入 触发更新:当路由器路由表发送变化时,迅速把自己的路由表发送给邻居)
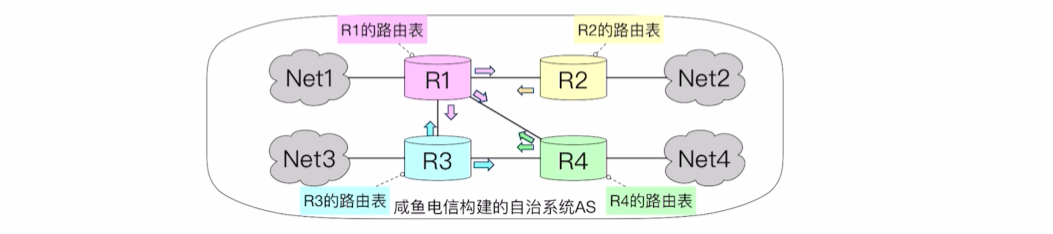
RIP的工作过程示例1(从路由器启动到收敛)
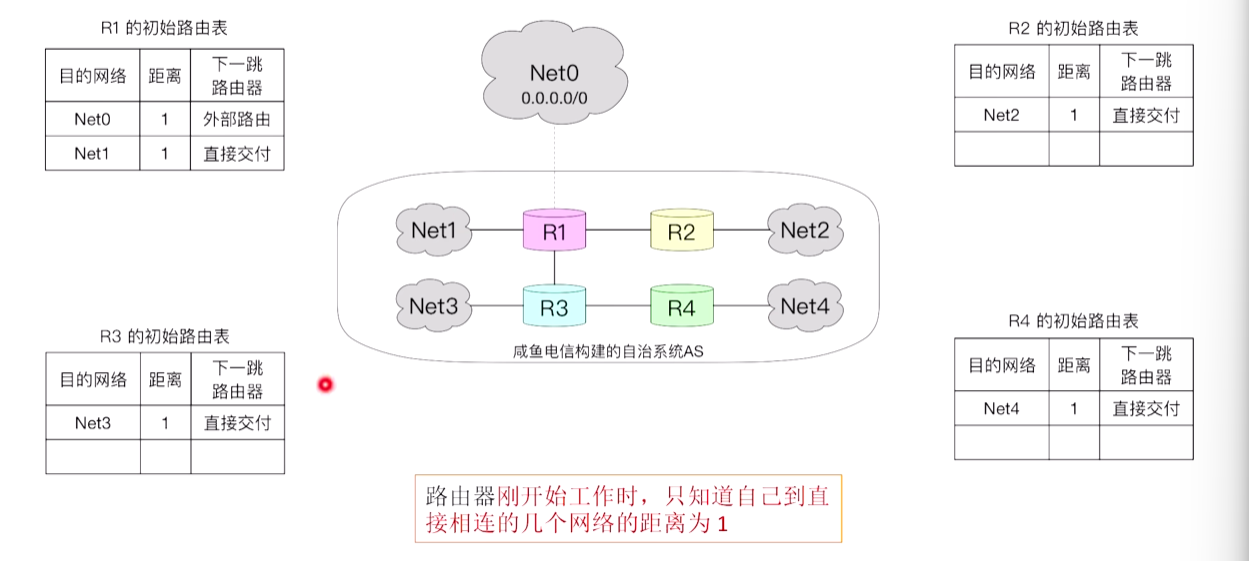
初始:各路由器同时开机,构建初始路由表
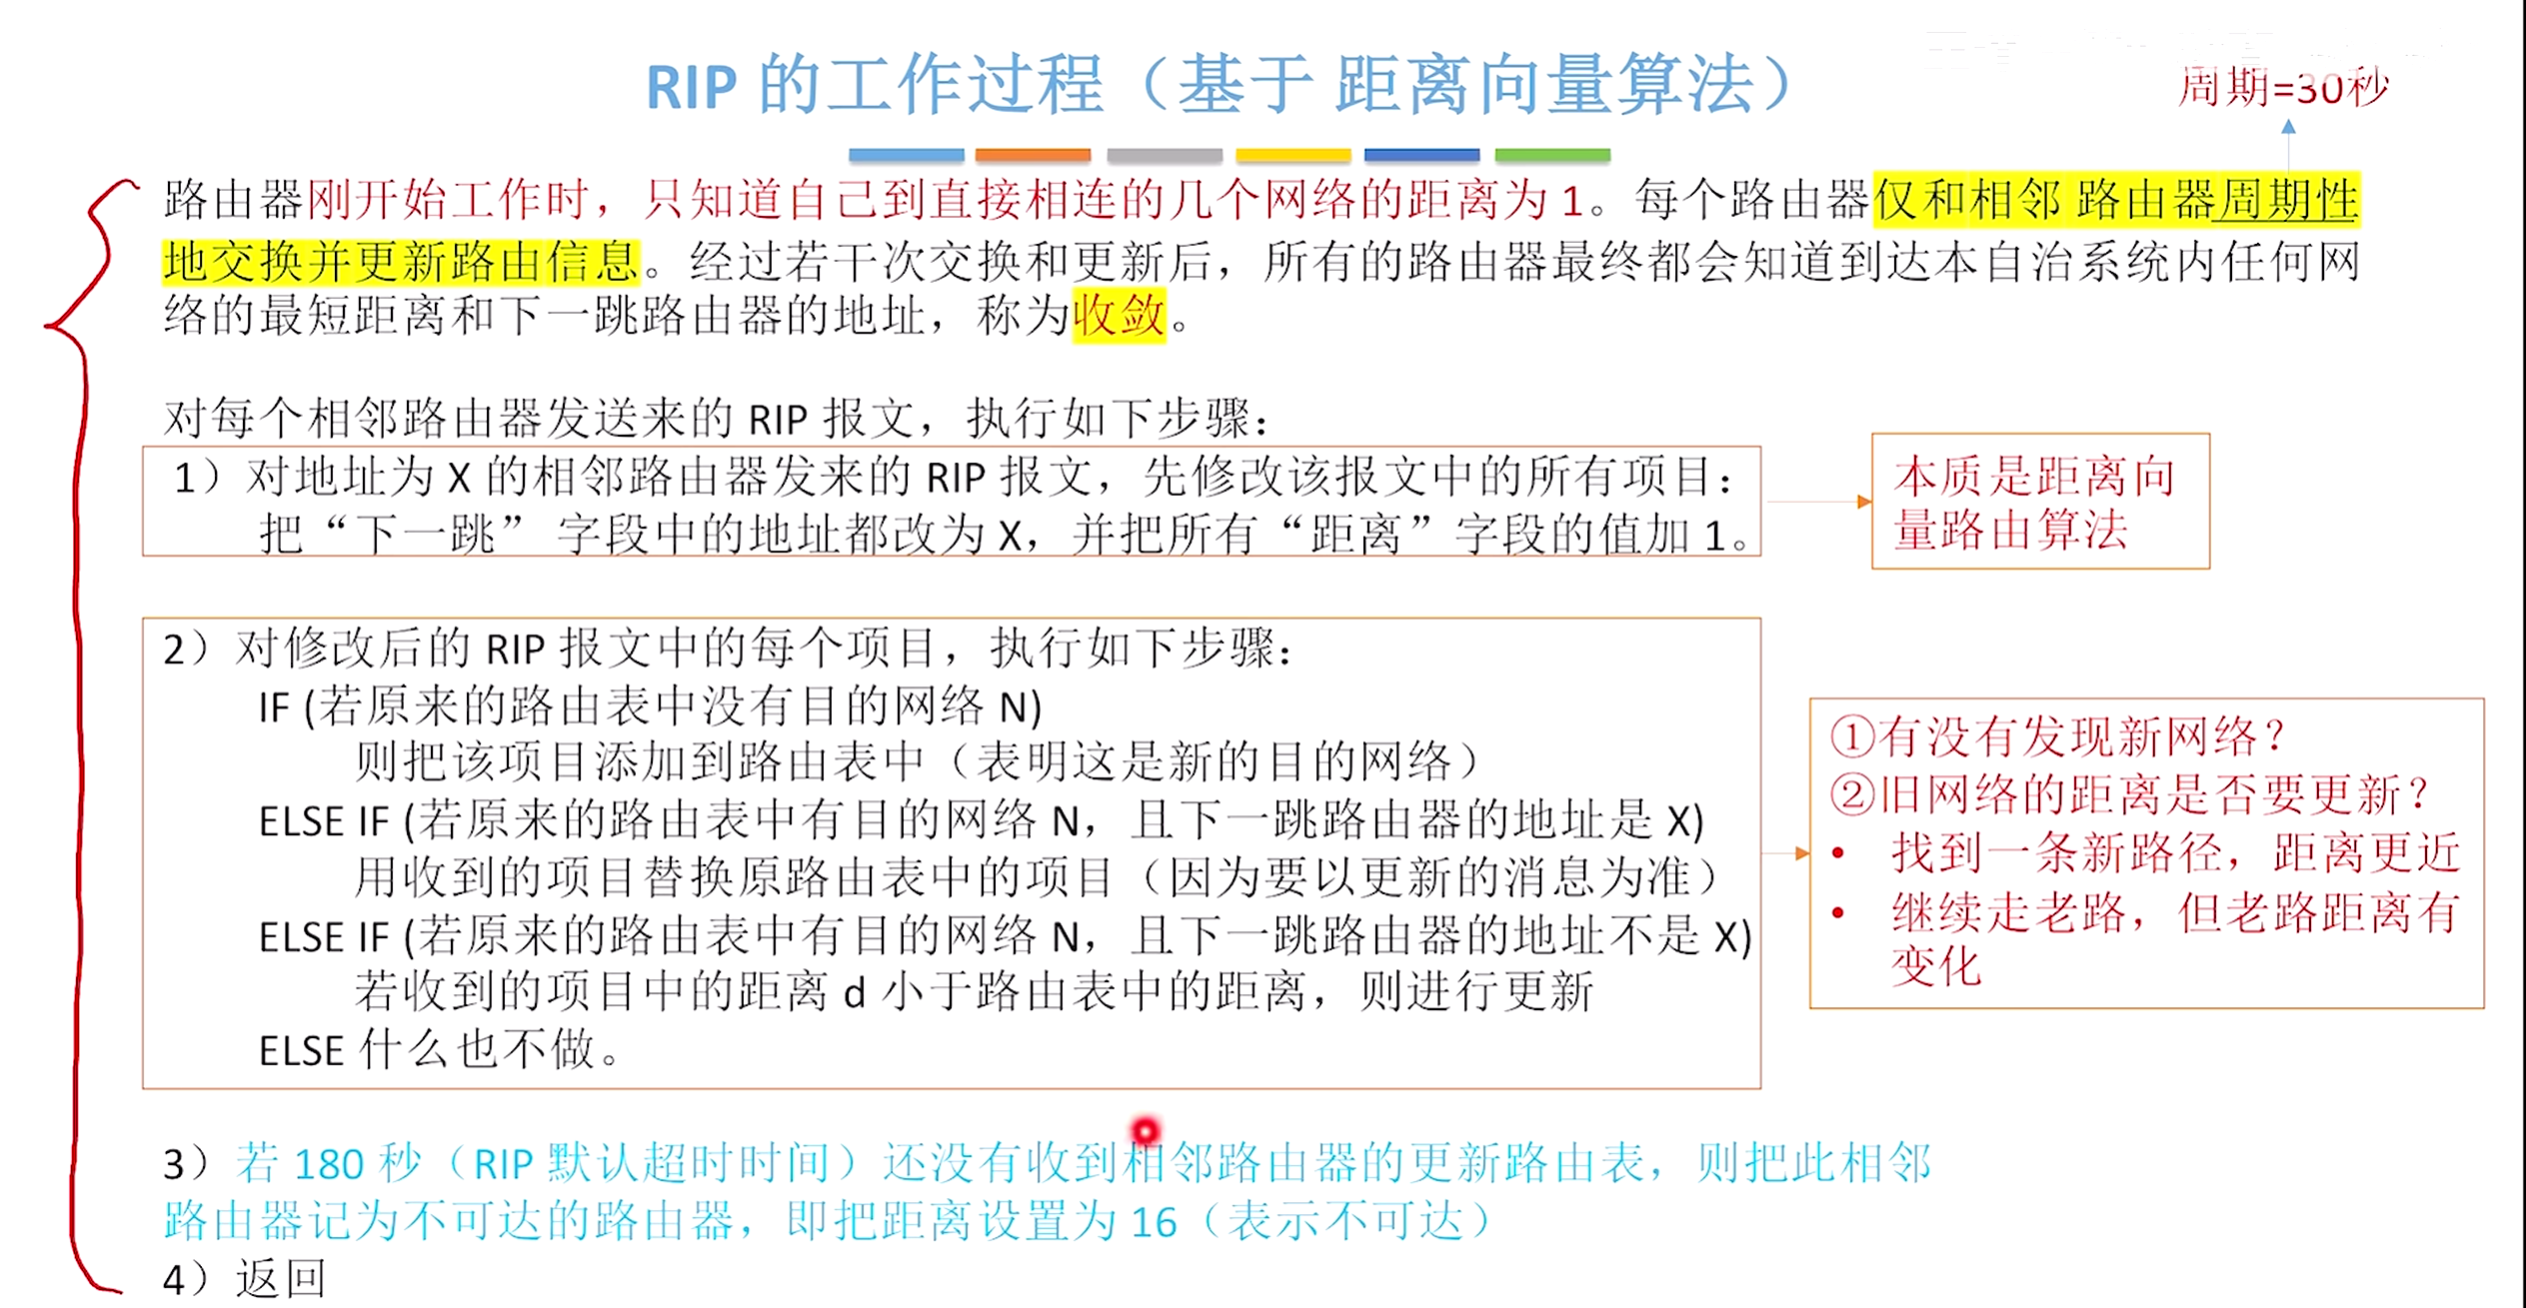
- 路由器刚开始工作时,只知道自己到直接相连的几个网络的距离为1
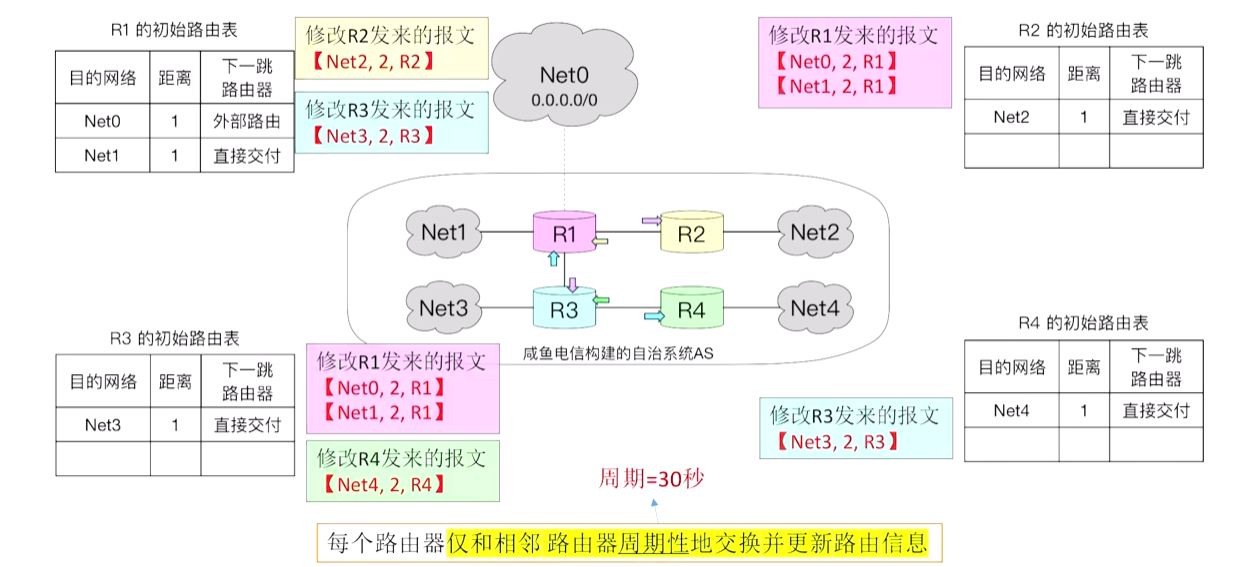
0时刻:各路由器向邻居发送RIP报文(包含完整路由表),之后更新自己的路由信息
- 根据收到别的路由器的报文,修改并==直接更新==自己的路由表==(不用发送确认信息。之后再向相邻的路由器给广播自己的新路由)==
- 让:发来的路由表距离都+1,目的地址改为发送方X
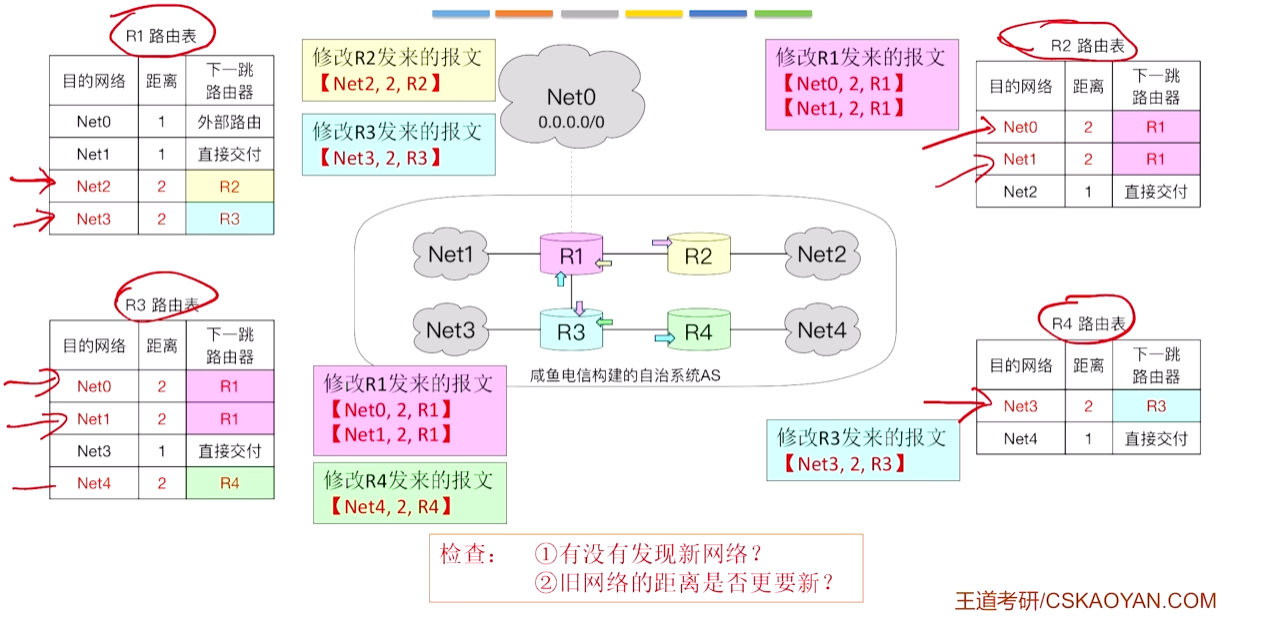
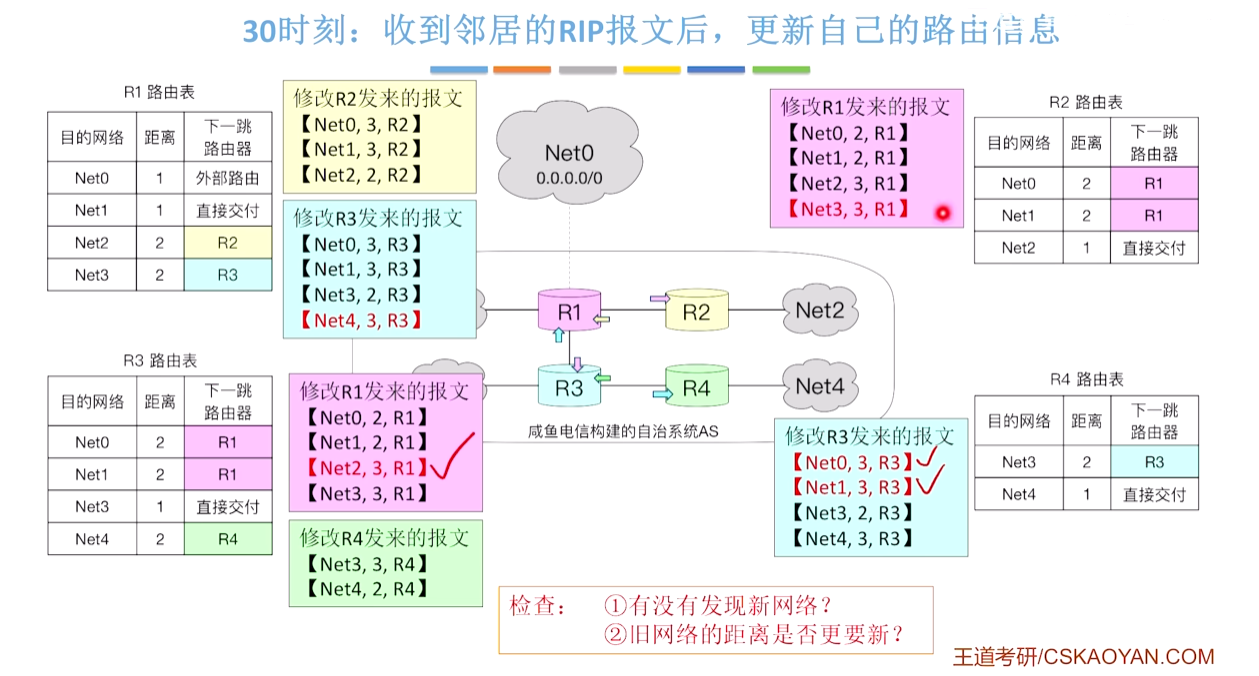
30时刻:各路由器向邻居发送RIP报文(包含完整路由表),更新自己的路由器信息
如果原来的路由表已经有目的网络N了,且下一跳路由器地址是X:
- 替换原来。**==(老路径以最新的为准)==**(实现负载均衡转发)
如果原来的路由表已经有目的网络N了,且下一跳路由器地址不是X:
- 如果收到的距离更小,就进行更新,反之不更新**==(如果新路径更短,就更新)==**
60时刻:各路由器向邻居发送RIP报文(包含完整路由表),更新自己的路由器信息
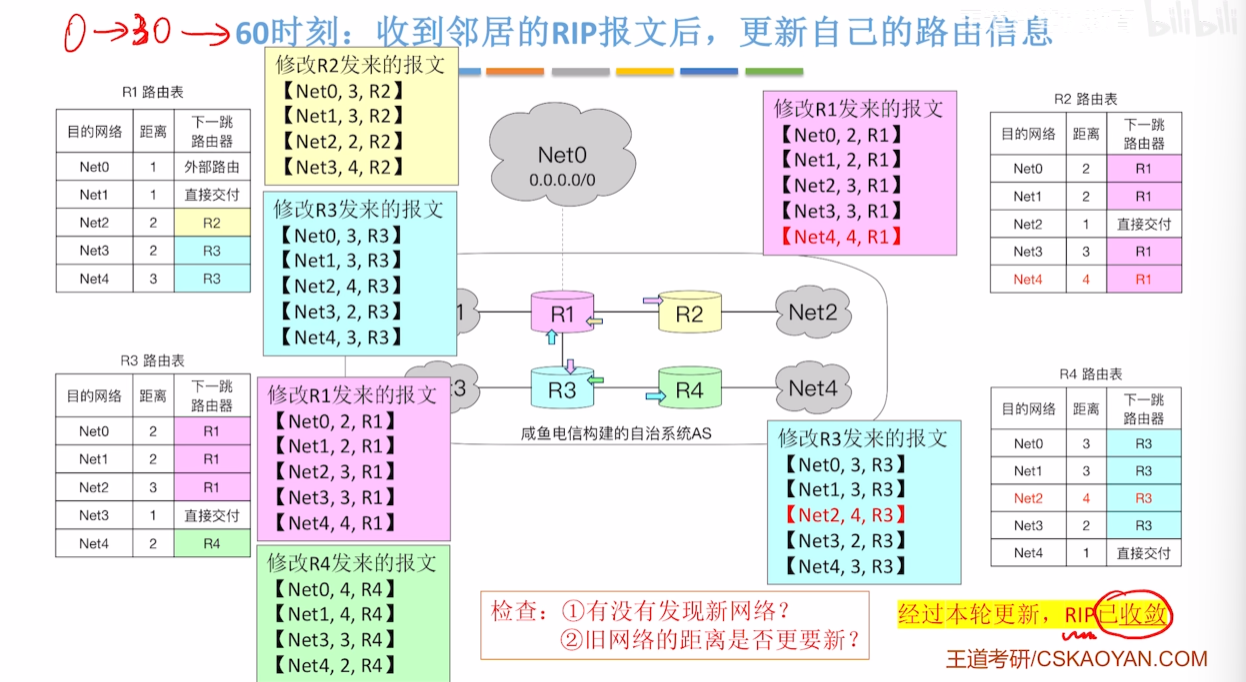
60时刻后,没有路由的信息需要更新,==RIP已收敛。==
RIP的工作过程示例2(动态适应网络拓扑变化)
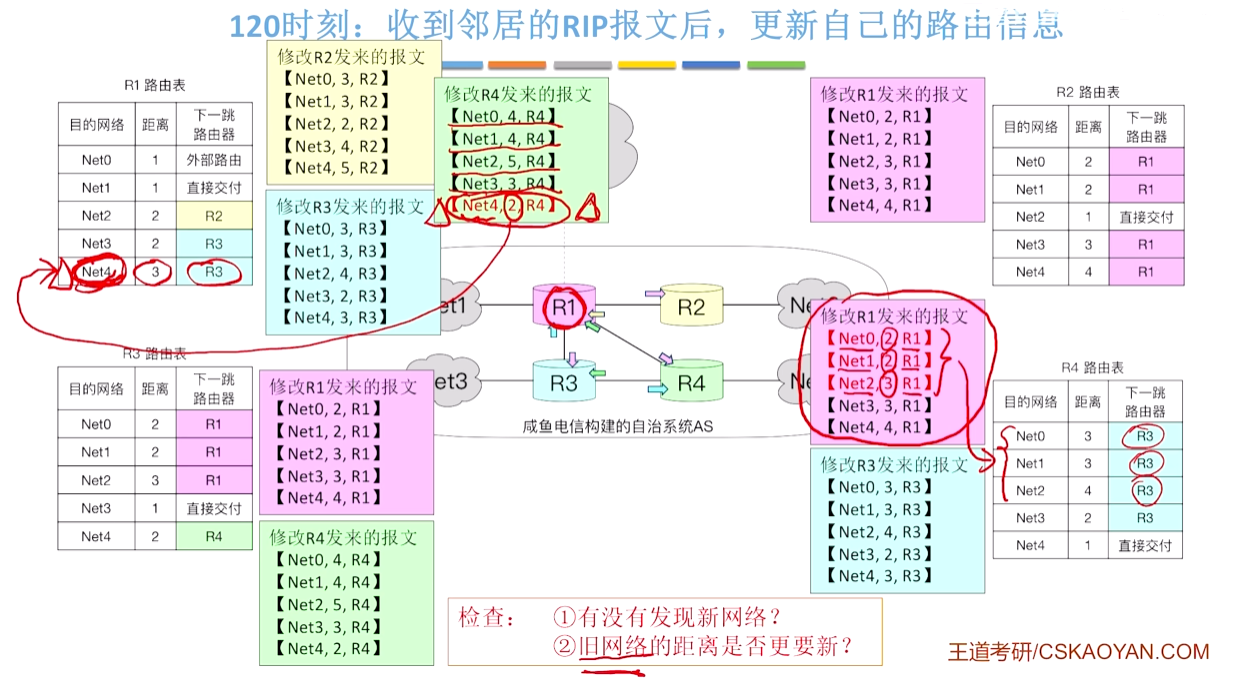
100时刻:R1和R4之间新建一条链路
120时刻:各路由器向邻居发送RIP报文,更新自己的路由器信息
RIP的工作过程示例3(RIP的优缺点)
160时刻:路由器被破坏
如果**==在180s后(RIP默认超时时间)之后==**:还没有收到相邻路由器发送的更新路由表,
则可以把此相邻路由器记为不可达的路由器,即把**==距离设置为16(表示不可达)==**
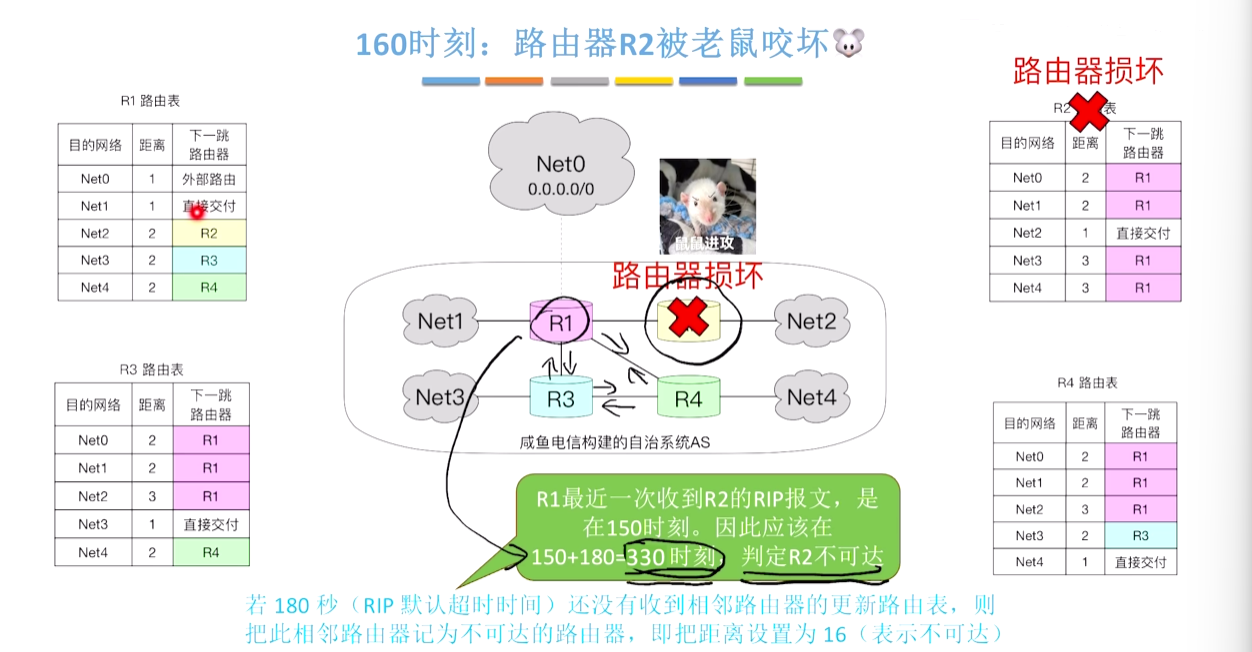
(150是失败前最后一次通信,得用 150+180,而不是160+180)
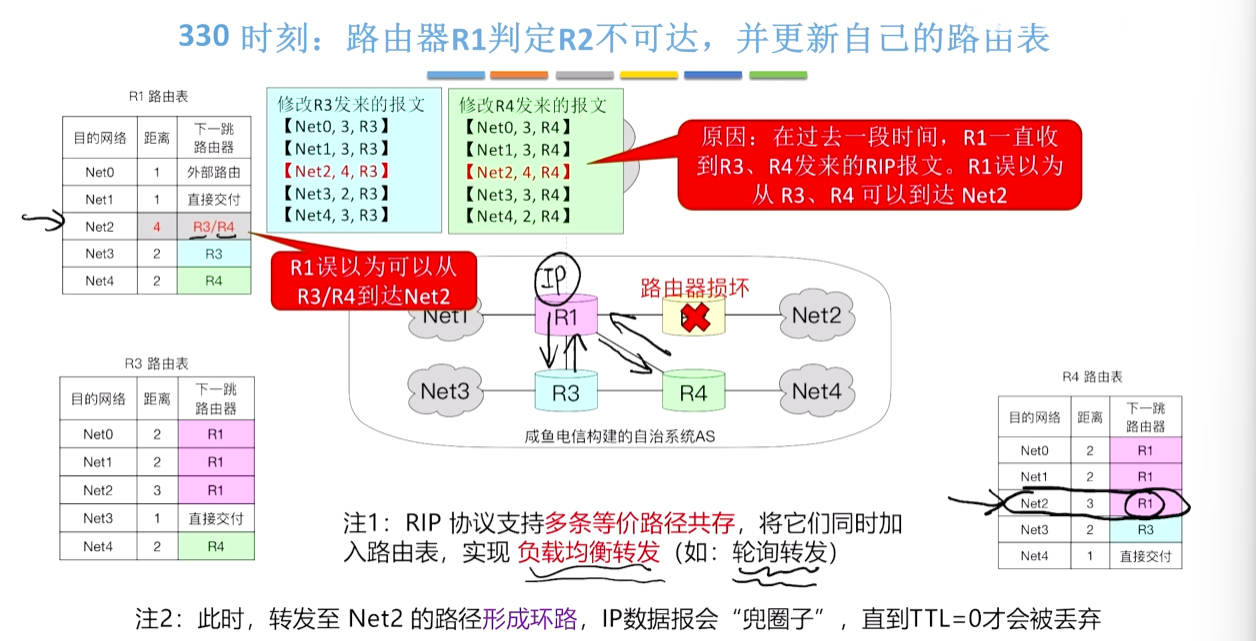
330时刻:路由器R1判定R2不可达,并更新自己的路由表
R1更新路由表,以为 可以通过R3/R4到达R2。
但从上帝视角来看,不只是R2对net2不可达,R3,R4也对net2不可达
造成了错误,形成**==转发环路==**:R3 – R3/R4,直到TTL=0才会被丢弃。【或者距离为16】
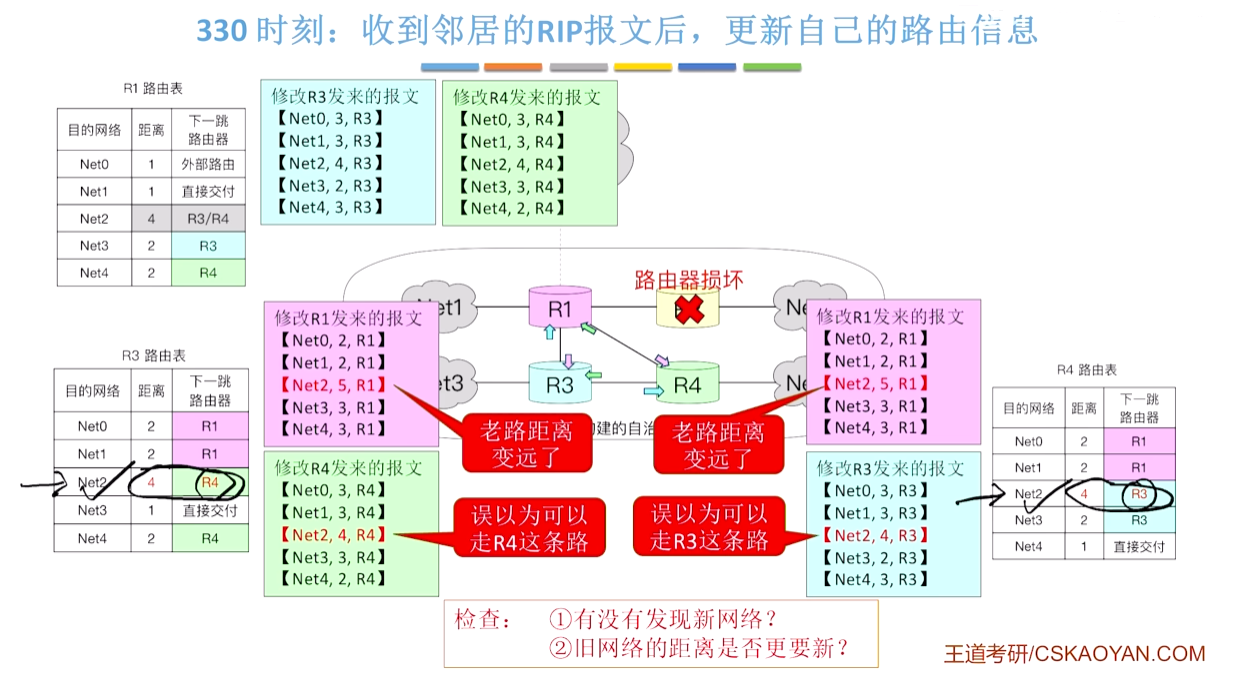
330时刻:各路由器向邻居发送RIP报文,更新自己的路由器信息
- 实际上还是环路,继续等等看吧。
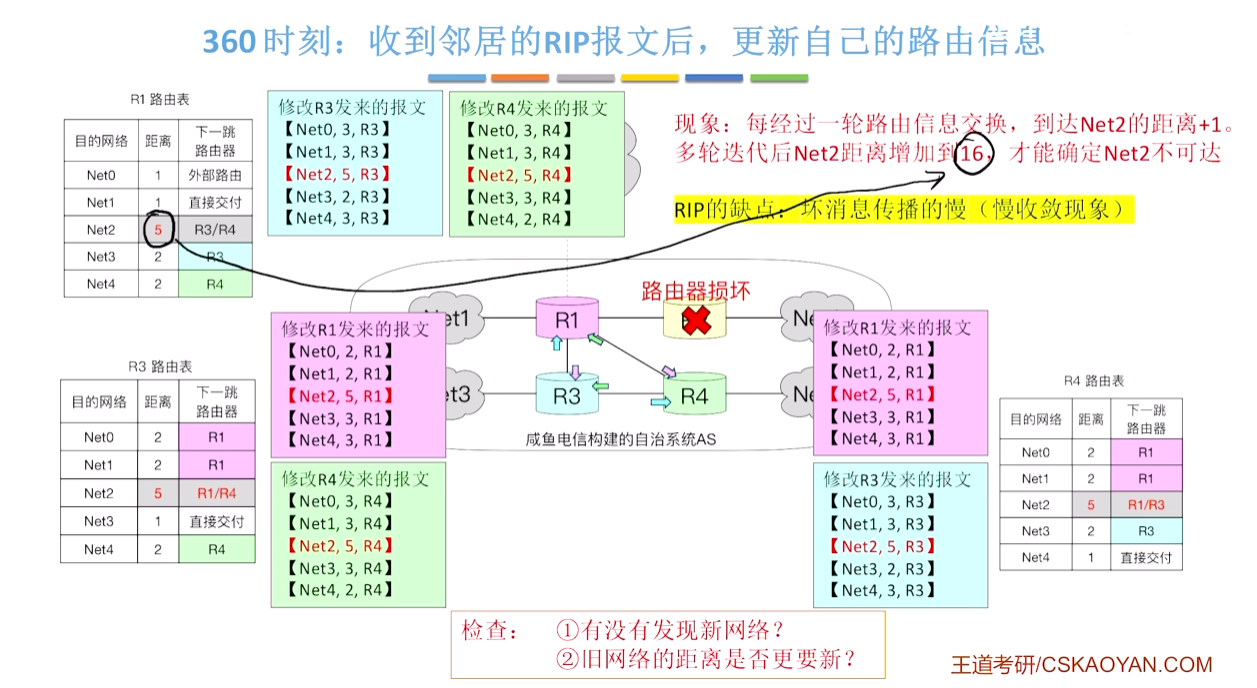
360时刻:各路由器向邻居发送RIP报文,更新自己的路由器信息
- 每经过一轮的信息交换,到达net2的距离+1.
- 多轮迭代之后,net2的距离才加到==16==,才能确定net2不可达。
- 可见RIP的缺点:==坏消息传得慢(慢收敛现象)==
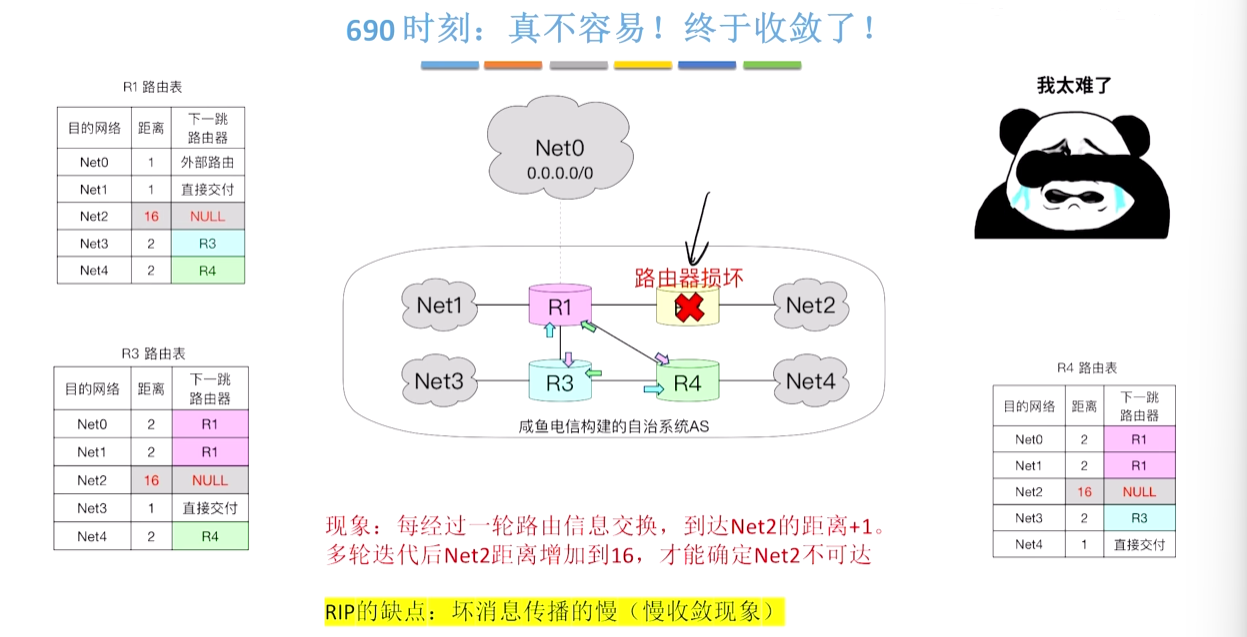
690时刻:终于收敛了!
(160时刻的出错,690时刻的收敛,哭了)
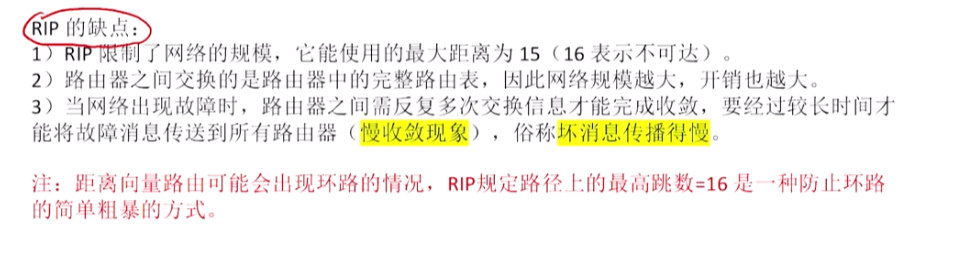
RIP的缺点
- RIP限制了网络的规模
- 网络规模越大开销越大
- ==坏消息传得慢==(慢收敛)
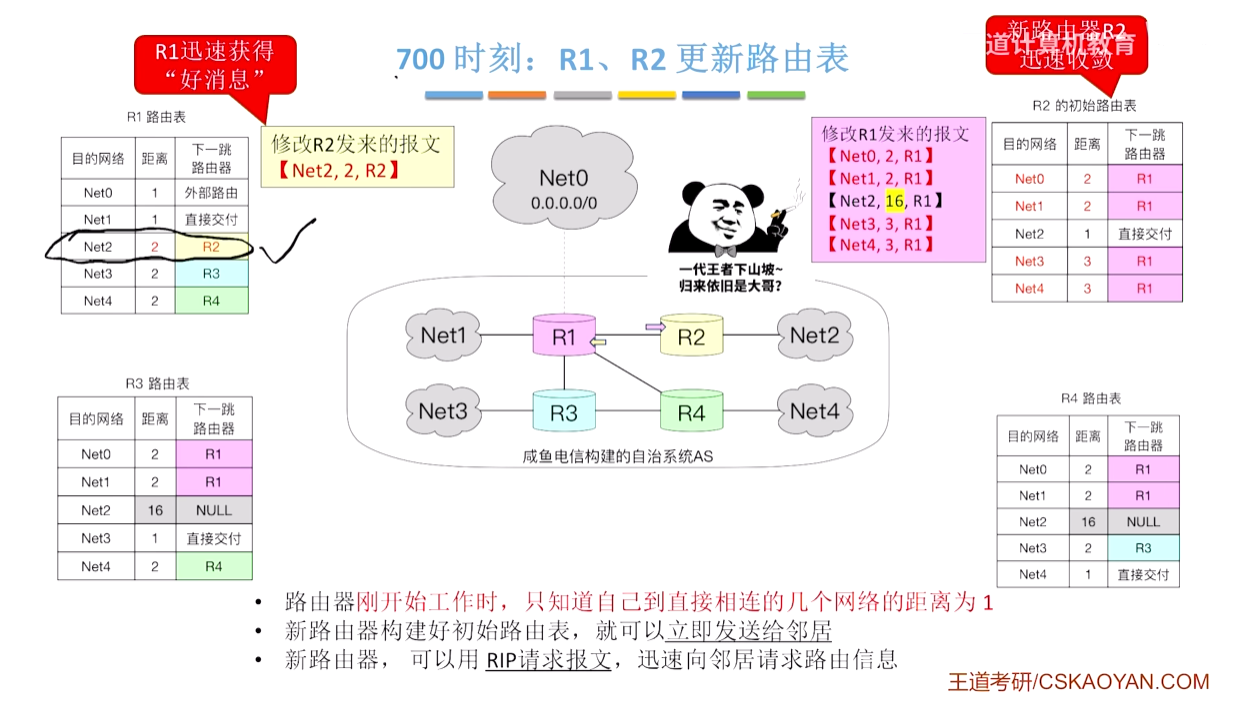
700时刻:R2换了个新路由器
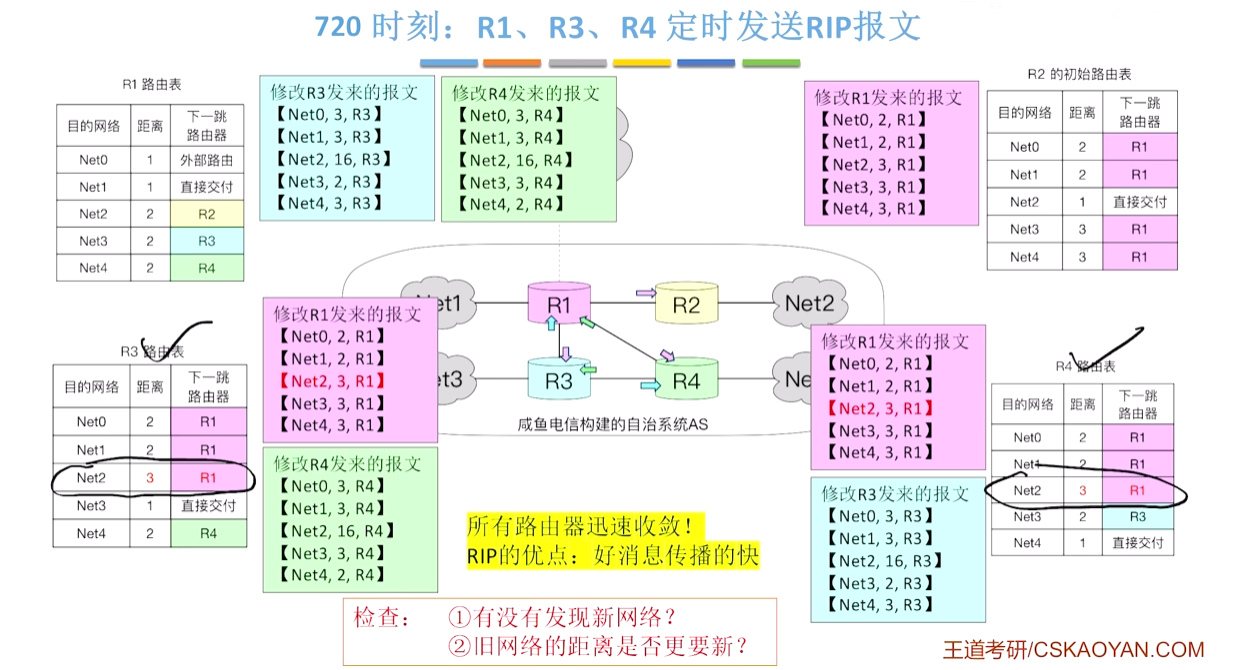
720时刻:
- R2是在700时刻开机的,要过30s即730s才发一次RIP报文
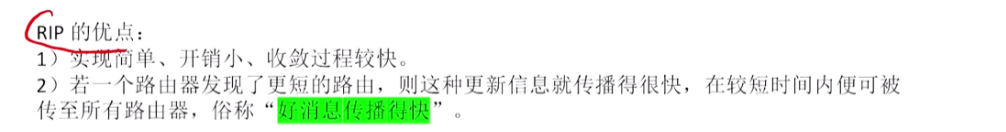
RIP的优点
- ==好消息传得快==
④ OSPF 开放最短路径优先协议
open shortest path first
基于链路状态路由算法(Djsk算法)
1.OSPF协议的特点
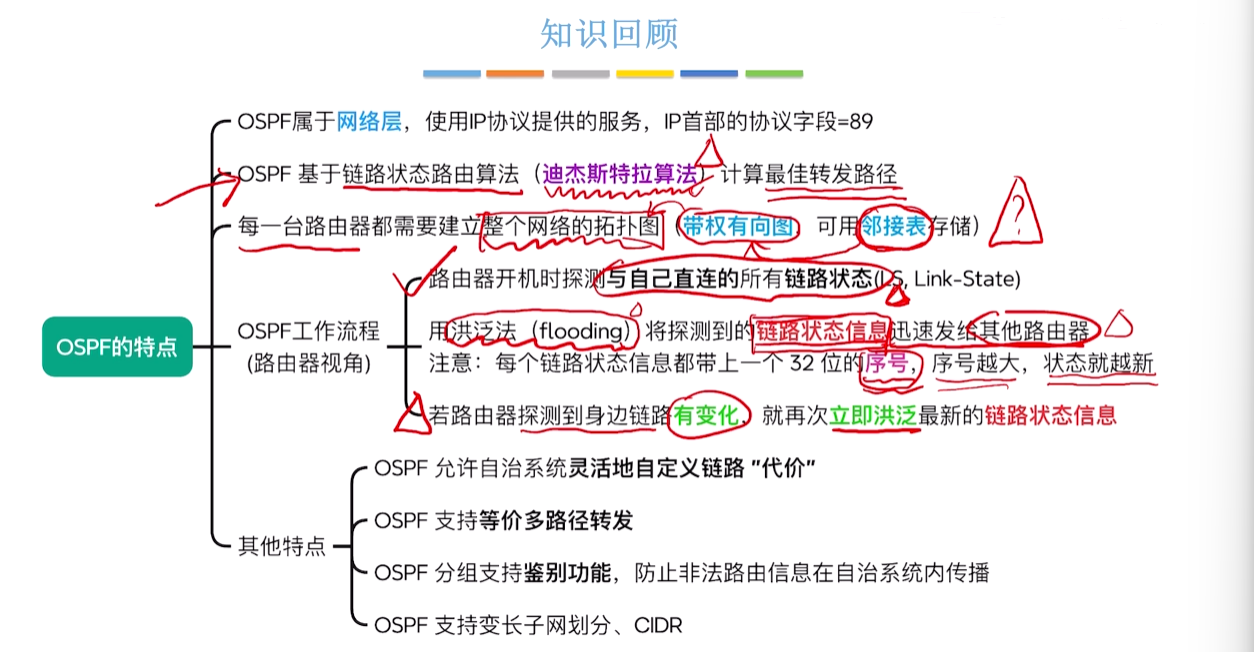
OSPF在协议栈所处的位置:==网络层==,==使用IP协议提供的服务==,IP首部协议字段89。
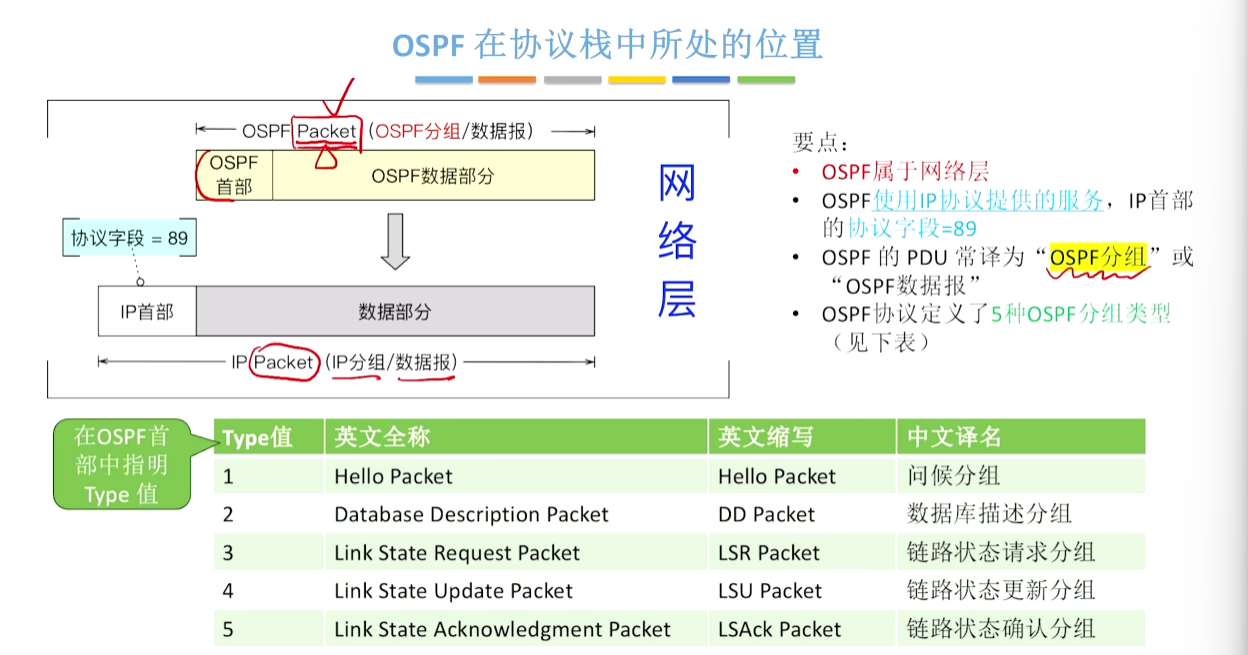
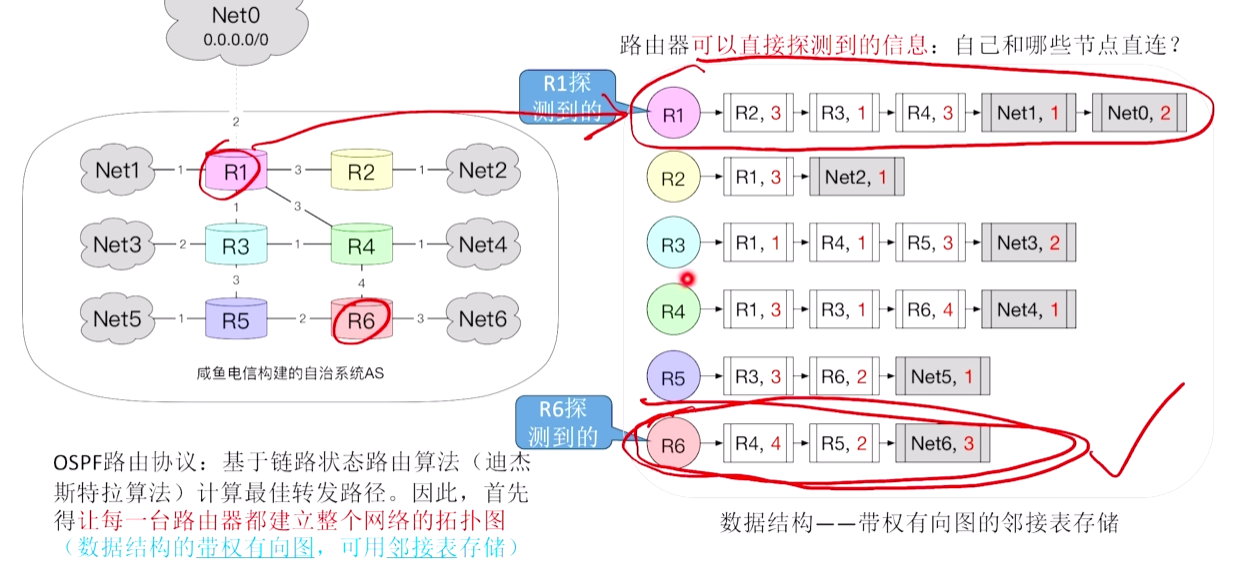
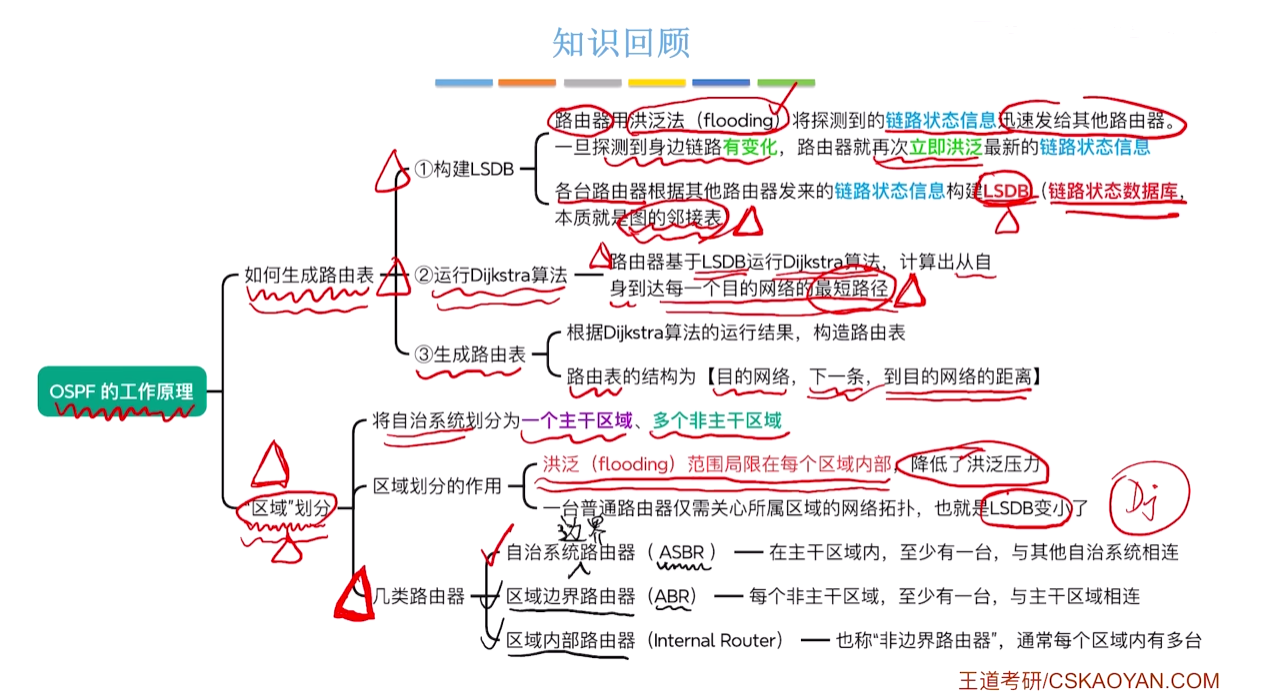
OSPF协议大致原理
==首先让 每一台 路由器都建立整个网络的拓扑图(带权有向图,用邻接表存储)==
- ① 每一台路由器(开机时)探测到和自己相连路由器/网络的信息(相邻节点,权重)
- ② 洪泛法分别把所有数据整合在一起(带权有向图的邻接表存储)
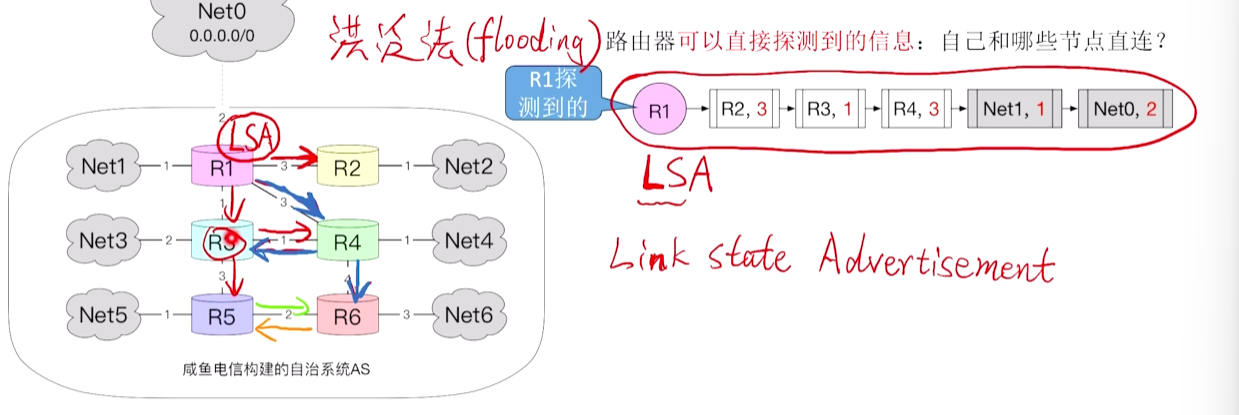
Q②:一台路由器怎么把自己探测到的信息 “说给” 其他所有路由器?
==洪泛法(flooding)==:通过相邻节点,一传十,十传百地传播。
- 注意:洪泛信息不可回流。若收到重复的链路状态信息,不重复转发。
- 每个链路状态都带上一个32位的序号。序号越大,状态/版本就越新。
Q①:当探测到相邻路由器信息有变化时怎么做?
- 立即洪泛最新的链路状态信息!(LSA:自己构建的单链表)
- 所以:不存在“坏消息穿播慢”的问题
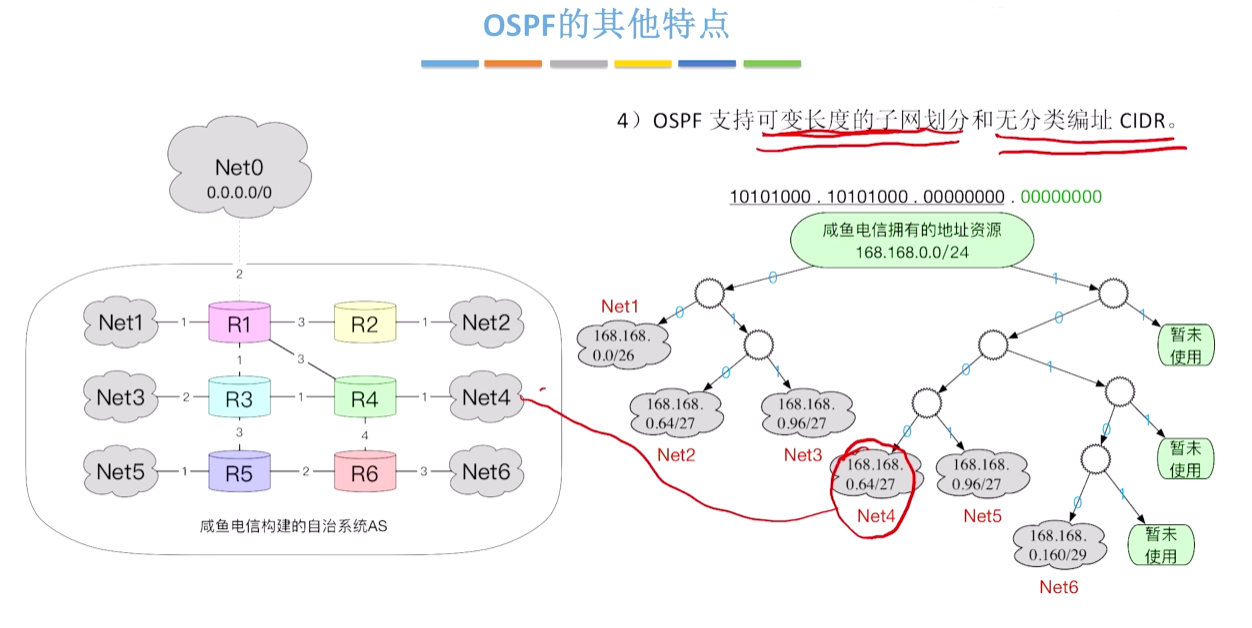
OSPF其他特点:
① 运行每条路设置不同的代价/权值。
- 代价 = 参考带宽/接口带宽
- 一个链路的两个方向,权值可能不同
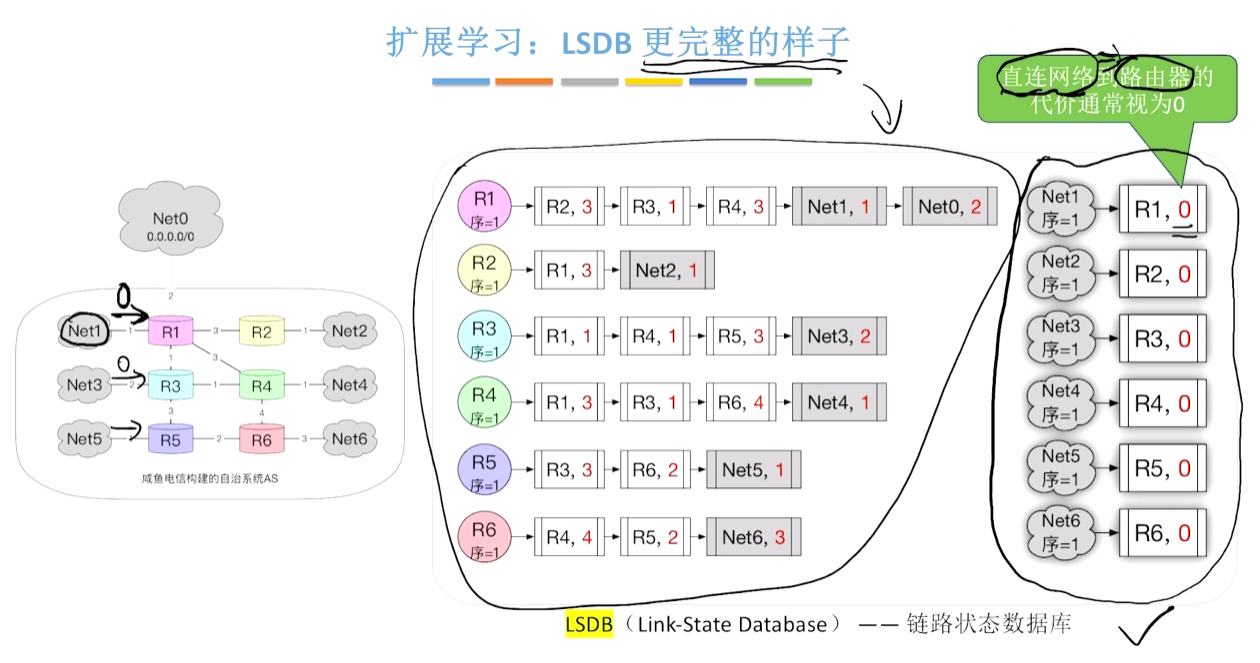
- 【直连网络→路由器】单方向的权值通常是0
② 若同一个目的网络有多条相同长度的路径,则都可以用来转发(可以负载均衡)
③ OSPF具有鉴别功能,可以保证仅在 可信赖的路由器 之间交换链路状态信息。
- (防止黑客攻击)
④ OSPF支持可变长度的子网划分 和 无分类编址CIDR
回顾
2.OSPF的基本工作原理
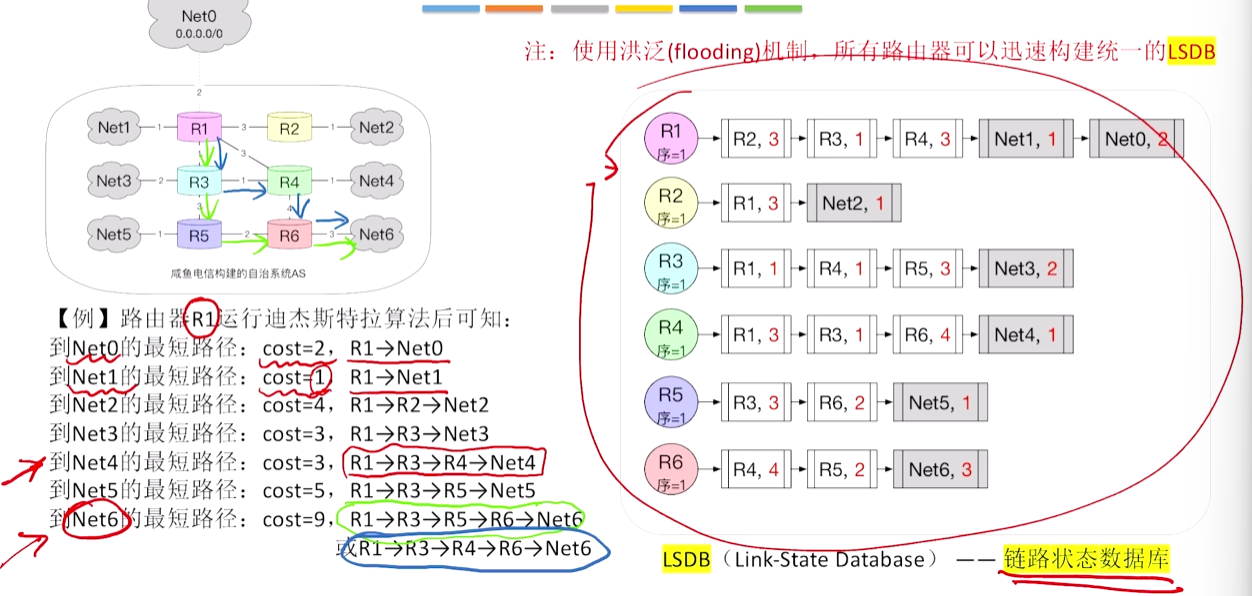
(在知道了每一台路由器都建立整个网络的拓扑图后)【LSDB – 链路状态数据库】
==① 路由器构建LSDB,使用Dijkstra算法计算最短路径==
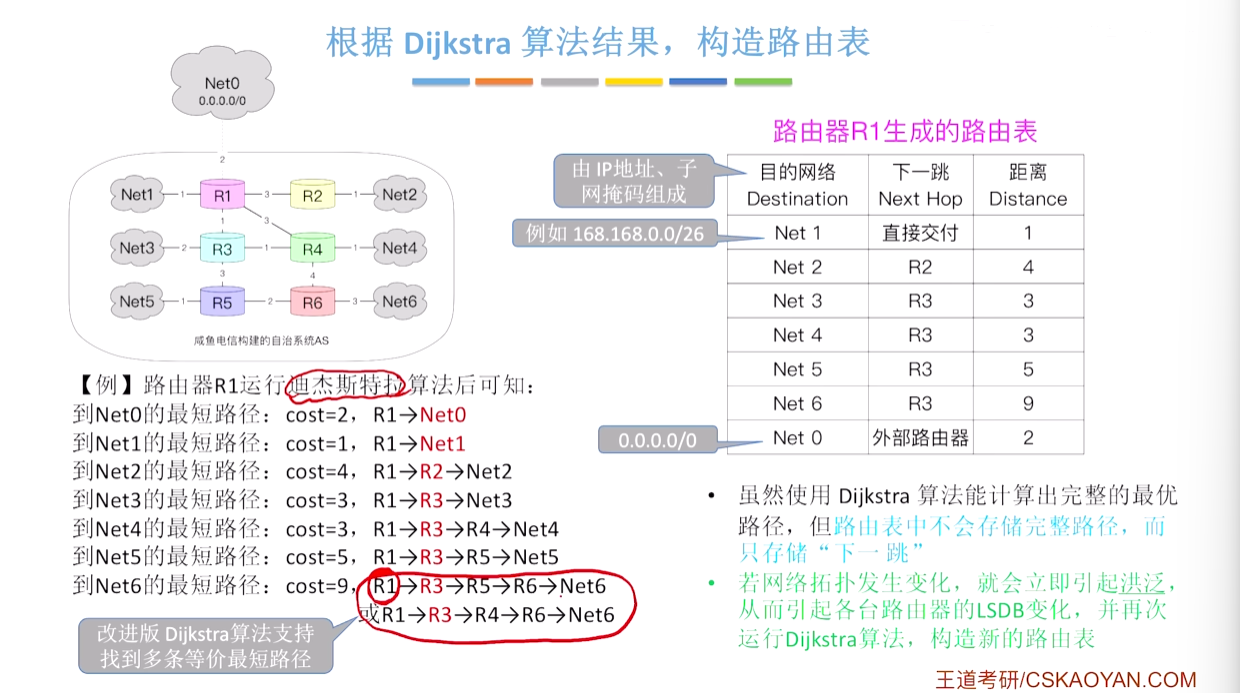
==② (根据Dijk算法结果),构建Ri的路由表==
特点:
路由表结构:【目的网络,下一跳,到目的网络的距离】(
- 路由表中不会存储完整路径,只存储下一跳
一旦网络拓扑(链路或者路由器)变换,会立即引起洪泛,LSDB变化,再次运行D算法,构建新路由表。
Q:超大型自治系统的LSDB
- 这时候每台路由器都还得存储一份LSDB?
- 洪泛压力也大,D算法开销也大。
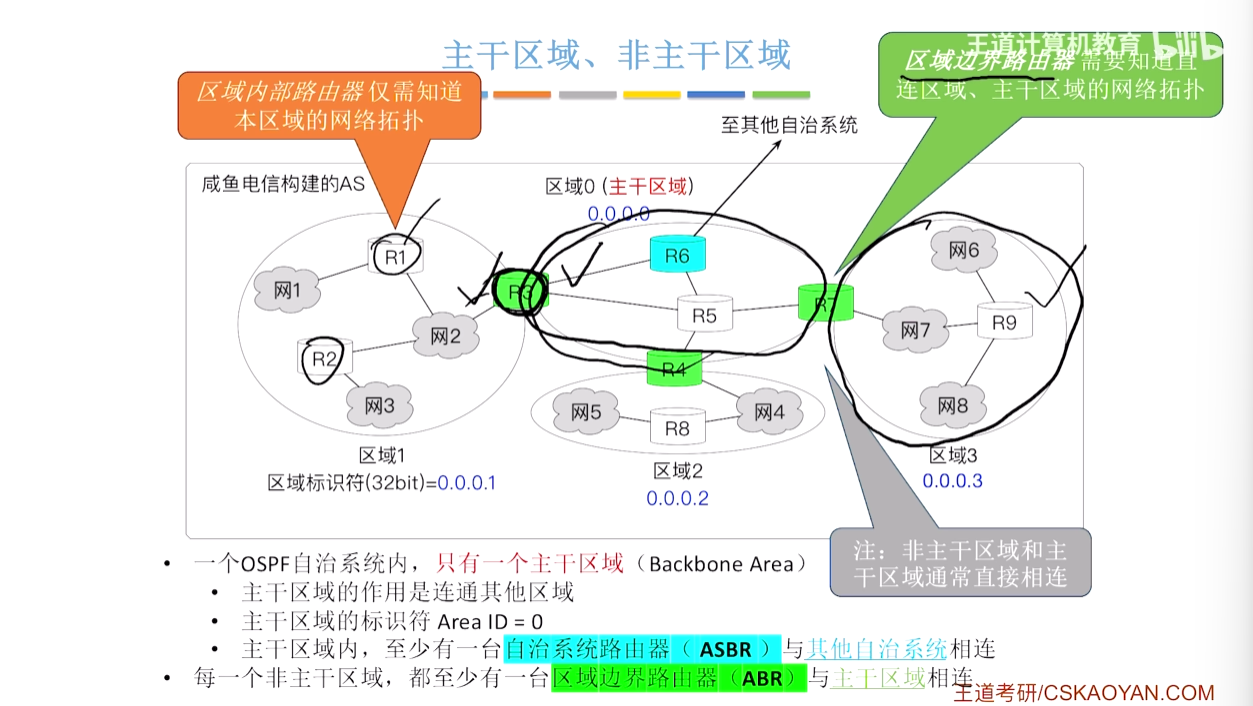
==SOL:区域划分==
- 把自治系统划分成多个区域Area【一个主干区域,多个非主干区域】
- 主干区域至少有一台 自治系统路由器ASBR,与其他自治系统相连。
- 非主干区域至少有一台 区域边界路由器ABR,与主干区域相连。
- 这时洪泛法的范围是区域内部,不是AS。
- LSDB也小了,D算法开销也小了。
易混淆:在主干区域的路由器,都叫做==主干路由器==
==整理三类路由器==
自治系统边界路由器:(6)负责 本自治系统与其他自治系统之间的 IP分组路由转发
区域边界路由器 :(3,4,7)负责 为流出流入该区域的 IP分组提供路由转发
区域内部路由器:(1,2,5,8,9)负责 本区域内的 IP分组路由转发
回顾
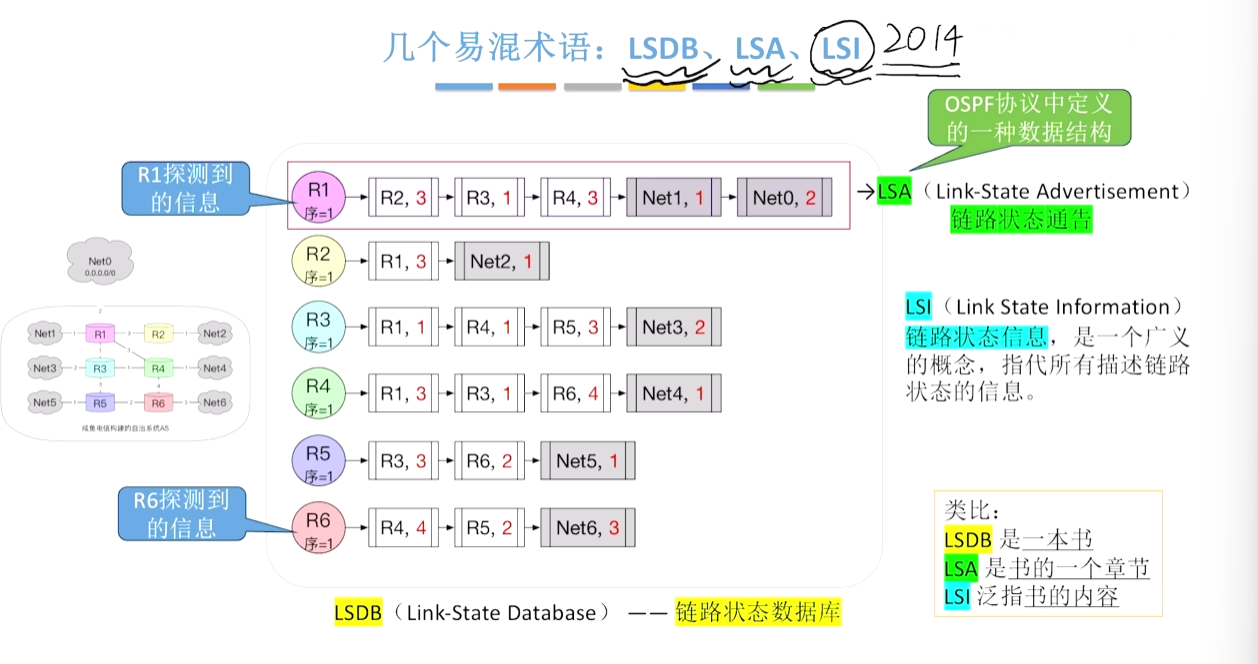
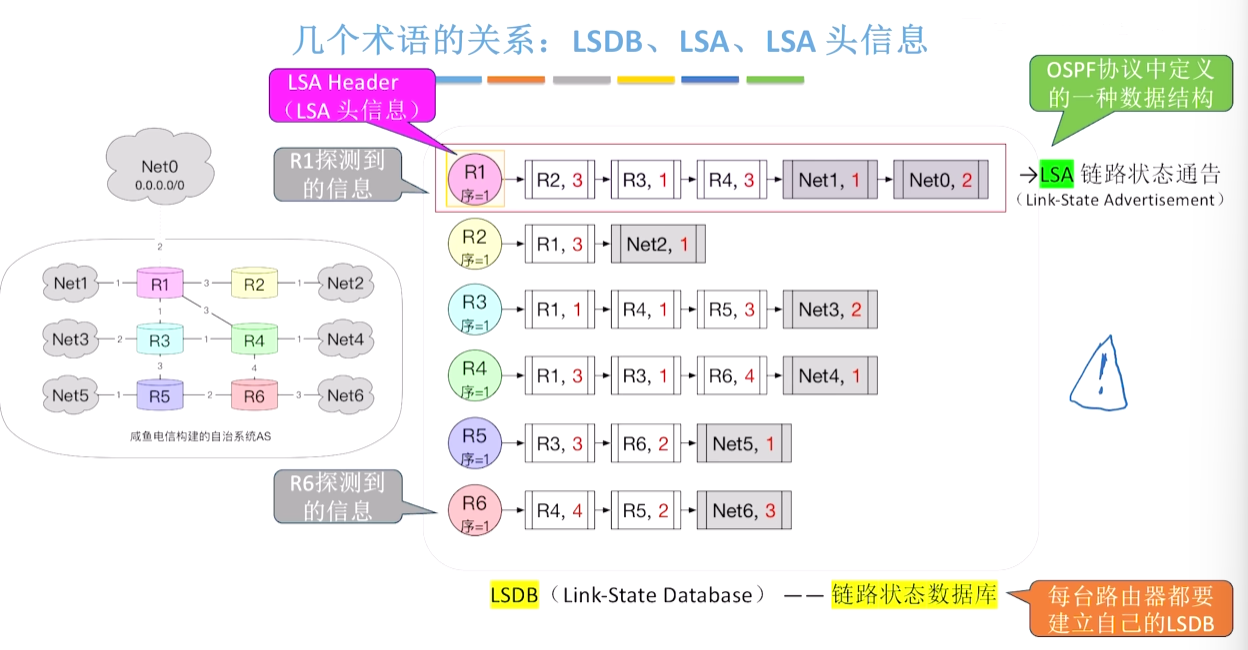
拓展:LSDB,LSA,LSI
LSDB:链路状态数据库
LSA:链路状态通告
LSI:链路状态信息(广义的概念)
【LSDB是一本书,LSA是一个章节,LSI泛指书的内容】
==3.OSPF协议的分组类型==
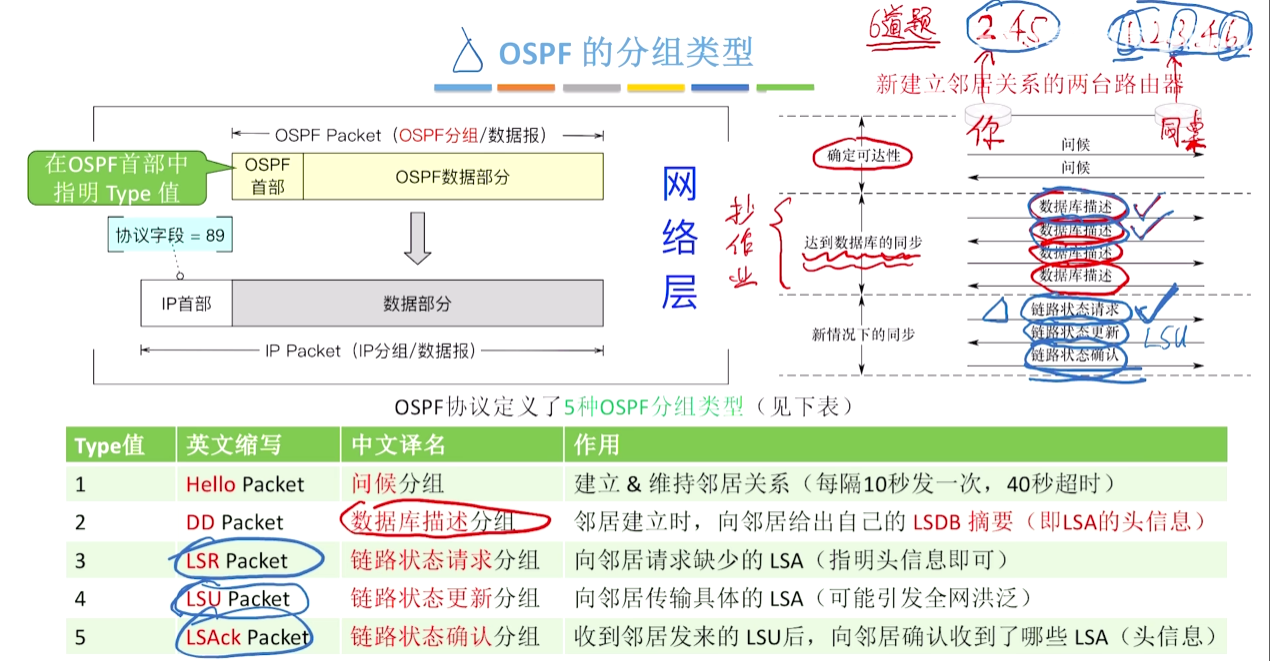
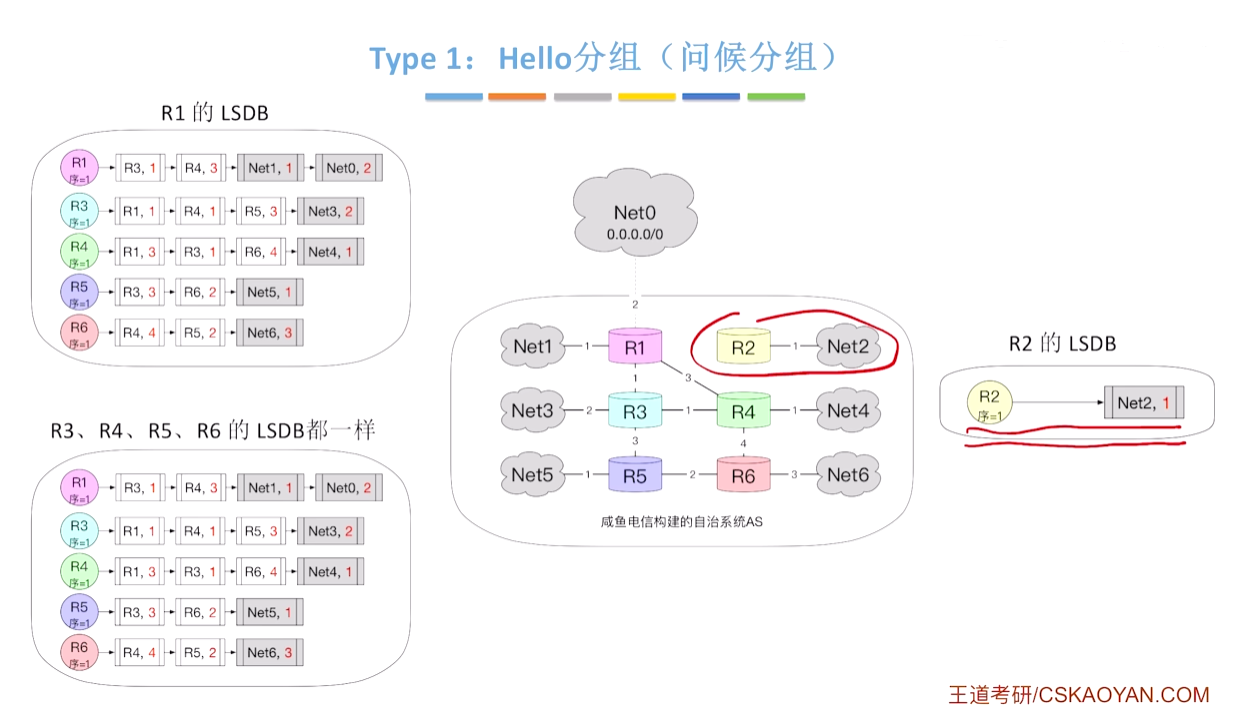
Hello分组(问候分组)
一开始路由器R2和别的路由器还没建立联系,是独立的。
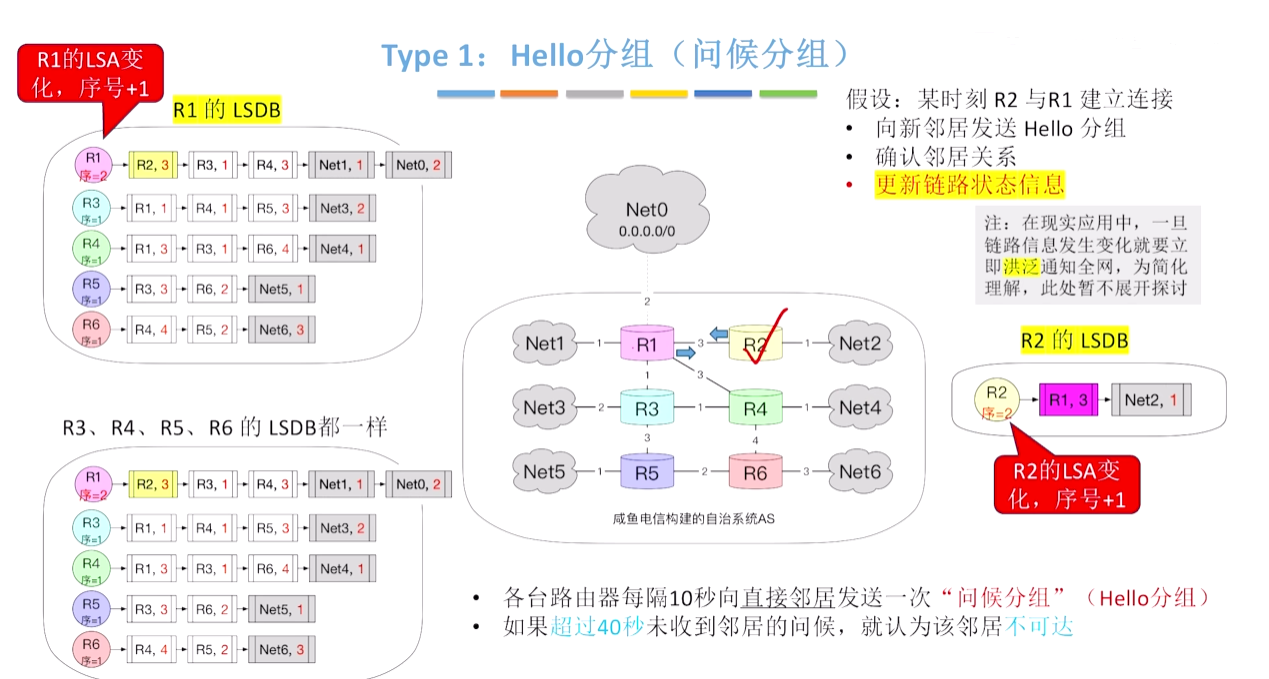
各台路由器每隔10s会向直接邻居发送一次“问候分组”
==如果超过40秒没收到邻居的问候,就认为该邻居不可达。==(所以Hello是原来保持和邻居的联系的)
R1和R2建立了连接后:相互发送“问候分组”,确认邻居关系,更新链路状态信息。
R1更新链路状态信息→洪泛给所有路由器→所有路由器也更新链路状态信息。
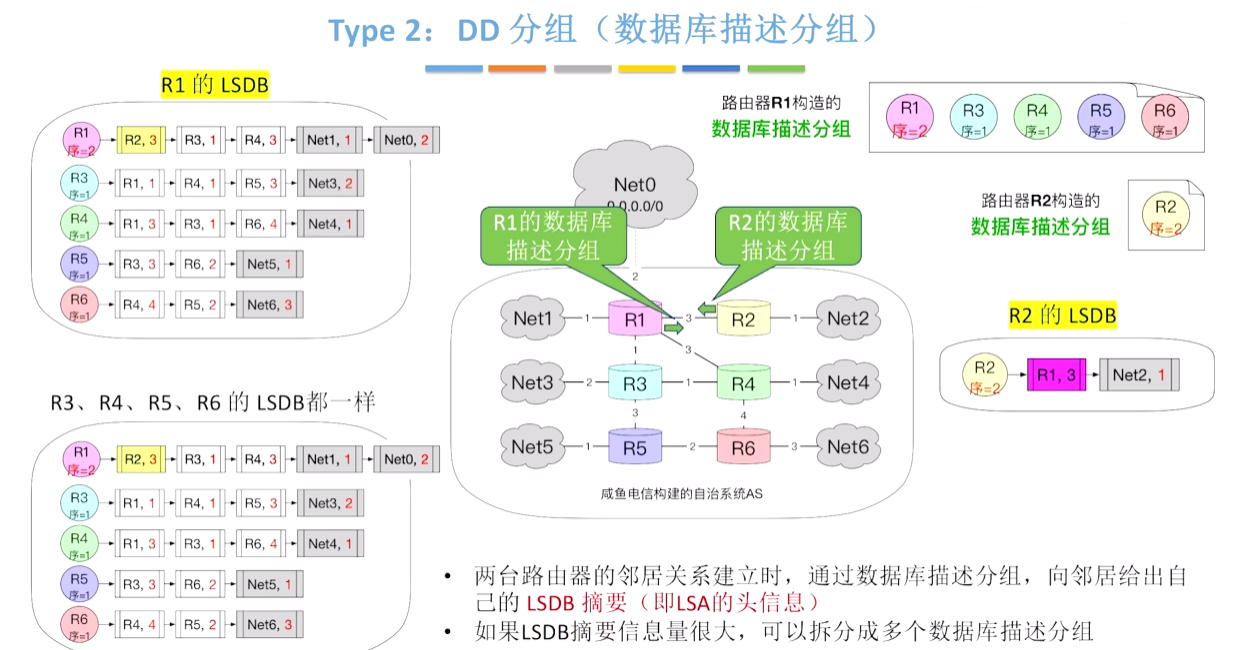
DD分组(数据库描述分组)
两台路由器的邻居关系建立时,通过DD分组,向邻居给出自己的LSDB摘要(即LSA的头信息)
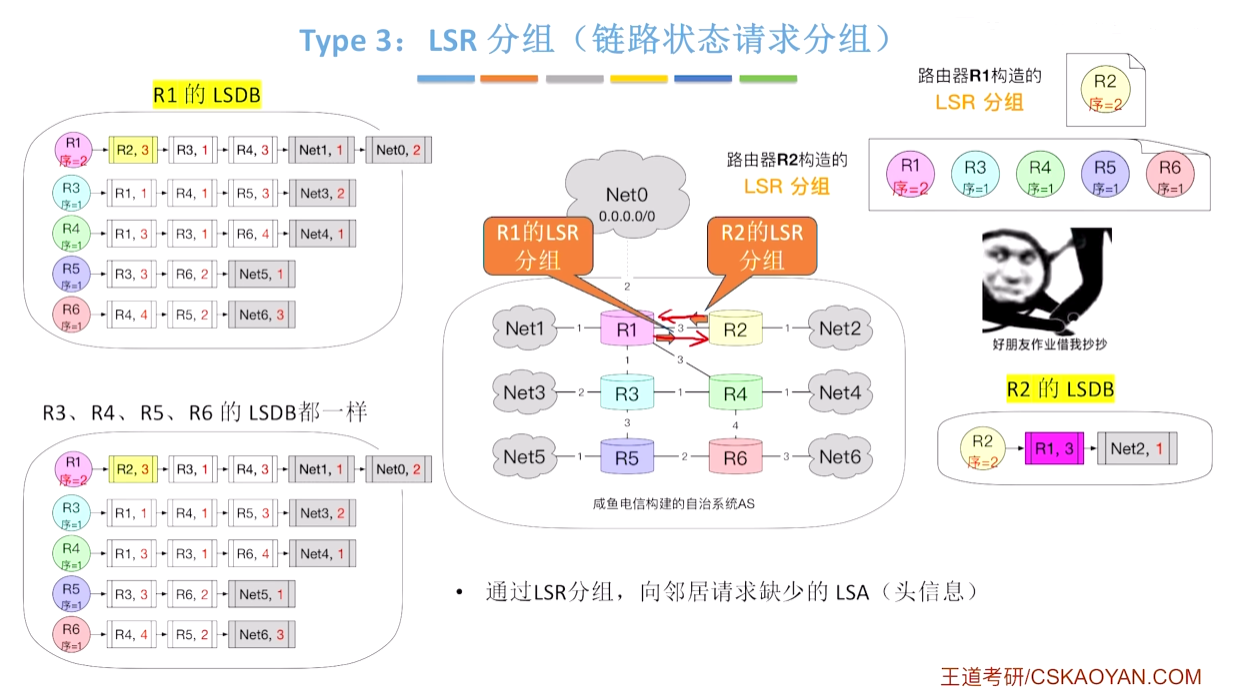
LSR分组(链路状态请求分组)
通过LSR分组,向邻居请求缺少的LSA(头信息)
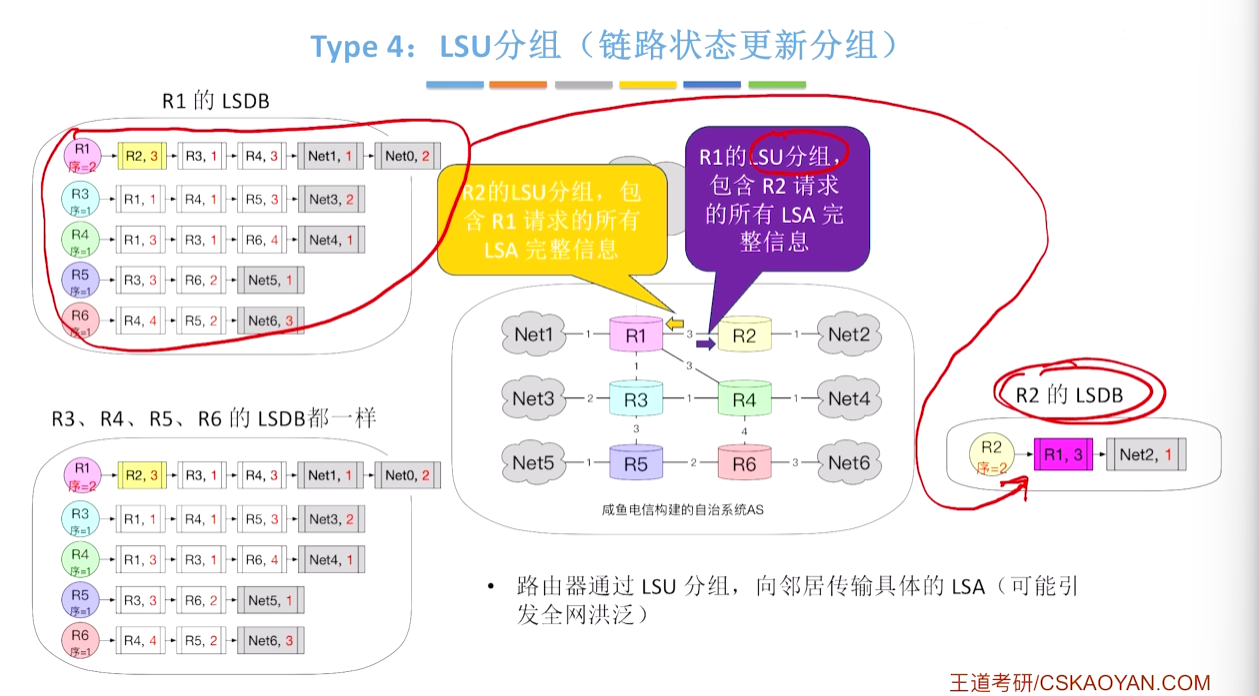
LSU分组(链路状态更新分组)
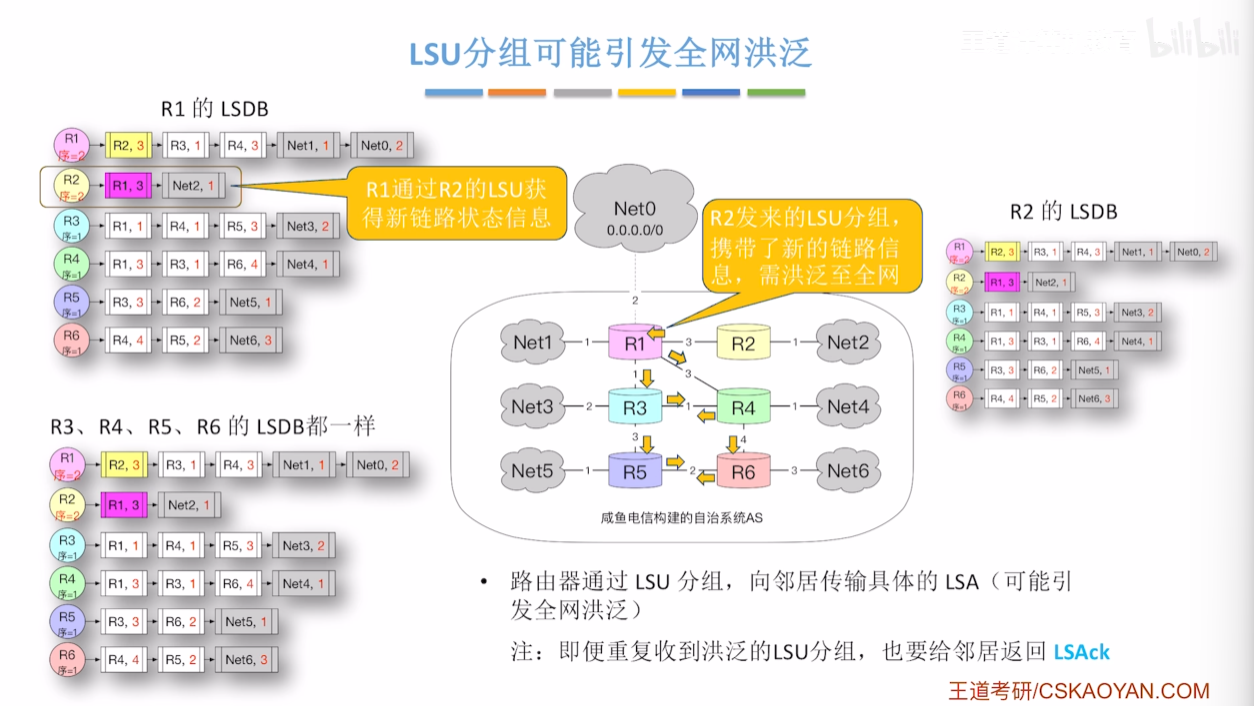
路由器通过LSU分组,向邻居传输具体的LSA(可能引发全网洪泛,蝴蝶效应)
- 即使重复收到了洪泛的LSU分组,也要给邻居返回LSAck
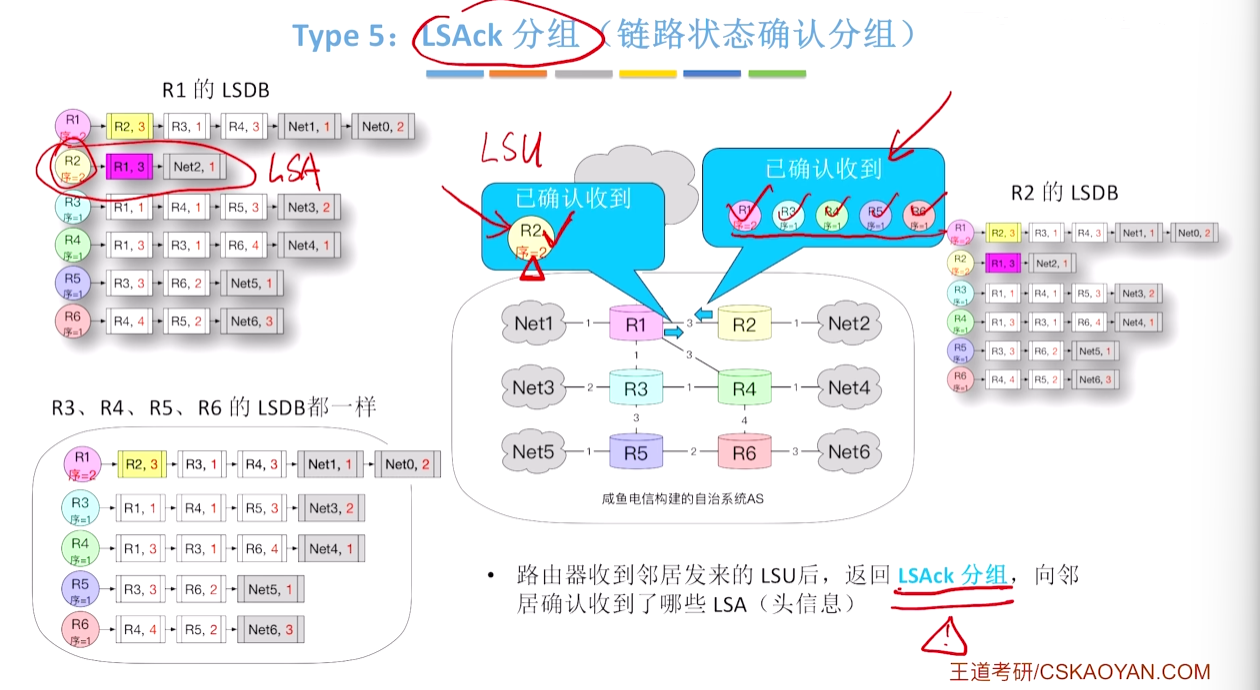
LSAck分组(链路状态确认分组)
路由器收到邻居发来的LSU后,返回LSAck分组,向邻居确认收到了哪些LSA(头信息)
⑤ BGP 边界网关协议
路由协议的分类:
- 内部网关协议:用于AS内部交换路由信息,实现路由选择,例如RIP,OSPF
- ==外部网关协议==:用于==AS之间==交换路由信息,实现路由选择,例如BGP协议
边界路由器之间使用BGP协议
特点,相关概念
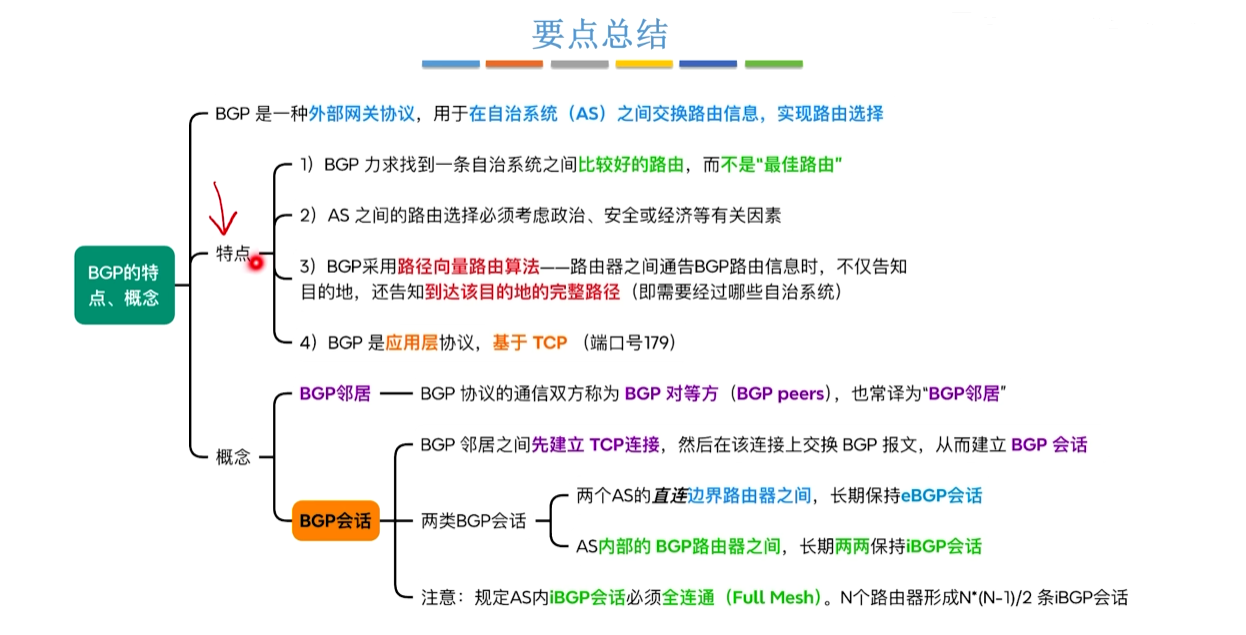
特点:
- ① BGP力求找到一条自治系统之间**==比较好的==路由**,而不是最佳路由
- 原因是AS之间一大堆路由器,费时。
- ② AS之间的路由选择必须考虑政治安全或经济等因素。
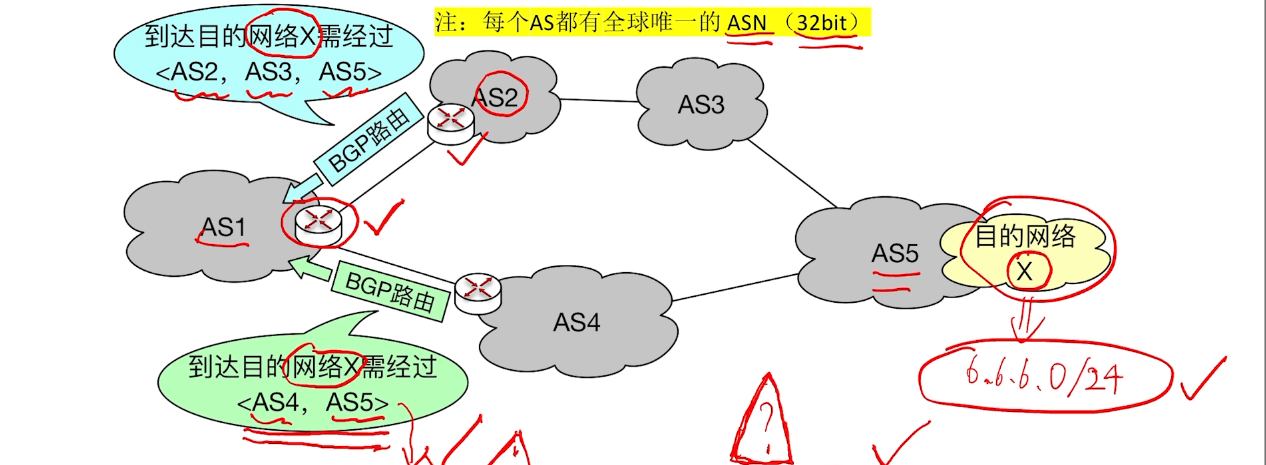
- ③ BPG采用==路径-向量路由算法==:路由器之间通告BPG路由器时,不仅告知目的地,**还告知到达该地的==完整路径==**(即需要经过哪些自治系统)。
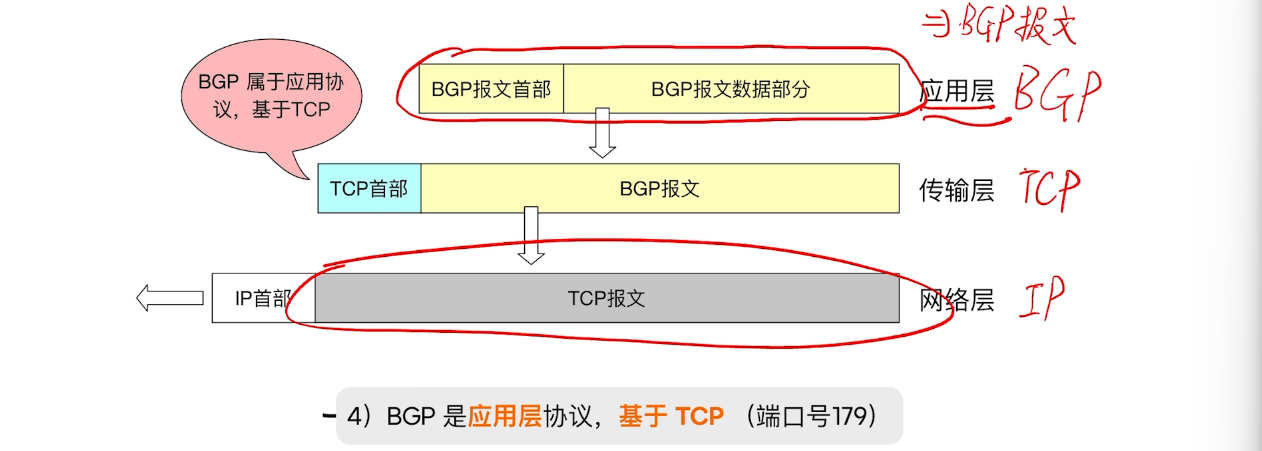
- ④ BGP是**==应用层协议==**,基于TCP。(运行BGP协议的路由器还包含传输层,应用层)
Q:哪些路由器需要运行BGP协议?
- (自治系统)边界路由器,(自治系统)某些内部核心路由器。
- (简化理解:AS内所有路由器都要运行BGP协议)
BGP邻居
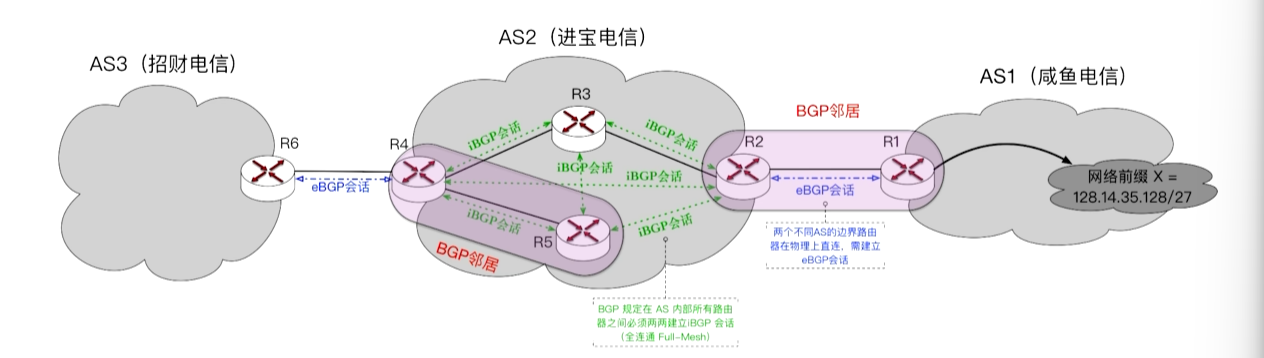
- BGP协议通信双方称为BGP邻居。
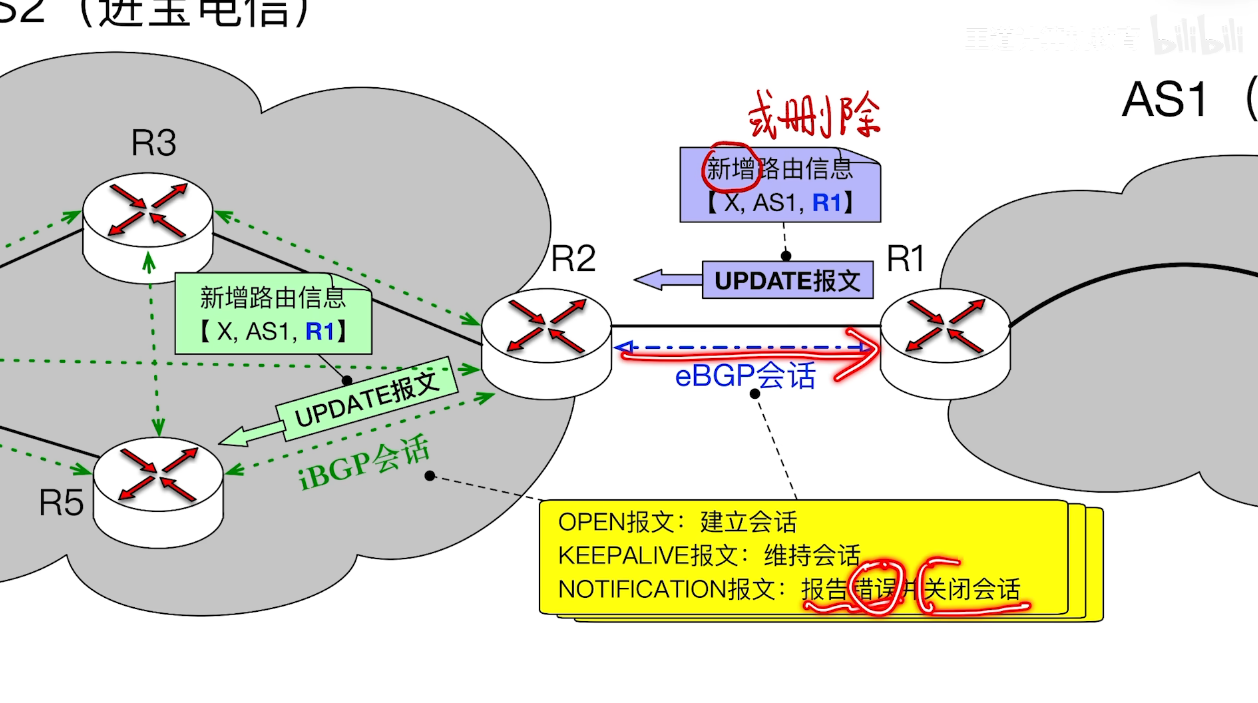
- BGP邻居之间先建立TCP连接,然后在该连接上交换BGP报文,从而建立BGP会话
BGP会话
- 两个AS的直连边界路由器之间,长期保持eBGP会话。【在物理上连接】
- 两个AS的内部BGP路由器之间,长期两两保持iBGP会话。【物理上不直连也可以】
- 注意:规定AS内iBGP会话必须**==全连通==**:N个路由器形成N(N-1)/2条iBGP会话。
回顾
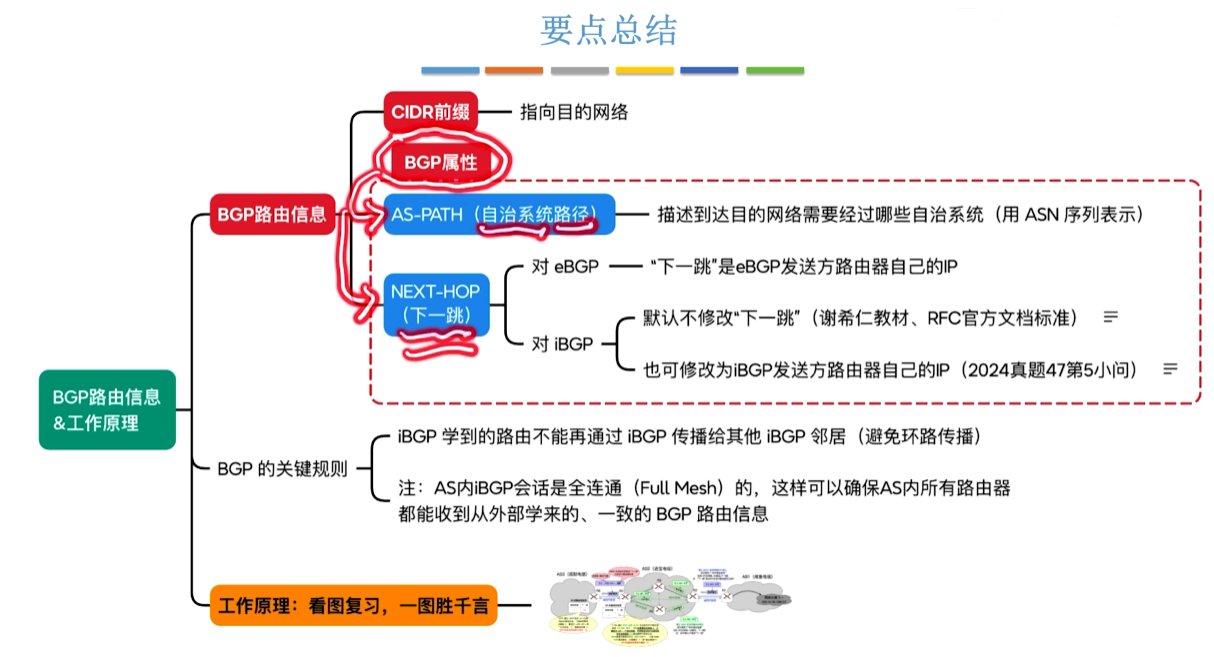
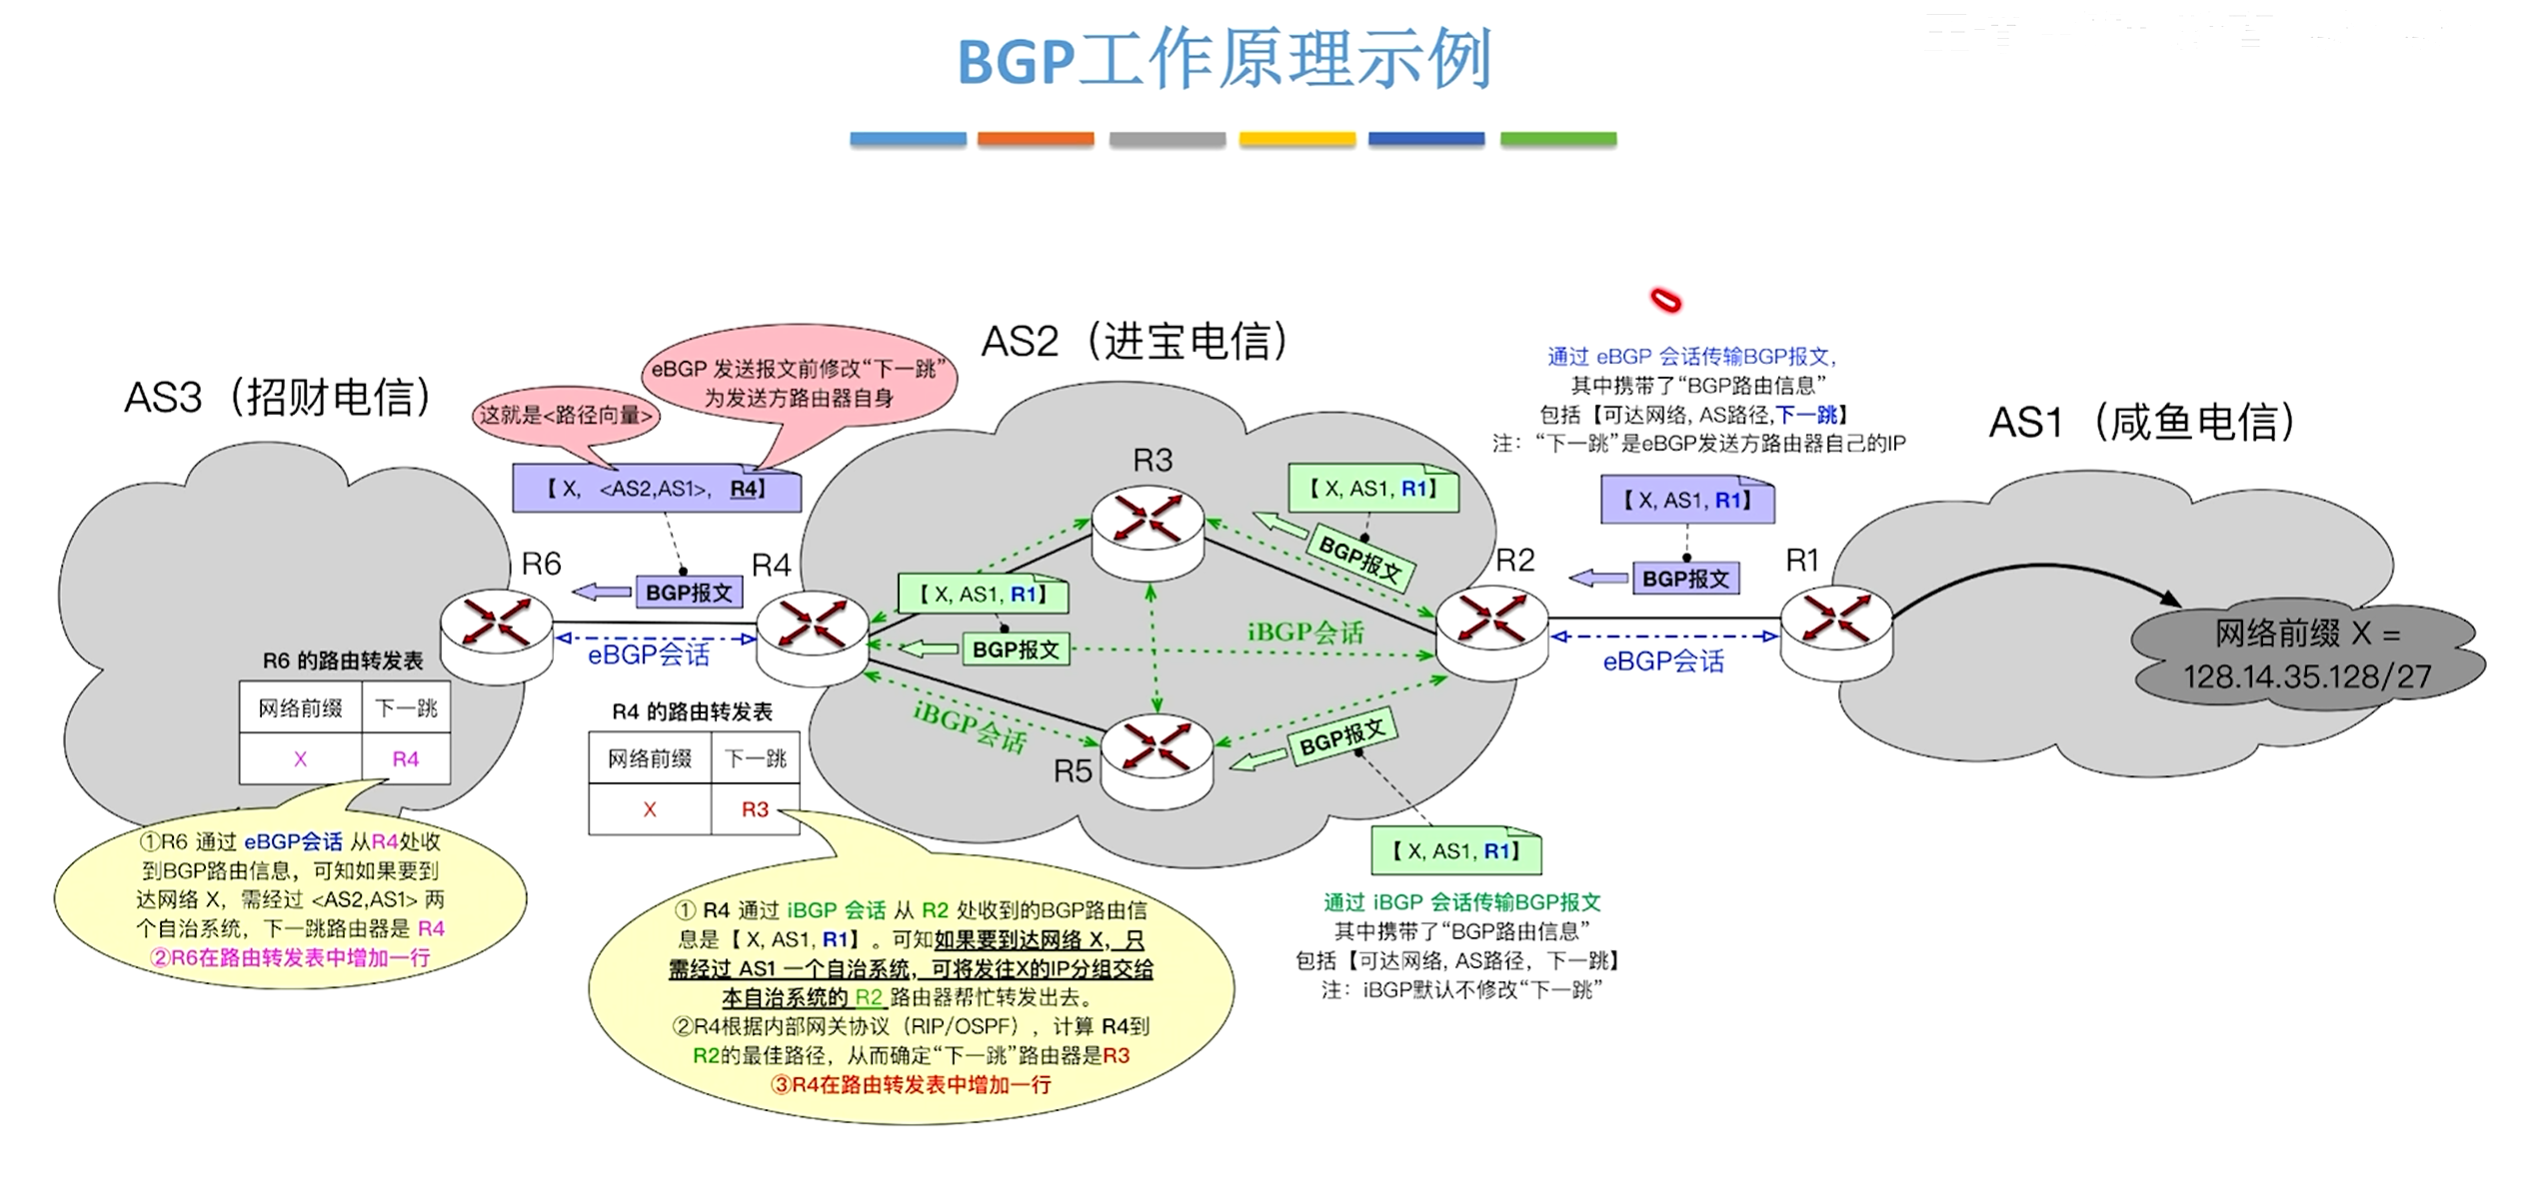
BGP路由信息,工作原理示例
BGP路由选择
对于==外部AS==的目的网络,如果有多条路可以走,怎么选择路线?
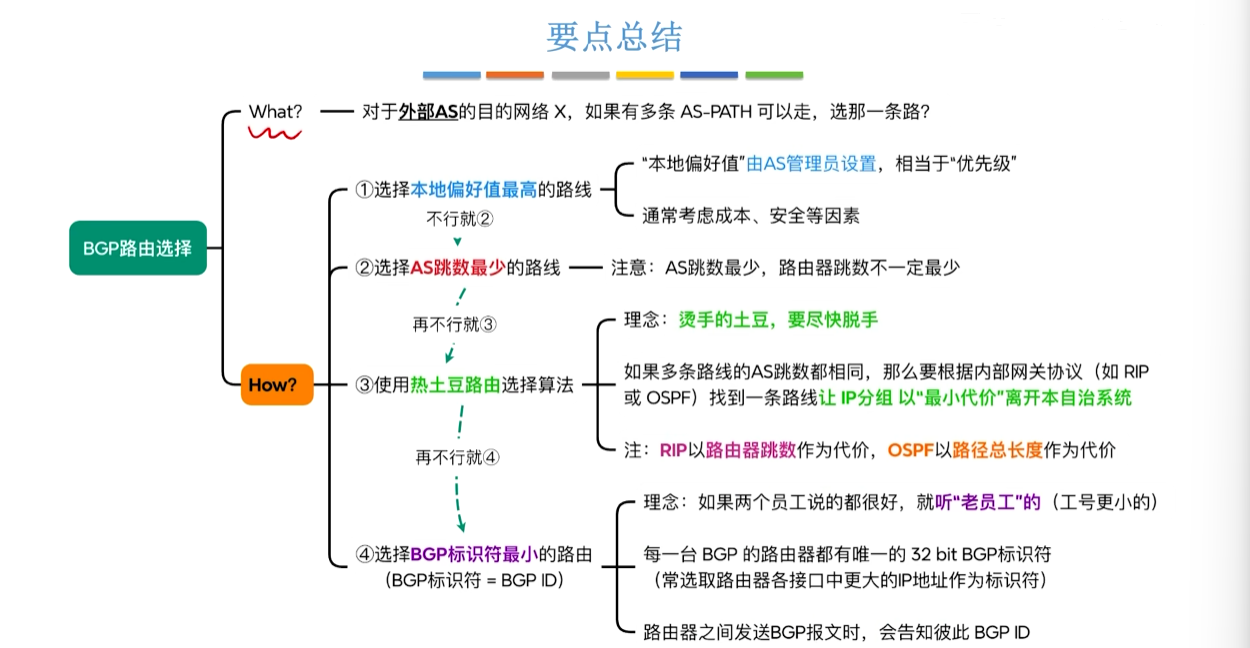
【按①②③④优先级考虑】
① 本地偏好值最高
- 相当于优先级(由AS管理员设置)
- 通常考虑成本,安全因素。
② AS跳数最少
- AS跳数最少,路由器跳数不一定最少。
③ 热土豆路线选择算法(最小代价)
想法:烫手的土豆,尽快脱手
让IP分组以“最小代价”离开本自治系统
RIP以路由器跳数为代价
OSPF以路径总长度为代价
④ BGP路由器标识符(即ID)最小
- 选IP更小的(老员工工号更小)
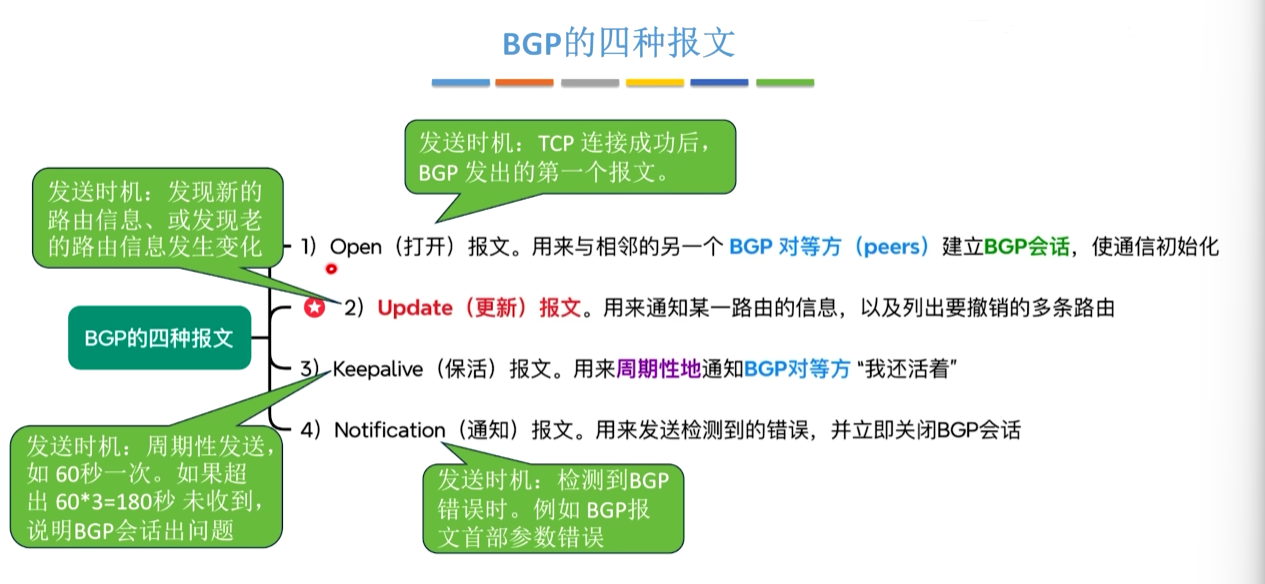
BGP四种报文
⑥ 补充
- RIP和BGP属于应用层,OSPF和ICMP属于网络层
4.5 IP多播
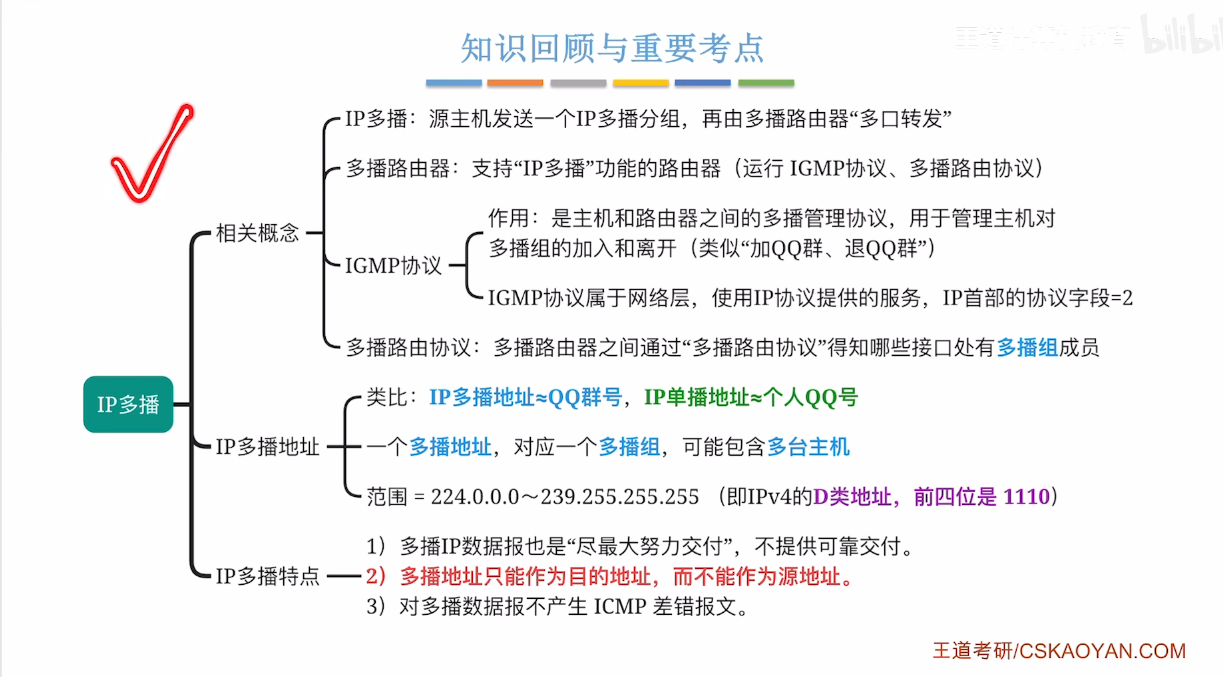
==IP多播地址是之前见过面的==
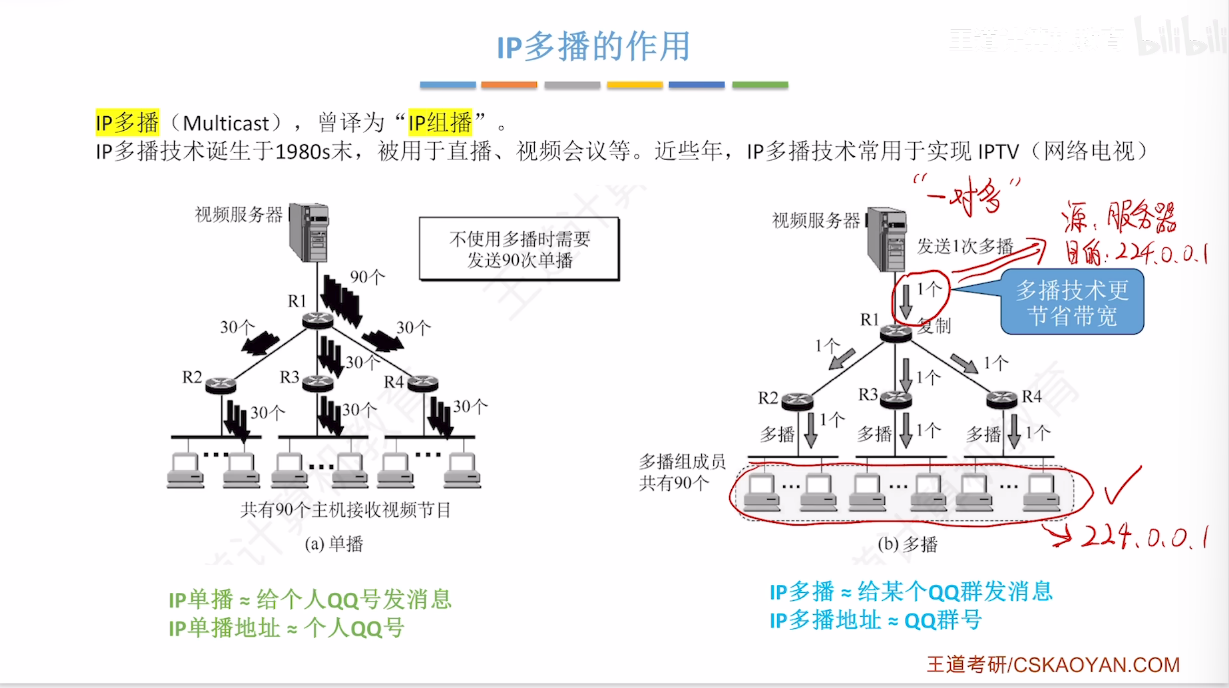
IP多播特别适合一对多的通信==(相当于给某个QQ群发信息,而不是发n次相同的给个人)==
==IGMP协议属于网络层==
多播IP数据报也是尽最大努力交付,不提供可靠交付。
==多播地址只能作为目的地址,不能作为源地址。==
对多播数据报不产生 ICMP差错报文(whenTTL=0时)
多播避免环路的办法:多播转发树。
以太网多播地址块的范围:01-00-5E-00-00-00~01-00-5E-7F-FF-FF
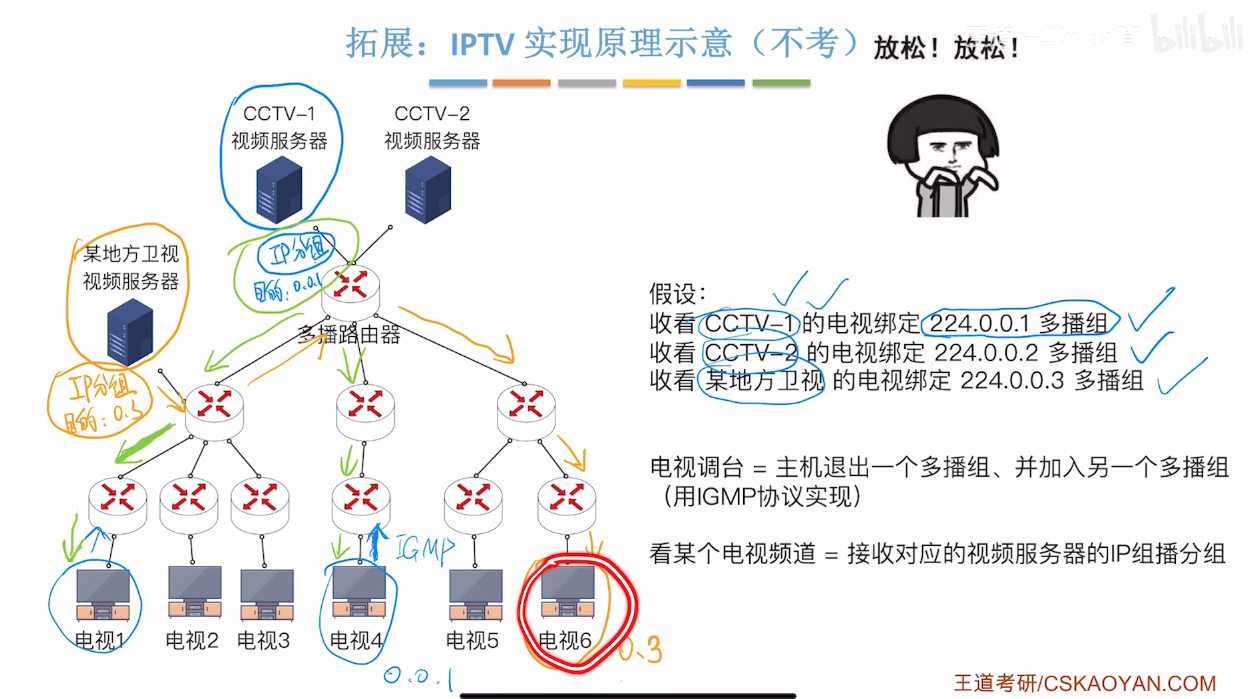
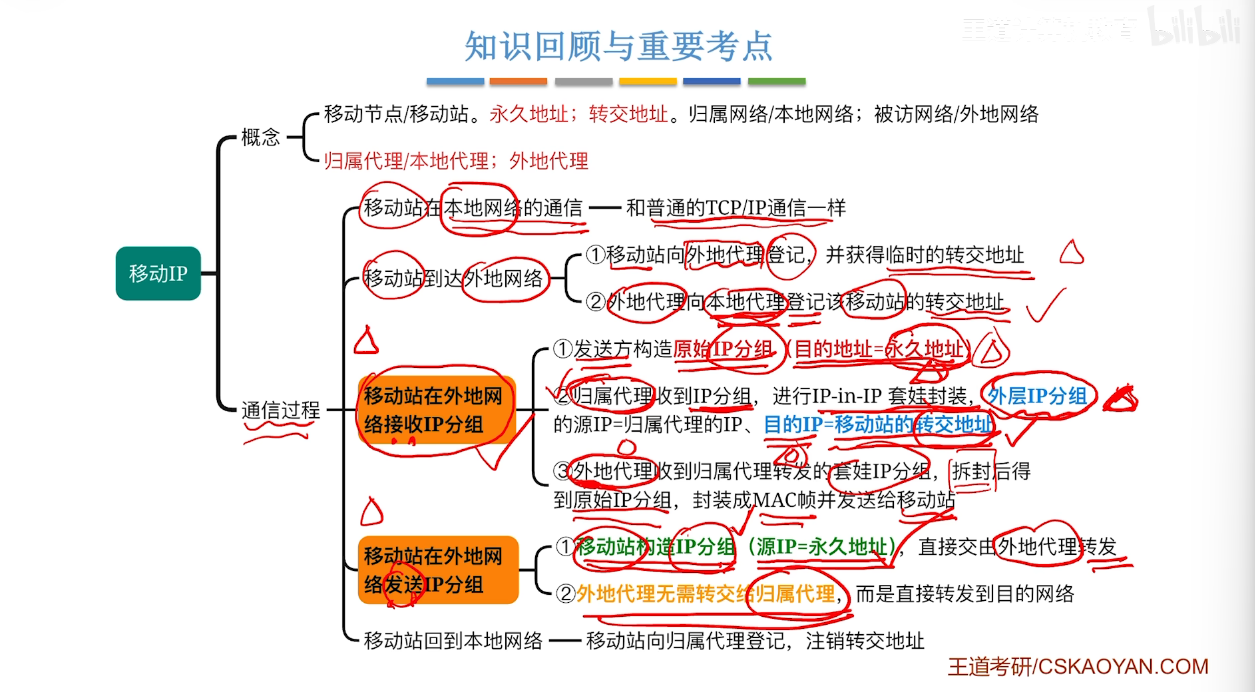
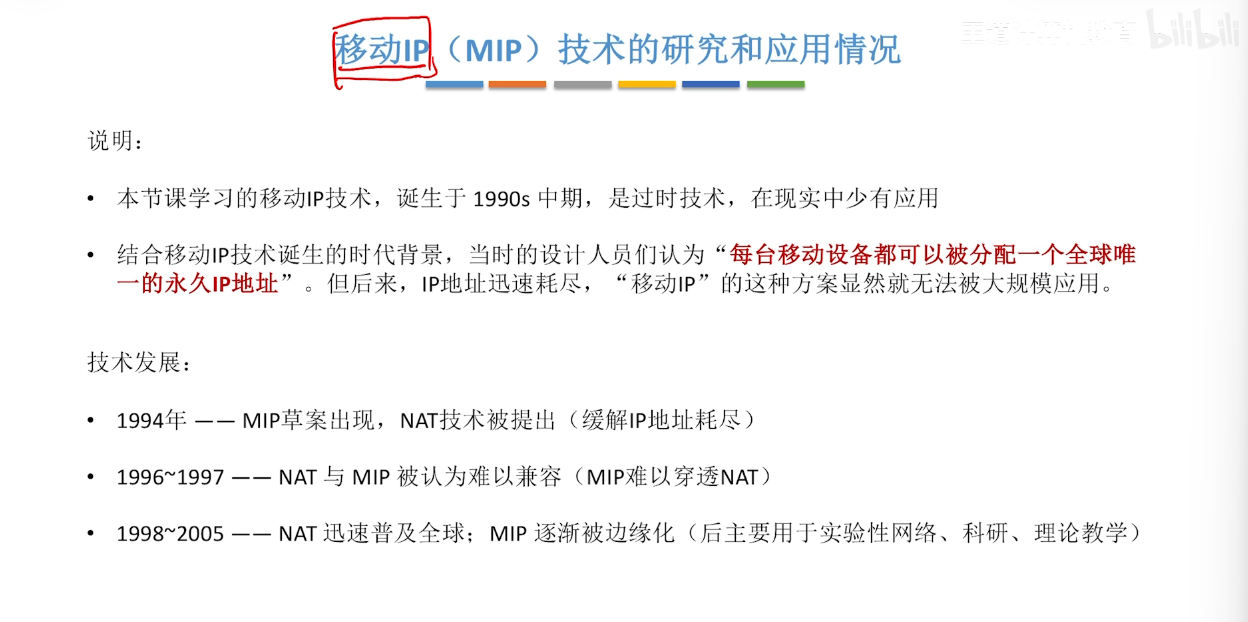
4.6 移动IP
移动IP技术要解决的问题是什么?
当移动设备的IP地址动态变化时,如何确保网络传输不受到影响?
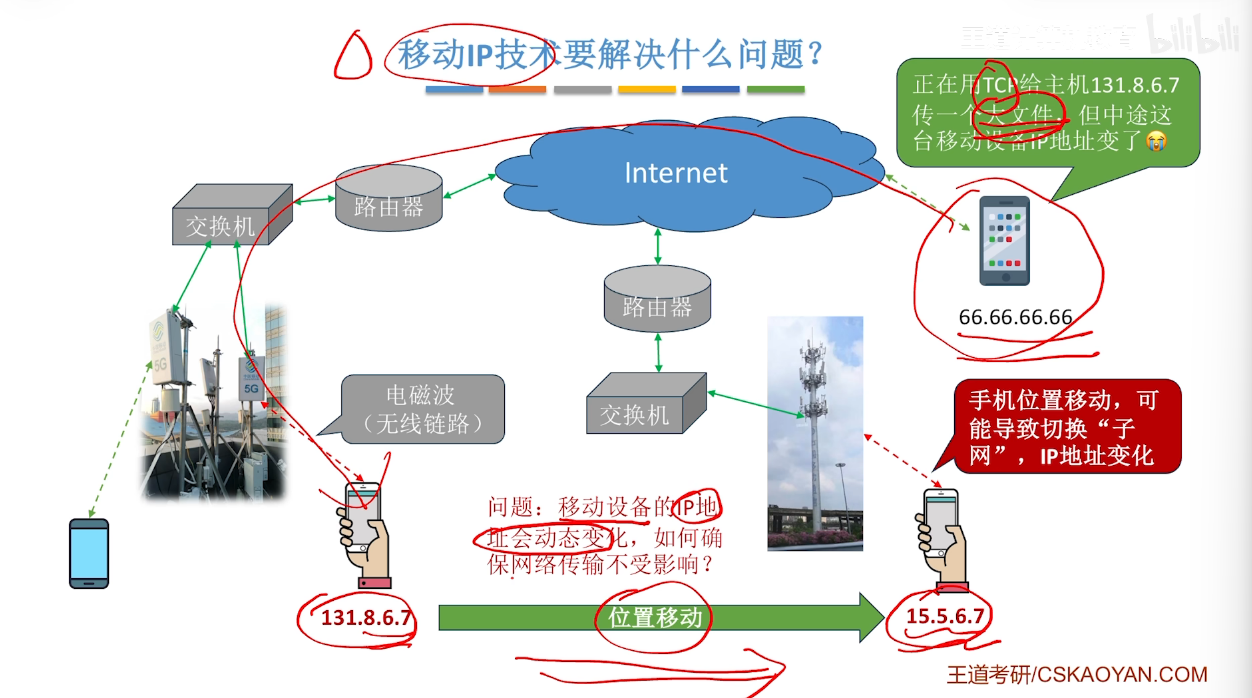
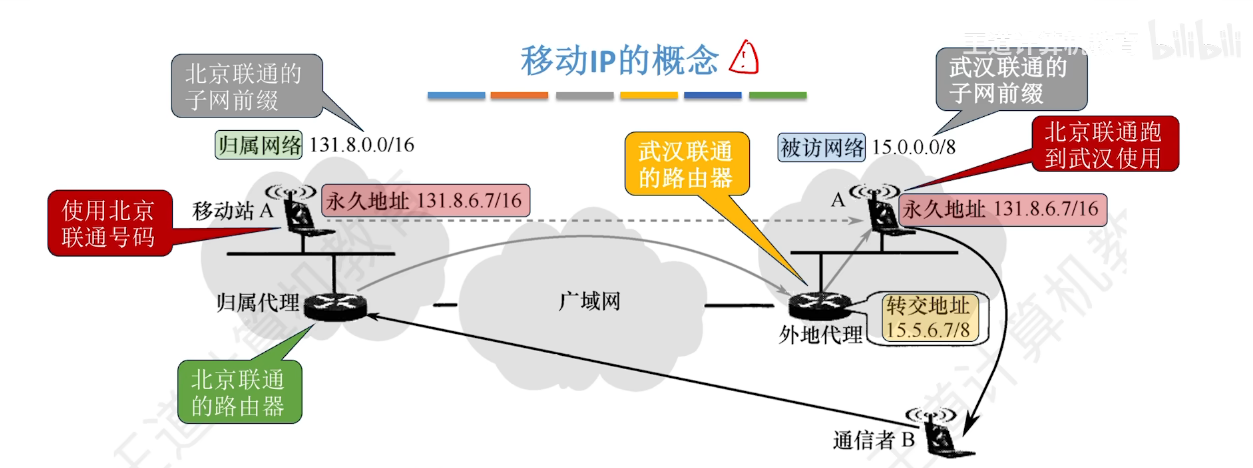
==移动站==(永久IP地址的移动主机,说人话==就是你的手机卡==)
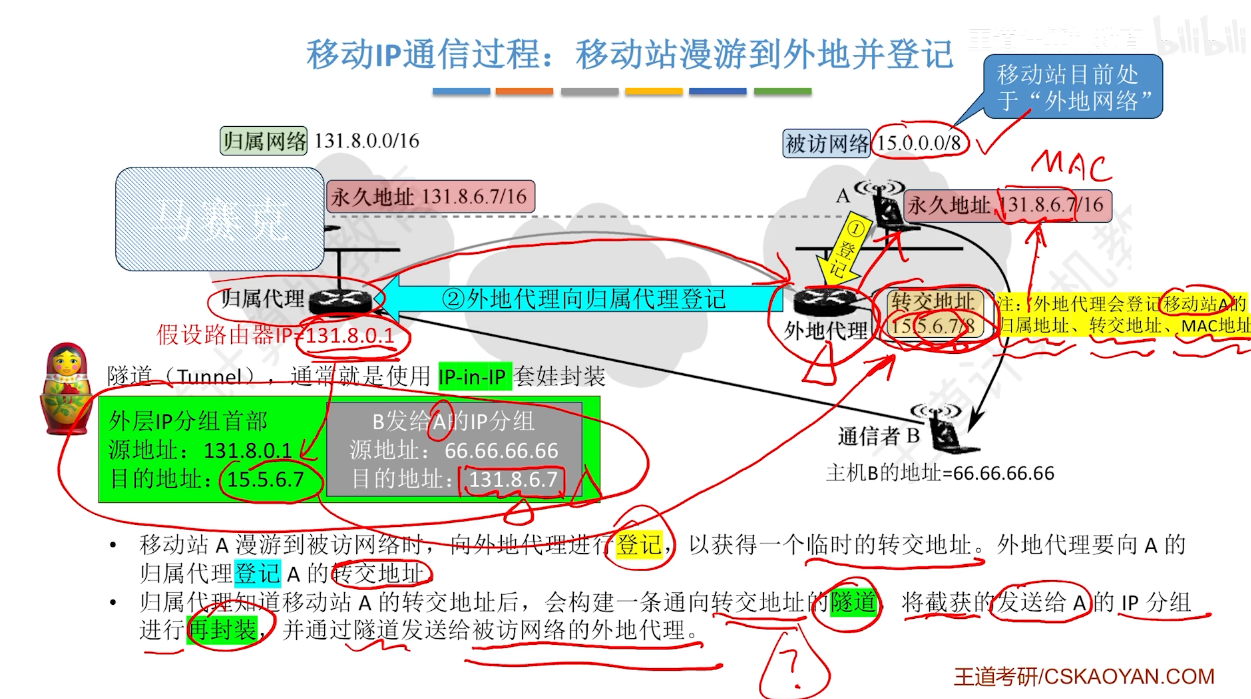
归属代理 / ==本地代理==:连接在归属网络上的路由器。负责代收数据并通过“隧道”转发给移动站的新位置。
==外地代理==:连接在被访网络(移动到另一个地点所接入的网络)上的路由器
==漫游==:一个插着北京电话卡的手机跑到外地去了
==永久地址==:和手机电话卡绑定的,全球唯一的,永久的IP地址
==转交地址==:手机漫游到外地网络时,被分配的临时IP地址。
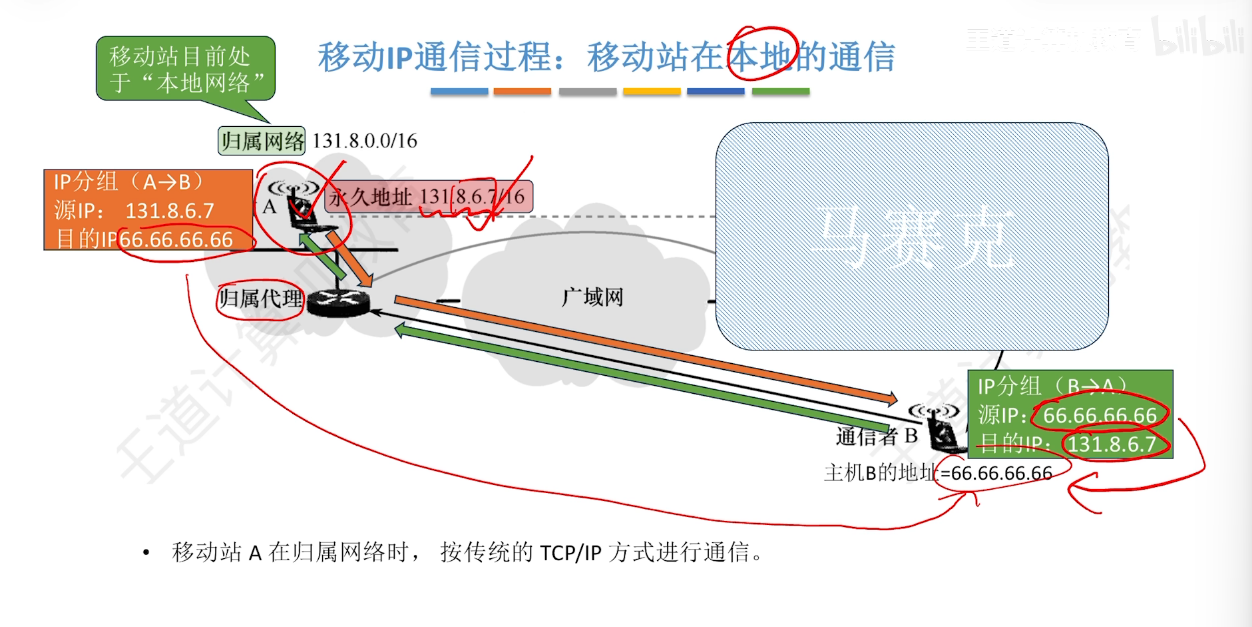
移动IP通信过程
① 移动站在本地的通信(跟普通的TCP/IP没有区别)
② 移动站==漫游==到外地并登记
③ 移动站在外地==接收==IP分组
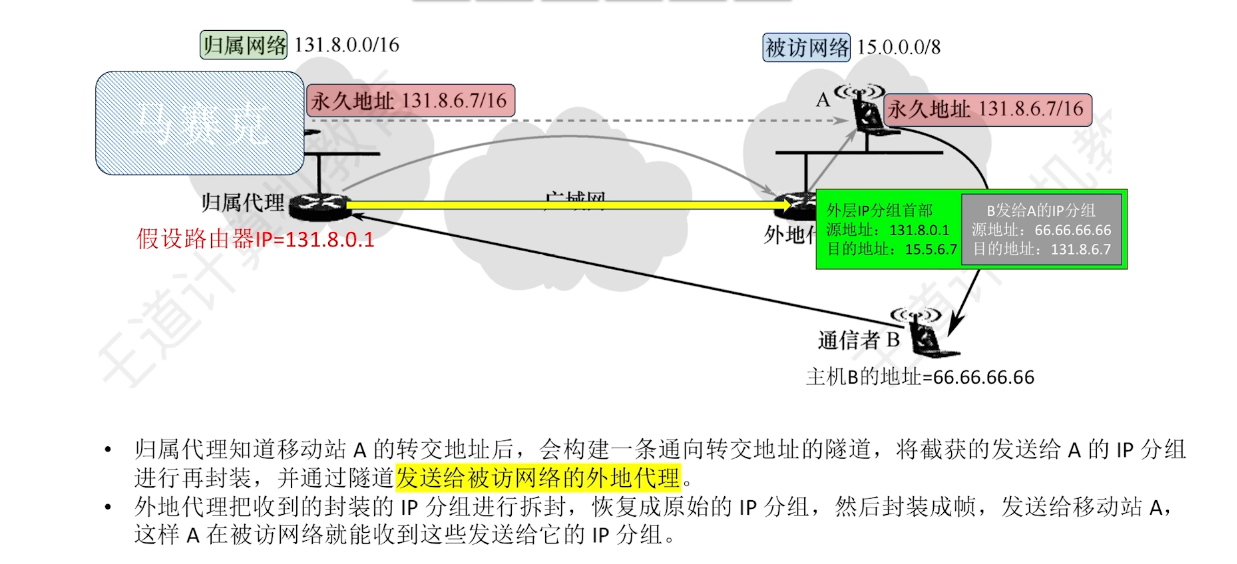
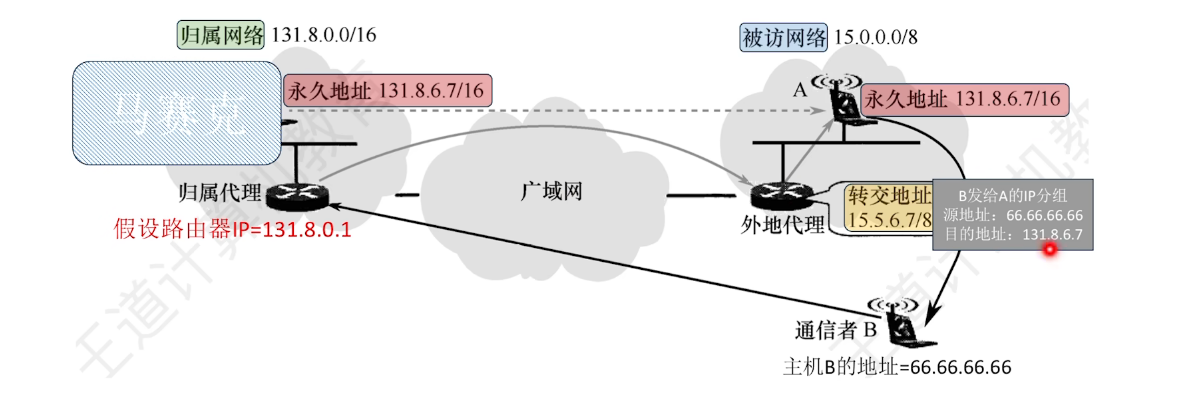
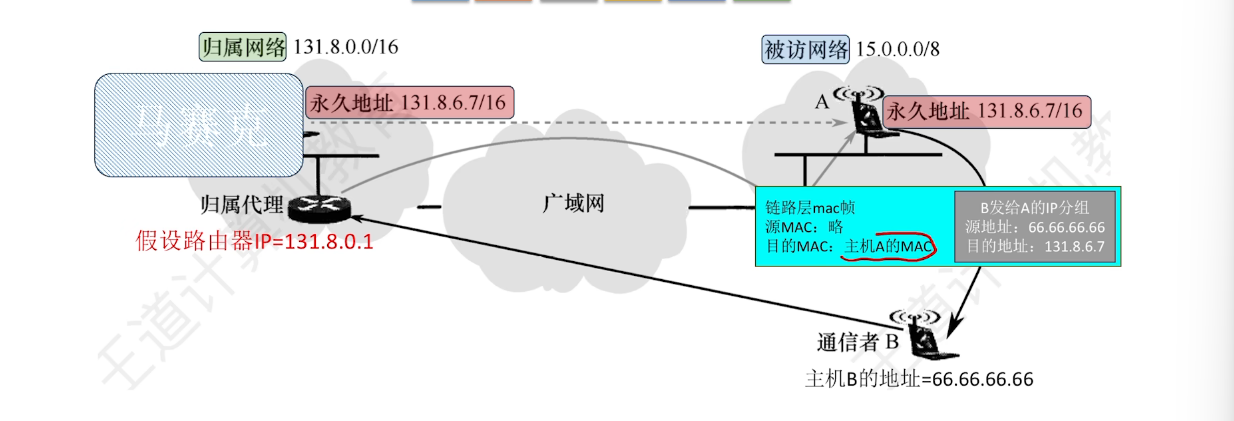
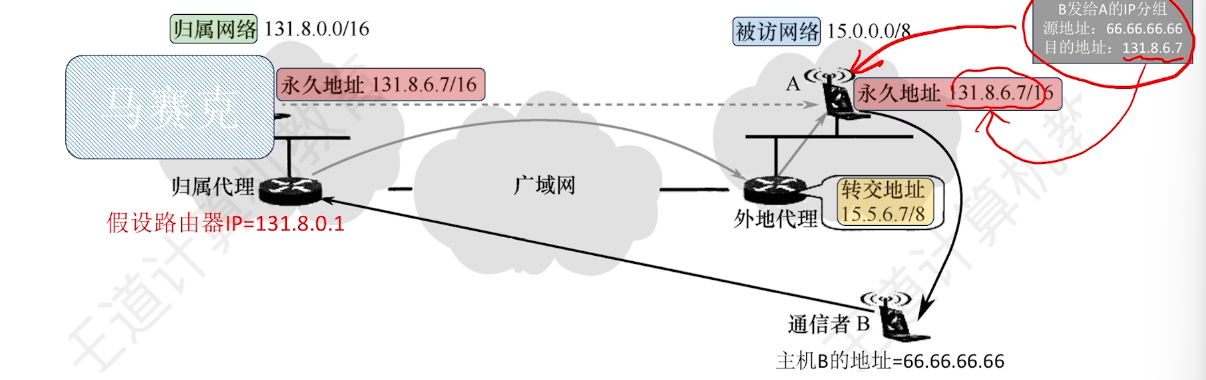
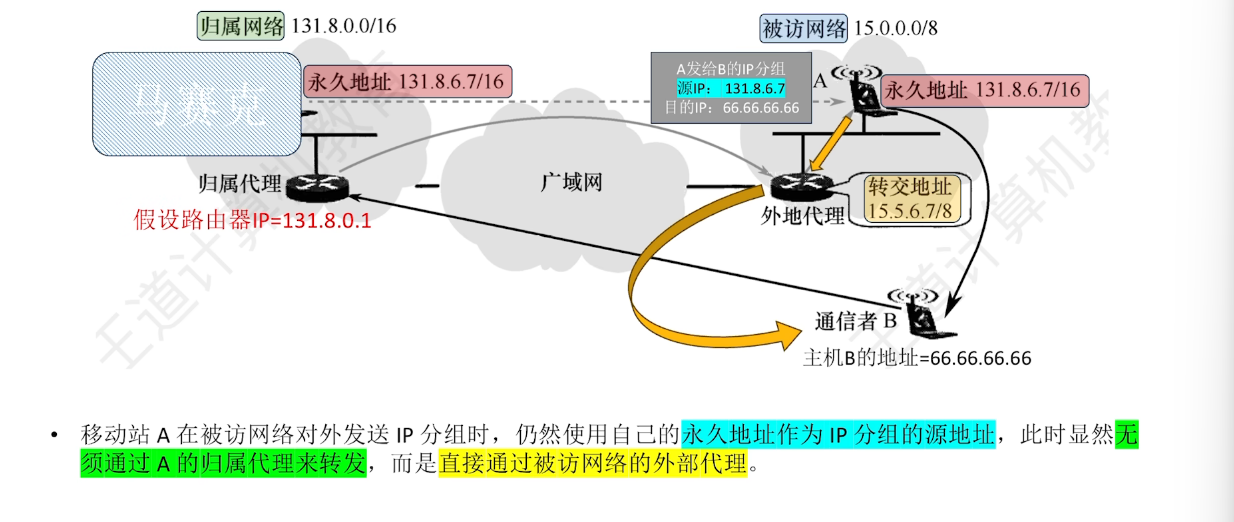
④ 移动站在外地==发送==IP分组(不需要经过归属代理的转发)
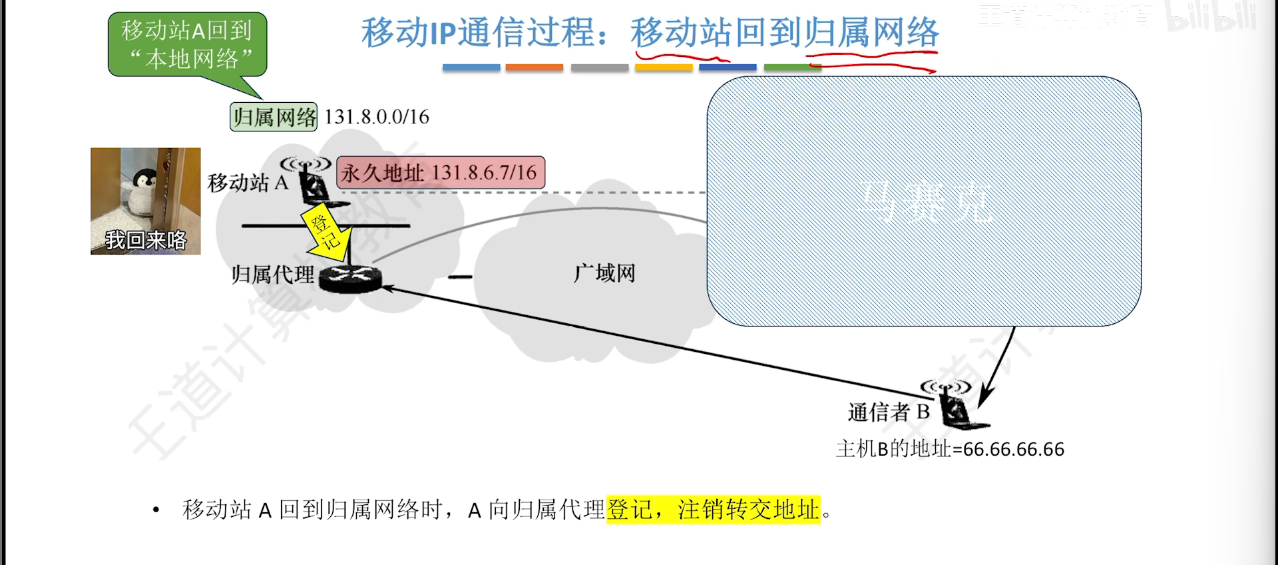
⑤ 移动站回到归属网络
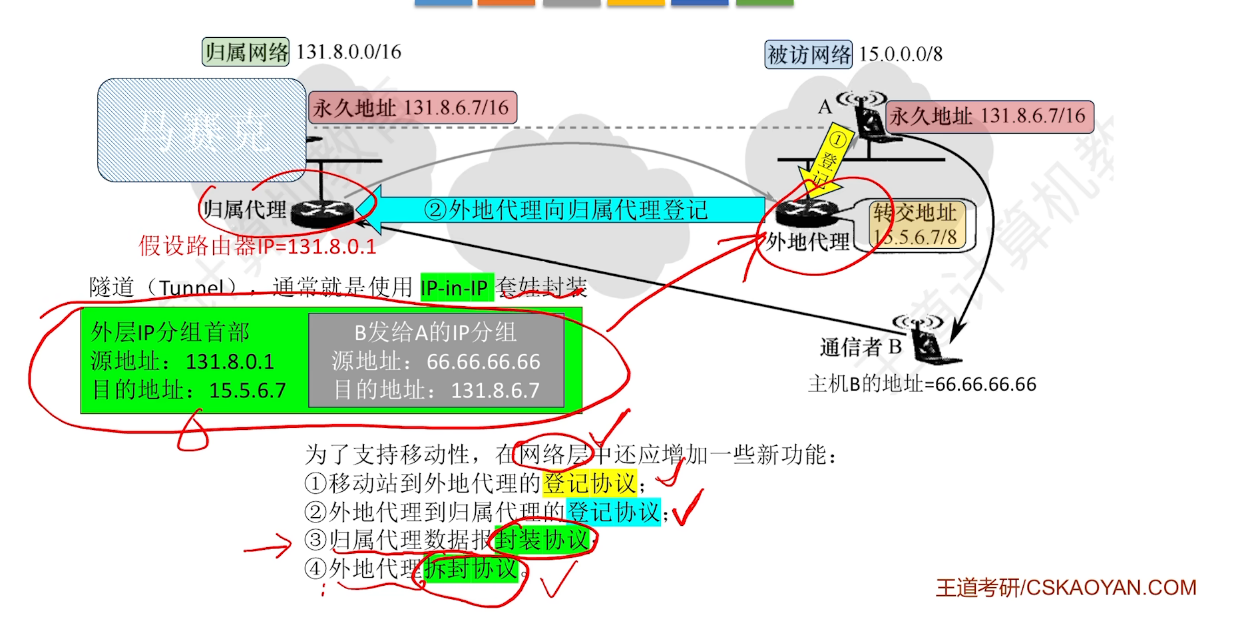
IP移动技术在网络层的一些补充
- 移动站到外地代理的登记协议
- 外地代理到归属代理的登记协议
- 归属代理数据报封装协议
- 外地代理拆分协议
Note:
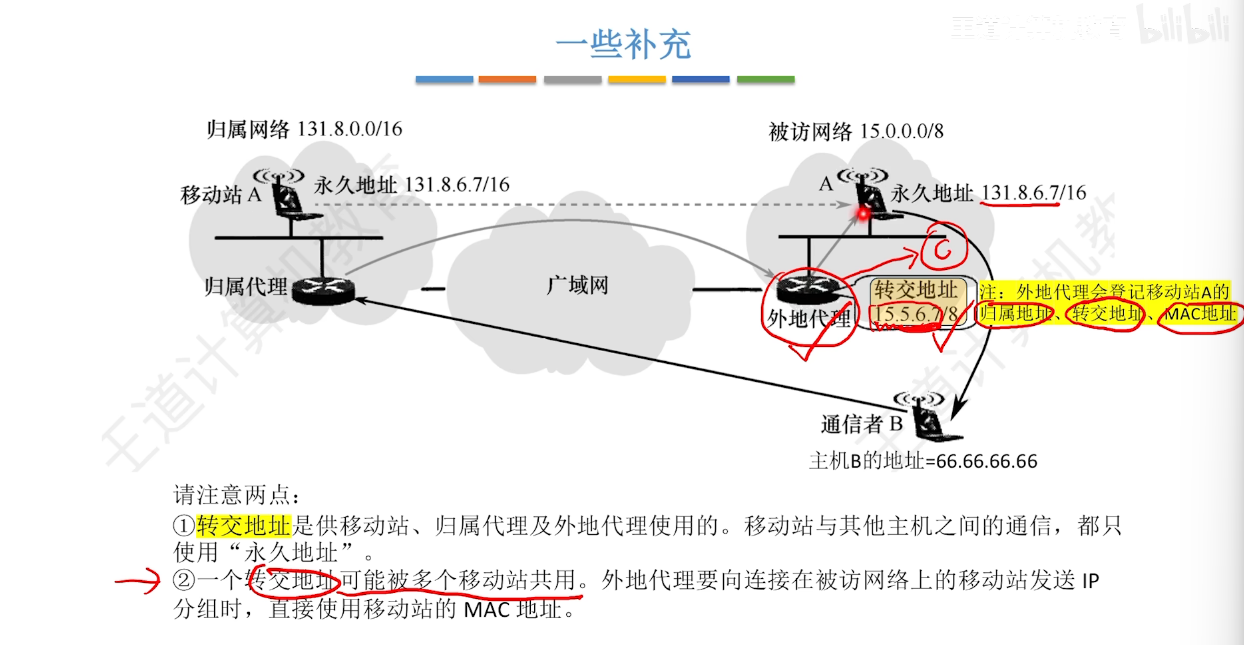
转交地址是供给移动站、归属代理和外地代理使用的。
而移动站和其他主机之间的通信,都只使用“永久地址”。
一个转交地址可能被多个移动站共用。
而外地代理要向连接在被访问网络上的移动站发送IP分组时,直接使用移动站的MAC地址。
回顾⭐
4.7 网络层设备
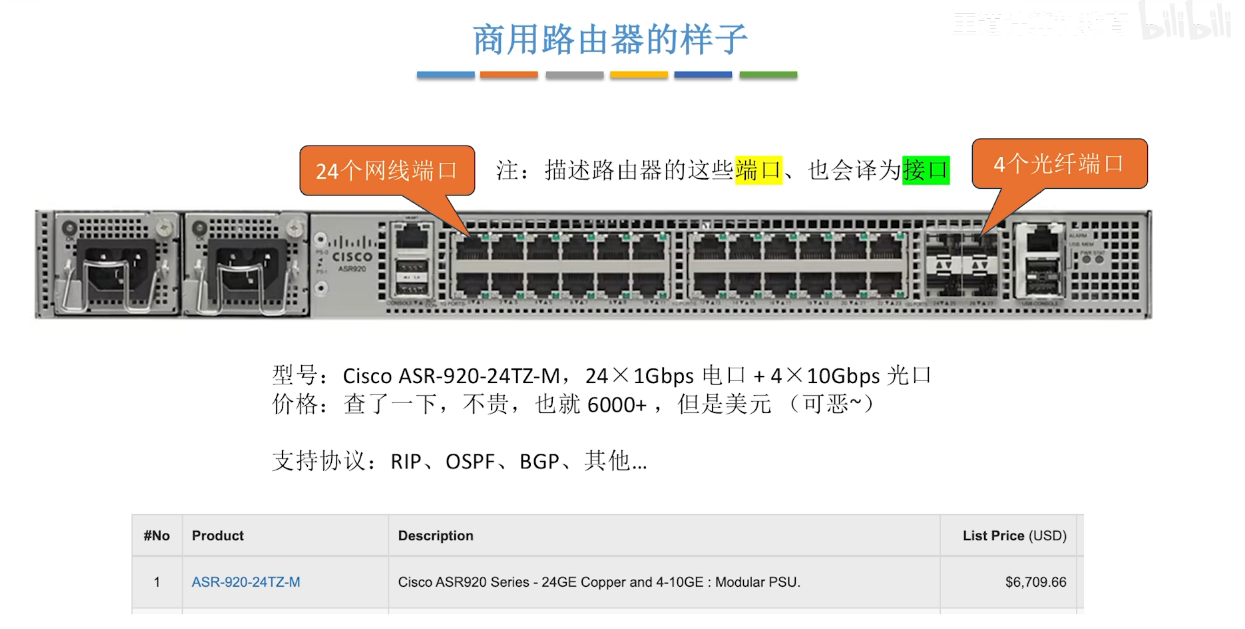
路由器的组成和功能
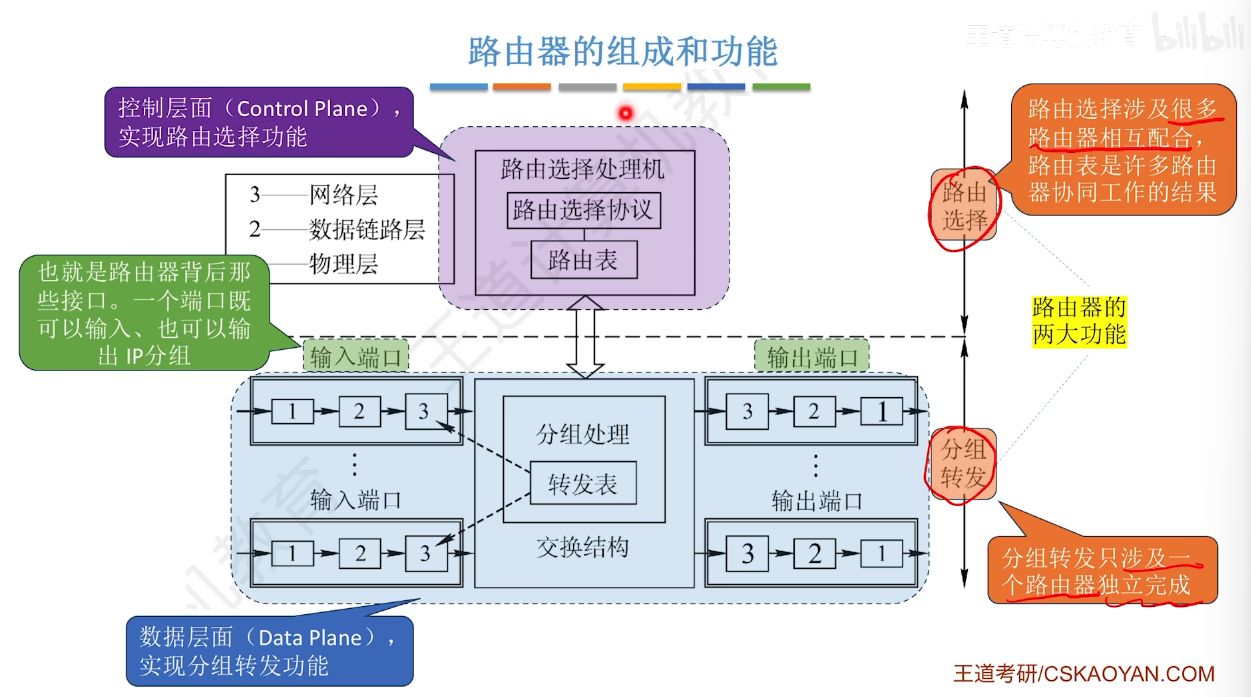
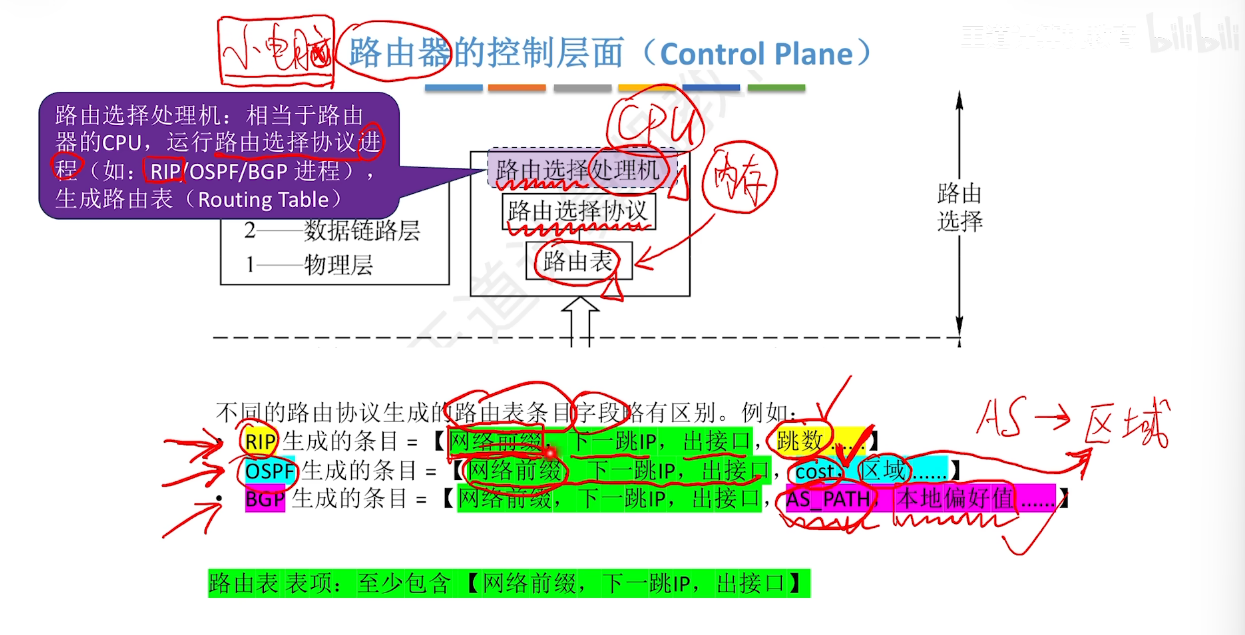
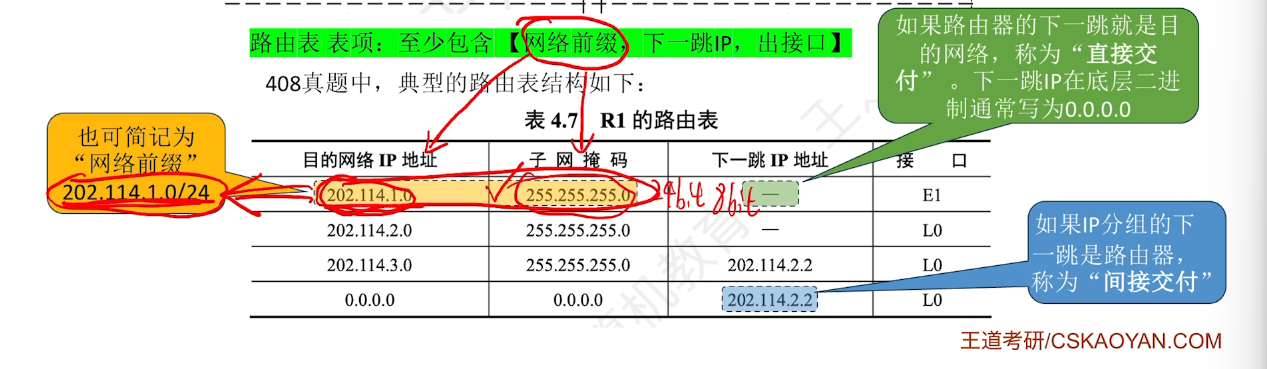
路由器的控制层面
路由器的数据层面
(转发表是由路由表精简得到的,不够除非特别说明,默认是一个东西)
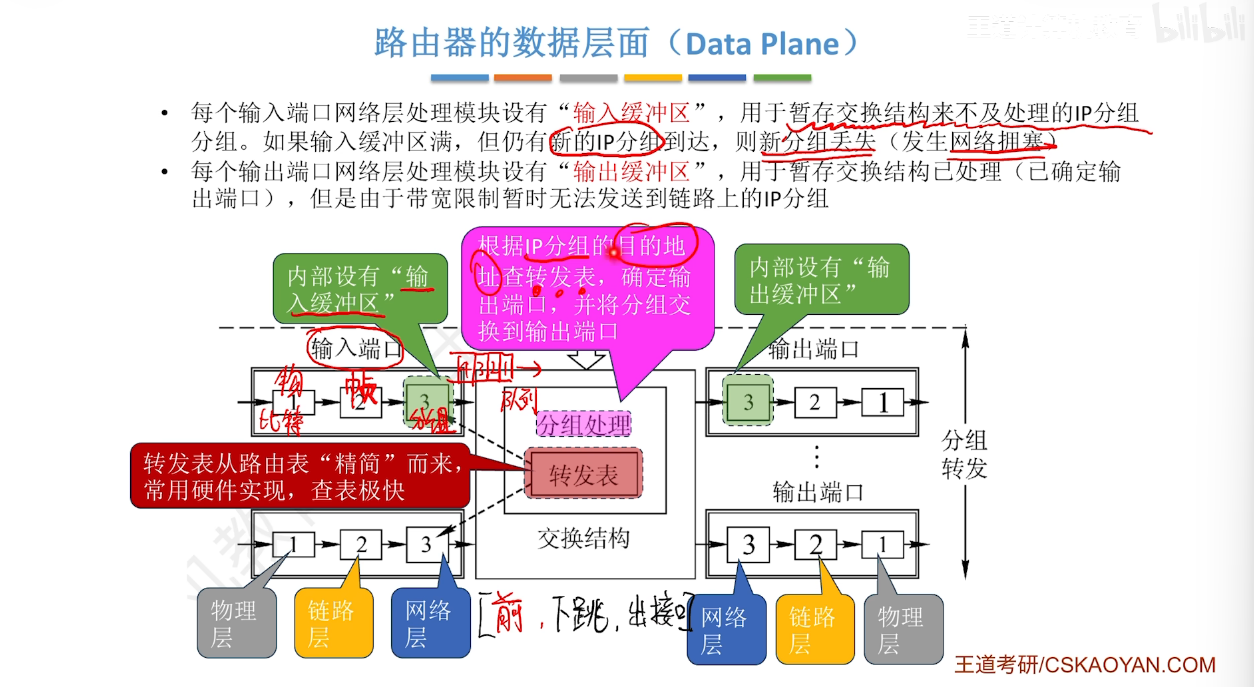
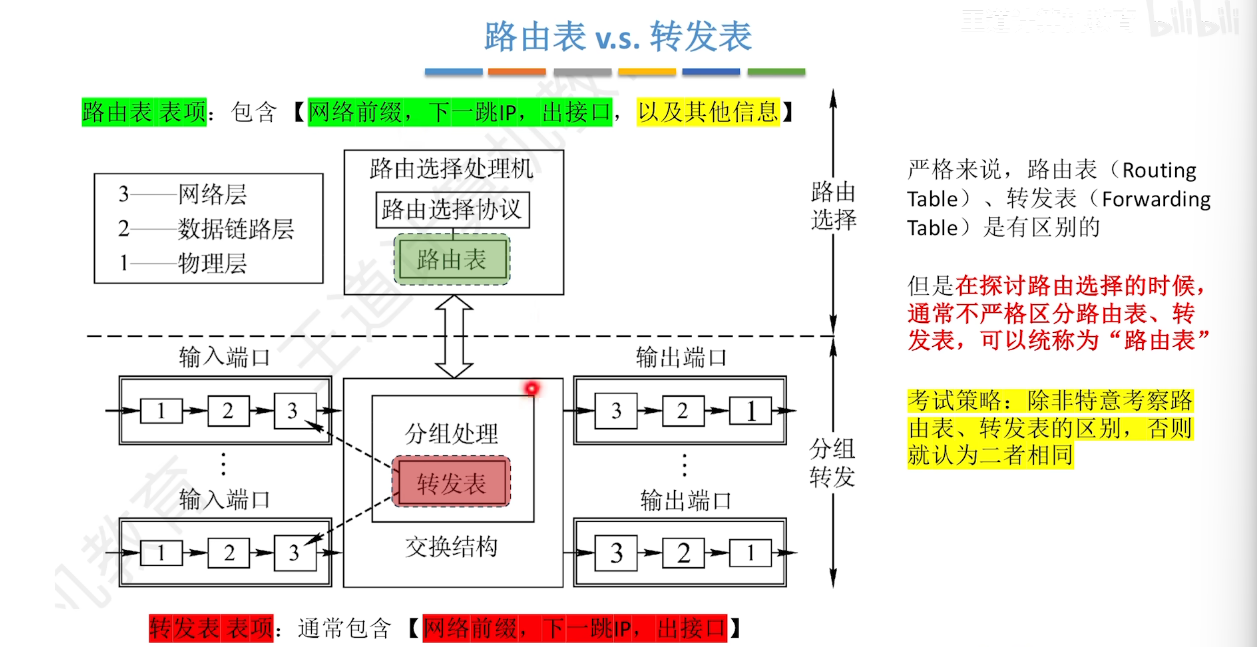
==网络拥塞==:来不及处理数据,太多了。
回顾
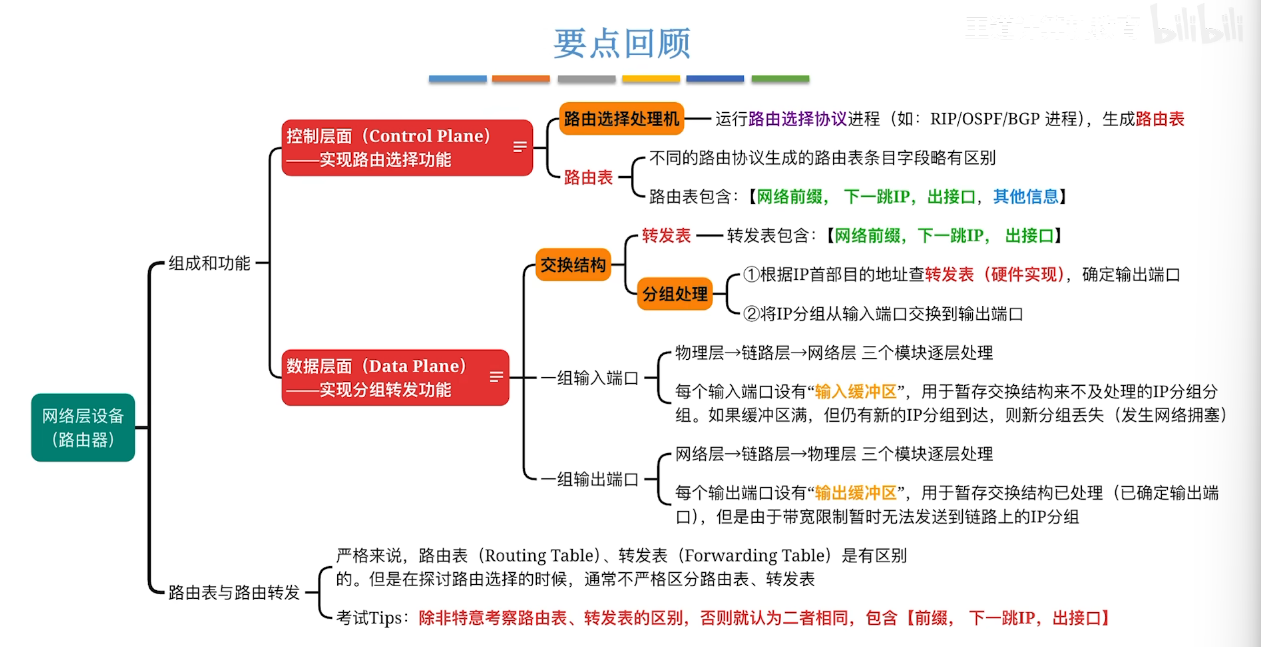
补充:
路由器具有比较大的传输时延(相比于局域网交换机,网桥,集线器)
==交换机== = 多端口的==网桥==
==路由器转发分组==如何确定转发端口:==通过接口标识符。==(不是目的网络地址,不是下一跳地址)
路由器对收到的IP分组首部进行差错检验,丢弃有差错的报文,==但不保证IP分组不丢失==